Бессерверный REST API «на коленке за 5 минут»
Привет! Сегодня продолжим разговор о возможностях, которые предоставляет нам Amazon Web Services и о том, как эти возможности использовать в решении прикладных задач.
На простом примере рассмотрим создание буквально за несколько минут собственного бессерверного автомасштабируемого REST API с разбором кейса — получения списка для ресурса.
Интересно? Тогда заходим под кат!

(Источник) [1]
Вместо вступления
Для разбора примера использовать какие-либо базы данных не будем, вместо этого нашим источником информации будет обычный текстовый файл на AWS S3.
- Итак, предположим, что на AWS S3 у нас есть текстовый файл с заголовками и некий процесс пишет в него информацию.
- Мы создадим облачный API, который по GET запросу с переданным параметром будет возвращать в виде ответа JSON коллекции.
- При этом, в зависимости от сложности задач и, как следствие, повышенных требований к вычислительной мощности ресурсов, не придется об этом заботиться, т.к. сервис полностью автомасштабируемый. А это означает, что не нужно никакого администрирования, выделения серверов и управления ими, просто загружаем свой код и запускаем его.
Архитектура разрабатываемой системы

Используемые компоненты Amazon Web Services:
- Amazon S3 [2] — объектное хранилище, которое позволяет хранить практически неограниченные объемы информации;
- AWS Identity and Access Management (IAM) [3] — сервис, предоставляющий возможности безопасного управления доступом к сервисам и ресурсам AWS. Используя IAM, можно создавать пользователей AWS и группы, управлять ими, а также использовать разрешения, чтобы предоставлять или запрещать доступ к ресурсам AWS;
- AWS Lambda [4] — сервис, позволяющий запускать код без резервирования и настройки серверов. Все вычислительные мощности автоматически масштабируются под каждый вызов. Плата взимается на основе количества запросов к функциям и их продолжительности, т.е. времени, в течение которого исполняется код.
Уровень бесплатного доступа (Free tier) предполагает 1 млн. запросов в месяц бесплатно и 400К Гб-с. Поддерживаемые языки: Node.js, Java, C#, Go, Python
. Будем использовать Python:
- Библиотека boto3 [5] — это AWS SDK для Python, позволяющий взаимодействовать с различными сервисами Amazon;
- Amazon API Gateway [6] — полностью управляемый сервис для разработчиков, предназначенный для создания, публикации, обслуживания, мониторинга и обеспечения безопасности API в любых масштабах. Помимо возможности использования нескольких версий одного и того же API (stages) с целью отладки, доработки и тестирования, сервис позволяет создавать бессерверные REST API при помощи AWS Lambda. Lambda выполняет код в высокодоступной вычислительной инфраструктуре, устраняя необходимость в распределении и масштабировании серверов, а также в управлении ими.
Уровень бесплатного доступа (Free tier) для HTTP/REST API включает один миллион вызовов API в месяц в течение 12 месяцев
Подготовка данных
В качестве источника информации для формирования ответов по REST-запросу GET будет применяться текстовый файл с табуляцией в качестве разделителей полей. Информация сейчас не имеет большого значения для данного примера, но для дальнейшего использования API я выгрузил из торгового терминала Quik таблицу текущих торгов по облигациям, номинированным в российских рублях, сохранил в файле bonds.txt и поместил этот файл в специально созданный бакет AWS S3.
Примерный вид полученной информации такой, как показано на рисунке ниже:
 [7]
Далее, необходимо написать функцию, которая будет считывать информацию из файла bonds.txt, парсить ее и выдавать по запросу. С этим прекрасно справится AWS Lambda. Но сначала необходимо будет создать новую роль, которая позволит созданной Lambda-функции считывать информацию из бакета, расположенного в AWS S3.
Создание роли для AWS Lambda
- В консоли управления AWS переходим в сервис AWS IAM и далее в закладку «Роли», нажимаем на кнопку «Create role»;
Добавление новой Роли

- Роль, которую мы сейчас создадим, будет использоваться сервисом AWS Lambda для чтения информации с AWS S3. Поэтому, на следующем шаге выбираем «Select type of trusted» --> «Aws Service» и «Choose the service that will use this role» --> «Lambda» и нажимаем на кнопку «Next: Permissions»
Роль для сервиса Lambda

- Теперь необходимо задать политики доступа к ресурсам AWS, которые будут использоваться во вновь созданной роли. Т.к. список политик достаточно внушителен, используя фильтр для политик укажем к нем «S3». В результате чего получим отфильтрованный список применительно к сервису S3. Отметим чекбокс напротив политики «AmazonS3ReadOnlyAccess» и нажмем на кнопку «Next: Tags».
Политики для Роли

- Шаг (Add tags (optional)) – необязательный, но при желании можно указать теги для Роли. Мы этого делать не будем и перейдем к следующему шагу – Preview. Здесь необходимо задать наименование роли – «ForLambdaS3-ReadOnly», добавить описание и нажать на кнопку «Create role».
Наименование Роли

Все, роль создана и мы можем ее использовать в дальнейшей работе.
Создание новой функции в AWS Lambda
- Переходим в сервис AWS Lambda и нажимаем на кнопку «Create function»:
Создание функции

Заполняем все поля как показано на скриншоте ниже:
- Name – «getAllBondsList»;
- Runtime – «Python 3.6»
- Role – «Choose an existing role»
- Existing role – здесь выбираем ту роль, которую мы создали выше — ForLambdaS3-ReadOnly
Наименование и выбор роли
- Остается только написать код функции и проверить ее работоспособность на различных тестовых запусках. Необходимо отметить, что основным компонентом любой Lambda-функции (если используете Python) является библиотека boto3:
import boto3
s3 = boto3.resource('s3')
bucket = s3.Bucket('your-s3-bucket')
obj = bucket.Object(key = 'bonds.txt')
response = obj.get()
Основная идея нашей Python-функции следующая:
- Открыть файл bonds.txt;
- Считать заголовки столбцов;
- Разбить записи постранично (10 коллекций в нашем случае);
- Выбрать нужную страницу;
- Смаппить название столбцов и записей;
- Выдать результат в виде коллекций.
Не будем уделять много времени самому коду функции и технической реализации, здесь все довольно просто и полный код доступен в моем GitHub [8].
        for i in range(0, len(lines_proc)):
            d = dict((u''.join(key), u''.join(value)) for (key, value)
                in zip(headers, lines_proc[i].split("t")))

            response_body.append(d)

        return {
            'statusCode': 200,
            'page' : num_page,
            'body': response_body
        }
Вставим код (или напишем свой :) ) в блок «Function code» и нажимаем на кнопку «Save» в правом верхнем углу экрана.
Вставка кода
- Создание тестовых событий. После вставки кода, функция доступна для запуска и тестирования. Нажмем на кнопку «Test» и создадим несколько тестовых событий: запуск функции lambda_handler с разными параметрами. А именно:
- Запуск функции с параметром 'page': '100';
- Запуск функции с параметром 'page': '1000000';
- Запуск функции с параметром 'page': 'bla-bla-bla';
- Запуск функции без параметра 'page'.
Тестовое событие Page100
Запуск созданной функции с передачей тестового события page == 100. Как видно из скриншота ниже, функция успешно отработала, возвратила статус 200 (OK), а также набор коллекций, который соответствуют сотой странице разделенных данных при помощи пагинации.
Запуск тестового события Page100
Для чистоты эксперимента запустим другое тестовое событие – «PageBlaBlaBla». В этом случае функция возвращает результат с кодом 415 и комментарий, что необходимо проверить корректность переданных параметров:
Тестовое событие PageBlaBlaBla Запуск события PageBlaBlaBla

Создание API
После того как протестированы все остальные кейсы и есть понимание того, что Lambda-функция работает так, как мы этого ожидаем, приступаем к созданию API. Создадим точку доступа к созданной выше Lambda-функции и дополнительно установим защиту от нежелательных запусков при помощи API Key.
- Переходим в сервис AWS API Gateway. Нажимаем на кнопку «Create API», задаем имя API – «getAllBondsList»
Создание нового API

- Добавляем метод GET вновь созданному API. Для этого выбираем Actions --> Create method, в появившемся раскрывающемся списке выбираем метод GET и нажимаем на галочку
Новый метод GET

Далее, укажем что в методе GET будет использоваться наша Lambda-функция getAllBondsList. Выбираем ее и нажимаем на кнопку Save.
Привязка Lambda-функции
- Проведем деплой нашего API, получив тем самым URL-адрес для вызова API.
Нажимаем Actions --> Deploy API, и далее, Deployment stage --> New StageСуществует возможность развертывать API в разные стадии и называть эти стадии можно как угодно (например, DEV/QA/PROD). Мы развернем сразу в PROD.
Deploy API
После деплоя будет доступна ссылка на запуск вновь созданного API. Перейдем по этому URL в адресной строке браузера (или выполним команду curl в терминале) — получим вызов API и, как следствие, запуск Lambda-функции:
URL-адрес API
Для демонстрации работы AWS API Gateway я буду использовать приложение Postman [9]. В нем можно достаточно комфортно отлаживать и тестировать работу API.
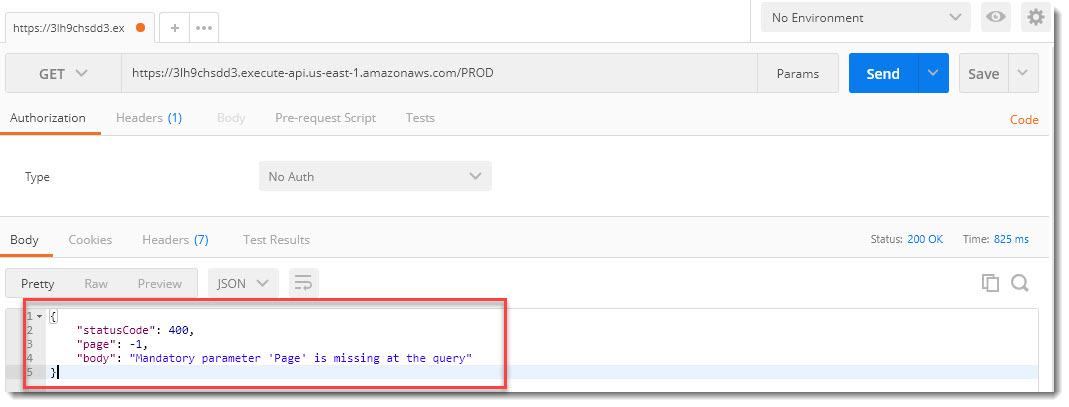
Первое тестирование APIКопируем URL со стадии PROD в Postman и посылаем запрос GET нашему API: [10]
Кажется, что-то пошло не так… запрос GET вернул JSON-ответ с кодом 400 и подсказкой, что не задан параметр Page в запросе вызова API. Добавим поддержку параметров запроса к API.
- Поддержка переданных параметров в запросе.
Возвращаемся в настройки GET запроса и переходим в шаг Method Request.Method Request
В детальных настройках Method Request необходимо раскрыть блок URL Query String Parameters и добавить новый параметр «page» и сделать его обязательным (Required):
Добавление параметра
Возвращаемся на страницу Method Execution и переходим в Integration Request. Спускаемся в самый низ страницы и раскрываем блок «Mapping Templates». Выбираем «When there are no templates defined (recommended)», в поле Content-Type следует указать application/json и нажать на галочку. Прокручиваем страницу ниже и в текстовом поле вводим код, как указано на картинке ниже. После этого нажимаем на кнопку Save.
Method Request
Предварительно сделав деплой API, проверяем еще раз, но уже с передачей параметра «page»:
 [11]
Это успех! Теперь запрос отработал успешно и вернул нам коллекции, содержащиеся на десятой странице! Ура!
- Осталось только защитить наш API от нежелательных посягательств извне.
Для этого необходимо настроить работу API таким образом, чтобы при обращении он требовал секретный ключ, который передается в header.
Перейдем в API Keys и создадим новую связку API ключей — KeyForBondsList.
API Keys
После того как API Key будет успешно создан, необходимо указать, что API getAllBondsList должен требовать обязательной передачи API ключа в заголовке запроса. И привязать конкретный ключ KeyForBondsList к API getAllBondsList.
Перейдем опять в настройки GET запроса в Method Request и сменим параметр API Key Required с false на true. Теперь API будет требовать передачи API Key.
API Key Required
Переходим в Usage Plan и создадим новый план использования API.
Во-первых, дадим ему имя и описание, а во-вторых, здесь же можно задать лимиты на запуск API, например, не чаще чем один запуск в секунду и т.д.
Создание Usage Plan
Нажимаем на Next и переходим к следующей странице, где необходимо связать стадии API с планом пользования:
Привязка стадии к Usage Plan
На следующей странице привязываем API Keys к плану использования API. Нажимаем на кнопку Add API Keys to Usage Plan и находим по названию созданные API Keys на предыдущих шагах:
Привязка API Keys к Usage Plan
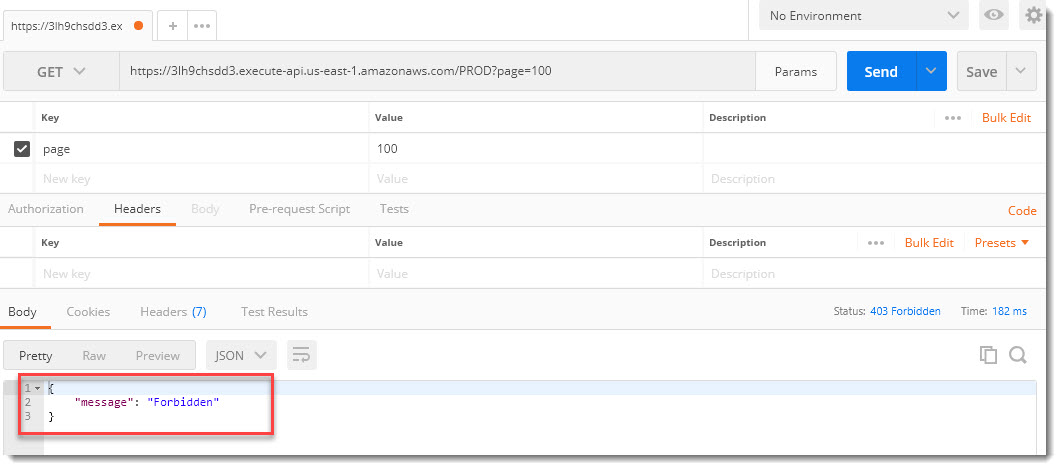
Выполнив деплой и запустив еще раз вызов GET нашего API мы получаем ответ: «Forbidden», т.к. в заголовке запроса отсутствует API Key:
 [12]
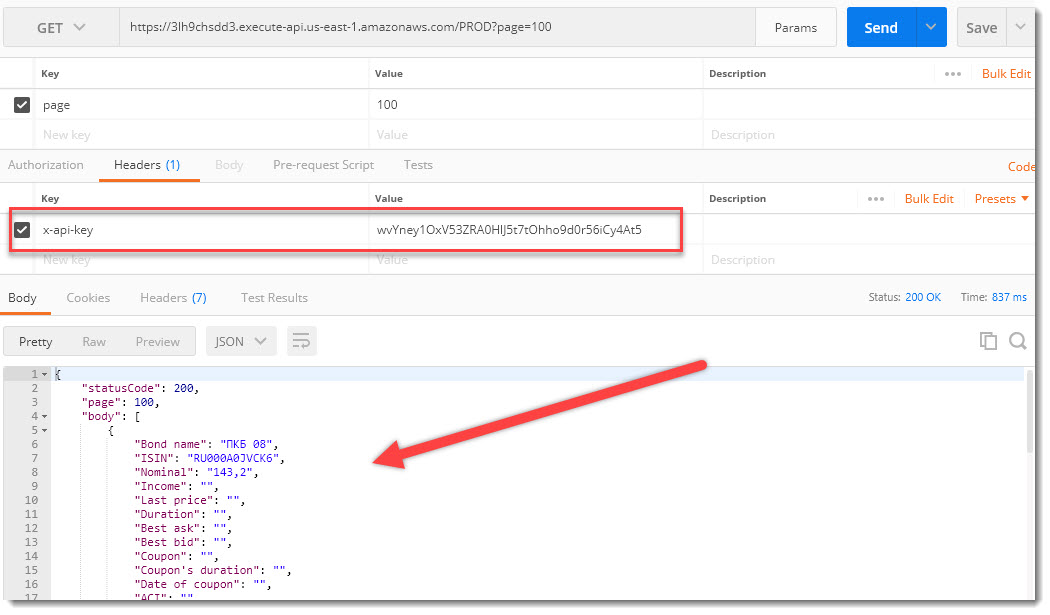
Попробуем добавить его, скопировав из API Keys --> KeyForBondsList --> API key --> Show и вставим в соответствующий раздел запроса с ключом «x-api-key»:
 [13]
Все получилось! На этот раз запрос возвращает данные без каких-либо проблем, вызов API безопасный и защищен от злоумышленников секретным ключом API Key.

Выводы и итоги
В этой статье мы рассмотрели создание бессерверного автомасштабируемого REST API с применением облачных сервисов Amazon. Статья получилась не самой маленькой по объему, но я старался максимально подробно объяснить весь процесс создания API и скомпоновать всю последовательность действий.
Уверен, что после одного-двух повторений описанных в статье действий, Вы сможете поднимать свои облачные API за 5 минут и даже быстрее.
Благодаря своей относительной простоте, дешевизне и мощности сервис AWS API Gateway раскрывает перед разработчиками широкие возможности для использования в работе и в коммерческих проектах. Для закрепления теоретического материала данной статьи, попробуйте оформить бесплатную годовую подписку Amazon Web Services и проделать самостоятельно вышеуказанные шаги по созданию REST API.
По любым вопросам и предложениям, с удовольствием готов пообщаться. Жду Ваших комментариев к статье и желаю успехов!
Автор: I_v_g
Источник [14]
Сайт-источник PVSM.RU: https://www.pvsm.ru
Путь до страницы источника: https://www.pvsm.ru/python/304614
Ссылки в тексте:
[1] (Источник): https://www.Vecteezy.com
[2] Amazon S3: https://docs.aws.amazon.com/en_us/AmazonS3/latest/dev/Welcome.html
[3] AWS Identity and Access Management (IAM): https://docs.aws.amazon.com/en_us/IAM/latest/UserGuide/introduction.html
[4] AWS Lambda: https://docs.aws.amazon.com/en_us/lambda/latest/dg/welcome.html
[5] boto3: https://boto3.amazonaws.com/v1/documentation/api/latest/index.html
[6] Amazon API Gateway: https://docs.aws.amazon.com/en_us/apigateway/latest/developerguide/welcome.html
[7] Image: https://hsto.org/webt/ua/yl/na/uaylnacmex2xuts2gnqstudoxii.jpeg
[8] GitHub: https://github.com/igorgorbenko/awsGetAllBonds
[9] Postman: https://www.getpostman.com/
[10] Image: https://habrastorage.org/webt/bo/ku/3x/boku3xlj9kkoknm0wfnax1ninqg.jpeg
[11] Image: https://habrastorage.org/webt/s5/-3/v_/s5-3v_kqnx5k3drotwwhw4mltf4.jpeg
[12] Image: https://habrastorage.org/webt/oy/z9/39/oyz939fbfo9e6g-xpbujygkhj3o.jpeg
[13] Image: https://habrastorage.org/webt/vc/ml/l5/vcmll5c2bbyazujggy7orazylbm.jpeg
[14] Источник: https://habr.com/post/435180/?utm_campaign=435180
Нажмите здесь для печати.