
Платформа массовых email-рассылок, десяток крупных почтовых хостеров на том конце и рассылки на сотни тысяч адресов каждая. Принимают почту все по-своему — свой темп, свой размер пачки, своя реакция на временный отказ, свои представления о том, как быстро новому домену-отправителю позволено набирать обороты, — так что рассылка на миллион адресов одним потоком физически не едет: она сразу разваливается на несколько групп отправки, по одной на принимающую сторону, и дальше каждая живёт своей жизнью.
Очереди в Horizon описывают один раз и складывают в конфиг. Объявляете супервизора, перечисляете очереди, которые он обслуживает, говорите, сколько процессов держать и как их раскладывать, — на этом настройка заканчивается:
'sending' => [
    'connection' => 'redis',
    'queue'      => ['campaign', 'bounces', 'mail'],
    'balance'    => 'simple',
    'processes'  => 1,
    'tries'      => 3,
    'sleep'      => 1,
    'timeout'    => 0,
    'memory'     => 1024,
],
Подавляющему большинству проектов этого хватает с запасом: очередей конечное число, известны они заранее и меняются вместе с кодом. Работало и у нас — долго и предсказуемо, ровно до того дня, когда активных рассылок стало две.
Дальше выяснилось, что очередь нужна на каждую группу отправки, то есть на сущность, которую пользователь заводит когда ему вздумается, уже после выкатки. Такого Horizon не умеет.
Или всё-таки умеет?
Одна очередь на всех
Очередь в Redis — обычный список, воркер берёт с головы, так что рассылка на 800k адресов, заехавшая первой, занимает этот список целиком: всё, что положили следом, поедет тогда, когда закончится она, и срочная рассылка на 3k адресов уходит в хвост огромнейшей очереди ждать свои несколько часов.
Обычно это лечат приоритетами: воркер с --queue=mail-urgent,mail сначала разбирает срочную очередь и только потом обычную. Приоритеты работают, когда классов работы конечное число и они известны заранее. Изолировать же надо рассылку, которую оператор завёл 5 минут назад, от рассылки, которую другой оператор завёл час назад, — а таких классов ровно столько, сколько сегодня было операторов.
Пауза, которая ничего не останавливает
Останавливать рассылки приходится поштучно, и поводов хватает: у клиента кончились деньги, в шаблоне нашлась опечатка, принимающая сторона начала отбивать письма и надо переждать часок, пока репутация домена не поехала совсем. Horizon умеет останавливать супервизоры целиком, то есть все рассылки разом, что в такой ситуации помогает, ну… примерно никак.
Первое решение жило на уровне приложения: флаг в Redis, который джоба смотрит перед работой.
public function handle(): void
{
    if ($this->group->isPaused()) {
        $this->release(self::RETRY_AFTER);

        return;
    }

    $this->send();
}
Письма после этого действительно перестают уходить, так что формально всё честно, — вот только воркеры продолжают разбирать очередь: джоба поднимается из Redis, десериализуется, читает флаг, уезжает обратно с задержкой — и так 800 000 раз по кругу. День сурка в отдельно взятом кластере: память занята, воркеры жужжат, процессор сервера отапливает дата-центр, а соседние рассылки, которые ни в чём не виноваты, едут медленнее чем хотелось бы ровно потому, что кто-то где-то нажал на паузу.
А нельзя просто нарезать очередей в конфиге?
Ответ «можно» тут честный ровно наполовину. В конфиге появляются 16 очередей mail-1…mail-16, по супервизору на каждую, рассылки раскладываются по ним по кругу, и первое время всё выглядит решённым: изоляция есть, пауза стала настоящей, потому что horizon:pause-supervisor mail-7 останавливает воркеры, а не гоняет их вхолостую.
А потом выясняется, что 16 очередей — это либо потолок в 16 одновременных рассылок, либо две рассылки в одной очереди, то есть ровно то, от чего уходили. Воркеры к тому же разложены по очередям, а не по работе, так что 15 супервизоров держат свои минимальные процессы над пустотой, пока шестнадцатый захлёбывается. А главное, config/horizon.php читается на деплое — тогда как рассылку оператор заводит в четверг днём, через 2 недели после того, как выкатывались в последний раз.
Проблема, впрочем, не в том, сколько очередей нарезать, а в том, что конфиг описывает известное на момент сборки, тогда как рассылка живёт в рантайме: её заводит пользователь, у неё свой жизненный цикл, стартует по событию, через час её могут отменить, а могут и не отменить, а просто подзадержать после запуска, скажем, на пару дней. Единица, которую надо изолировать, появляется и исчезает между деплоями, а единственный предусмотренный способ рассказать о ней Horizon — отредактировать конфиг и раскатать всё заново.
Значит, создавать супервизоры надо в рантайме, и ровно на этом месте документация Horizon заканчивается: в ней есть конфиг, есть horizon:pause-supervisor, есть балансировка, а про то, как поднять супервизор, которого в конфиге нет, не сказано ничего. С тех пор появились сторонние пакеты, которые это умеют, и обзор на них ждёт в конце статьи, — а вот официально документированного способа как не было, так и нет.
На момент написания статьи — осенью 2021-го — я не нашёл ни одного даже частично подходящего решения. Гугл не выдавал ничего: ни статьи, ни ответа на Stack Overflow, ни пакетов, только кучку вопросов на подобную тему на Laracasts, притом даже без вариантов того, как это решить, так что пришлось изобретать собственный велосипед путём вычитки исходников самого Horizon.
Обзор на существующие на текущий момент решения смотри в конце статьи.
Что на самом деле делает php artisan horizon
Мастер-процесс, который поднимается этой командой, не обрабатывает джобы и не запускает воркеров. Всё, что он делает на старте, — читает config/horizon.php, разворачивает окружение в набор SupervisorOptions и на каждый кладёт команду в собственную очередь команд в Redis:
// LaravelHorizonProvisioningPlan
protected function add(SupervisorOptions $options)
{
    app(HorizonCommandQueue::class)->push(
        MasterSupervisor::commandQueueFor($this->master),
        AddSupervisor::class,
        $options->toArray()
    );
}
А потом крутит цикл, и первым делом на каждой итерации вычитывает эту очередь:
// LaravelHorizonMasterSupervisor
protected function processPendingCommands()
{
    foreach (app(HorizonCommandQueue::class)->pending($this->commandQueue()) as $command) {
        app($command->command)->process($this, $command->options);
    }
}
AddSupervisor::process() собирает из опций командную строку, запускает процесс php artisan horizon:supervisor … и кладёт его в список наблюдаемых; уже этот процесс поднимает воркеров и раздаёт им джобы.
Из этих двух кусков растёт всё остальное. Конфиг оказывается не источником истины, а всего лишь штукой, которая при старте производит команды AddSupervisor, и отдавать эти команды может кто угодно — очередь команд лежит в Redis и ничьей собственностью не является. У каждого супервизора есть такая же своя очередь, названная его полным именем, и через неё он принимает Pause, ContinueWorking, Restart и Terminate:
// LaravelHorizonSupervisor
protected function processPendingCommands()
{
    foreach (app(HorizonCommandQueue::class)->pending($this->name) as $command) {
        app($command->command)->process($this, $command->options);
    }
}
Полное имя супервизора складывается как <имя master>:<имя супервизора>, а очередь команд самого master’а зовётся master:<имя master>, так что для управления супервизорами снаружи хватает двух строк с именами и одного push().
С именем master’а связана тонкость, на которую натыкаешься не сразу:
// LaravelHorizonMasterSupervisor
public static function name()
{
    static $token;

    if (! $token) {
        $token = Str::random(4);
    }

    return static::basename() . '-' . $token;
}
Имя хоста плюс 4 случайных символа, сгенерированных один раз на процесс. Значит, при каждом перезапуске Horizon имя master’а другое, а вместе с ним другими становятся полные имена всех супервизоров, включая поднятые вручную. Значит и вычислить это имя у себя нельзя: веб-процесс, дёрнувший MasterSupervisor::name(), получит собственный случайный токен и напишет в очередь команд, которую никто никогда не прочитает, — узнать имя работающего master’а можно только чтением из Redis.
Сразу скажу, чего этот механизм не даёт: В Horizon нет документированного публичного API для runtime-управления супервизорами. Ни
AddSupervisor, ниHorizonCommandQueue, ни формат опций нигде не описаны как контракт, и стабильность их никто не обещал; однако сам Horizon создаёт их через внутреннюю очередь и скрытую командуhorizon:supervisor.Всё дальнейшее стоит на этом допущении, а во что оно обходится — в конце.
Свой слой управления
Всё, что делает сервис ниже, — раскладывает команды по двум очередям Redis. Никаких сигналов, никакого лазания в чужие процессы: разговариваем с Horizon на том языке, на котором этот шизофреник разговаривает сам с собой.
Параметры супервизора для динамических очередей вынесены в отдельный шаблон horizon-конфига, они одинаковы для всех динамических очередей, и к ним я вернусь сразу после кода.
// config/dynamic-queues.php
return [
    'supervisor' => [
        'connection'          => 'redis',
        'balance'             => 'auto',
        'autoScalingStrategy' => 'time',
        'balanceMaxShift'     => 1,
        'balanceCooldown'     => 3,
        'minProcesses'        => 1,
        'maxProcesses'        => 5,
        'memory'              => 64,
        'tries'               => 1,
        'sleep'               => 1,
        'timeout'             => 10,
    ],
];
<?php

namespace AppServicesQueues;

use IlluminateSupportArr;
use IlluminateSupportFacadesArtisan;
use LaravelHorizonContractsHorizonCommandQueue;
use LaravelHorizonContractsMasterSupervisorRepository;
use LaravelHorizonContractsSupervisorRepository;
use LaravelHorizonMasterSupervisor;
use LaravelHorizonMasterSupervisorCommandsAddSupervisor;
use LaravelHorizonSupervisorCommandsContinueWorking;
use LaravelHorizonSupervisorCommandsPause;
use LaravelHorizonSupervisorCommandsRestart;
use LaravelHorizonSupervisorCommandsTerminate;
use LaravelHorizonSupervisorOptions;

final class QueueManagerService
{
    /**
     * Exit code from SupervisorProcess::$dontRestartOn. The master marks a supervisor
     * that exits with this code as dead instead of provisioning it again.
     */
    public const EXIT_TERMINATED_ON_PURPOSE = 2;

    private const STATUS_PAUSED = 'paused';

    private function __construct(
        private readonly HorizonCommandQueue $commands,
        private readonly SupervisorRepository $supervisors,
        private readonly string $masterName,
        private readonly int $masterPid,
    ) {
    }

    /**
     * Build a manager for the master registered in Redis. Used from application code:
     * web requests, console commands, anything running outside Horizon's own processes.
     */
    public static function forRunningMaster(): self
    {
        $master = Arr::first(app(MasterSupervisorRepository::class)->all());

        if ($master === null) {
            throw new NoMasterSupervisorIsRunning();
        }

        return new self(
            app(HorizonCommandQueue::class),
            app(SupervisorRepository::class),
            $master->name,
            (int) $master->pid,
        );
    }

    /**
     * Build a manager for a master that has just deployed its provisioning plan.
     * The master persists itself only once its monitoring loop starts, so at that
     * point Redis knows nothing about it and the pid is taken from the current
     * process, which is the master itself.
     */
    public static function forDeployedMaster(string $masterName): self
    {
        return new self(
            app(HorizonCommandQueue::class),
            app(SupervisorRepository::class),
            $masterName,
            getmypid(),
        );
    }

    public function name(string $supervisor): string
    {
        return $this->masterName . ':' . $supervisor;
    }

    public function exists(string $supervisor): bool
    {
        return $this->supervisors->find($this->name($supervisor)) !== null;
    }

    public function isPaused(string $supervisor): bool
    {
        $record = $this->supervisors->find($this->name($supervisor));

        if ($record === null) {
            throw new SupervisorNotFound($this->name($supervisor));
        }

        return $record->status === self::STATUS_PAUSED;
    }

    public function start(string $supervisor, array $queues, array $overrides = []): void
    {
        $this->commands->push(
            MasterSupervisor::commandQueueFor($this->masterName),
            AddSupervisor::class,
            $this->options($supervisor, $queues, $overrides)->toArray(),
        );
    }

    public function startIfMissing(string $supervisor, array $queues, array $overrides = []): void
    {
        if (! $this->exists($supervisor)) {
            $this->start($supervisor, $queues, $overrides);
        }
    }

    public function stop(string $supervisor): void
    {
        $this->command($supervisor, Terminate::class, [
            'status' => self::EXIT_TERMINATED_ON_PURPOSE,
        ]);
    }

    public function pause(string $supervisor): void
    {
        $this->command($supervisor, Pause::class);
    }

    public function resume(string $supervisor): void
    {
        $this->command($supervisor, ContinueWorking::class);
    }

    public function restart(string $supervisor): void
    {
        $this->command($supervisor, Restart::class);
    }

    public function purge(string $queue): void
    {
        Artisan::call('horizon:clear', ['--queue' => $queue, '--force' => true]);
    }

    private function command(string $supervisor, string $command, array $options = []): void
    {
        $this->commands->push($this->name($supervisor), $command, $options);
    }

    private function options(string $supervisor, array $queues, array $overrides): SupervisorOptions
    {
        return SupervisorOptions::fromArray(array_merge(
            config('dynamic-queues.supervisor'),
            [
                'name'     => $this->name($supervisor),
                'queue'    => implode(',', $queues),
                'parentId' => $this->masterPid,
            ],
            $overrides,
        ));
    }
}
NoMasterSupervisorIsRunningиSupervisorNotFound, как и все остальные исключения, которые встретятся дальше, — пустые наследникиRuntimeExceptionс говорящими именами. Тела у них нет, поэтому и листингов в статье не будет.
Здесь явная асимметрия между start() и всем остальным: master только порождает процессы, поэтому создание уходит в его собственную очередь команд, а пауза, продолжение и остановка отправляются напрямую супервизору, который читает свою очередь сам, на каждой итерации цикла, и master в этом обмене не участвует вообще.
Если работающего master’а нет, лучше упасть сразу, потому что команда, отправленная в очередь несуществующего процесса, ошибки не вызовет — она спокойно ляжет в Redis и будет ждать читателя до скончания веков. Из двух способов отказать, упасть с внятным сообщением или молча ничего не сделать, первый заметно проще разбирать в 3 часа ночи.
Два параметра, которых нет в конфиге
Разбирать опции супервизора я не буду:
стандартные параметры воркера описаны в документации очередей Laravel
стандартные параметры horizon описаны в документации Horizon
в опубликованном
config/horizon.phpу каждой опции обычно есть комментарийЗначения в примере — обычные для коротко живущих супервизоров, и подбирать их под свою нагрузку вы будете ровно так же, как подбирали бы для статического конфига.
Интереснее то, чего в конфиге нет вообще: разворачивая план для провизора, Horizon дописывает в опции два поля от себя.
// LaravelHorizonProvisioningPlan
$options['parentId'] = getmypid();
Имя супервизора он берёт из ключа массива в конфиге и превращает в полное, а parentId ставит равным собственному pid. Создавая супервизора вручную, оба поля приходится подставлять самому, и если с именем всё очевидно, то на parentId легко махнуть рукой. Зря:
// LaravelHorizonSupervisor
if ($this->options->parentId > 1 && posix_getppid() <= 1) {
    return $this->terminate();
}
Защита от сирот: master умер, процесс переподчинили init — супервизор гасит себя сам. Включается проверка только при parentId > 1, так что ноль «чтобы было» её попросту выключает, и осиротевшие супервизоры остаются разбирать очереди, за которыми уже никто не следит.
Обычно pid берётся из репозитория master’ов, но есть окно, когда его там нет: MasterSupervisor записывает себя в Redis уже внутри цикла мониторинга, а план провижининга разворачивается раньше. Слушатель деплоя, о котором речь дальше, работает именно в этом окне, и getmypid() возвращает там ровно то, что нужно, потому что выполняется он в процессе самого master’а. Отсюда и два именованных конструктора в листинге выше: forRunningMaster() читает имя и pid из репозитория и годится для любого кода снаружи Horizon, а forDeployedMaster() берёт имя из события деплоя, а pid — из текущего процесса.
Двойка, на которой всё держится
Самое неочевидное место во всей конструкции выглядит вот так:
$this->commands->push($this->name($supervisor), Terminate::class, ['status' => 2]);
status здесь не сигнал, хотя прочитать двойку как SIGINT очень хочется. Это код, с которым завершится процесс супервизора: Terminate::process() дёргает $terminable->terminate($status), супервизор скейлит пулы в ноль, дожидается воркеров и выходит.
А дальше master смотрит на код выхода того, кого он породил:
// LaravelHorizonSupervisorProcess
public $dontRestartOn = [
    0,
    2,
    13, // Indicates duplicate supervisors...
];

// ...

$this->markAsDead();

if (in_array($exitCode, $this->dontRestartOn)) {
    return;
}

$this->reprovision();
reprovision() кладёт AddSupervisor обратно в очередь master’а, так что супервизор, прибитый с кодом 1, через секунду возвращается к работе: master честно исполняет свой план по поддержанию процессов живыми.
Поведение это не случайное, и код выхода в Horizon работает как способ сказать master’у, что делать дальше. Если пройтись по исходникам, набор получается такой:
-
0 — штатное завершение.
Supervisor::terminate()вызывается без аргумента, когда master гасит детей перед собственным выходом, то есть на каждомhorizon:terminate. Поднимать такого супервизора незачем, master и сам уходит. -
1 — «перезапустись».
MasterSupervisor::restart()рассылает всем детямterminateWithStatus(1), и в списке исключений единицы нет, так что master немедленно проводит их обратно черезAddSupervisor. Это штатный способ перетряхнуть супервизоров, не перезапуская master. -
12 — упёрлись в память. Слушатель
MonitorSupervisorMemoryвызывает$supervisor->terminate(12), и число это то же самое, чтоWorker::EXIT_MEMORY_LIMITв самом Laravel. Раздувшийся процесс должен смениться свежим, поэтому 12 в исключения тоже не входит. -
13 — дубликат.
horizon:supervisorпри старте вызываетensureNoDuplicateSupervisors(), находит живого тёзку и выходит с 13. Вот здесь поднимать заново нельзя категорически, иначе master получит вечный конвейер клонов, каждый из которых умирает при рождении. -
любой другой, включая 255 от фатальной ошибки, — считается аварией, и master поднимает супервизора заново.
Двойки в этом списке нет: grep по всему пакету не находит ни одного места, где Horizon завершал бы супервизор с кодом 2. Единственный код из dontRestartOn, который сам Horizon не использует, — фактически оставленная снаружи ручка «этого больше не поднимать».
Может, разработчики Horizon заранее подумали о том, что их супервизоры кто-то другой переделает в динамические?.. Да ну, бред какой-то…
Формально подошёл бы и ноль, разница тут только в журнале, — но ноль означает «ушёл вместе с master’ом», и если пользоваться им же для уборки, в логах перестанут различаться два довольно разных события: плановая выкатка и супервизор, прибитый за 30 минут простоя. Двойка стоит ровно столько же, а читать её потом приятнее.
Имя как протокол
Имена очереди и супервизора выводятся из идентификатора группы отправки:
final class CampaignSendGroup extends Model
{
    public const SUPERVISOR_PREFIX = 'campaign-group-';
    public const QUEUE_PREFIX = 'mail-';

    public function getBatchQueueName(): string
    {
        return Str::slug(self::QUEUE_PREFIX . $this->id);
    }

    public function getSupervisorName(): string
    {
        return Str::slug(self::SUPERVISOR_PREFIX . $this->id);
    }
}
Идентификатор — UUID, поэтому имена уникальны без всякой координации: две группы отправки не получат одну очередь, даже если создаются одновременно разными процессами. Str::slug() выкидывает всё, что могло бы усложнить жизнь при разборе ключей Redis.
Префикс в имени — единственный признак, по которому свои супервизоры отличаются от чужих, и нужен он потому, что слушатели, которые появятся дальше, срабатывают на каждом цикле каждого супервизора, включая описанные в статическом конфиге и к динамическим отношения не имеющие. Имя, получается, работает как часть протокола, так что переименовать его потом будет примерно так же весело, как переименовать колонку в таблице на 300 миллионов строк.
Очередь заводится под первую пачку
Супервизор не нужен, пока для него нет работы: группа отправки может быть создана в базе за час до старта, а может так и остаться пустой, если под её правила не подошёл ни один адрес. Поэтому поднимается он в момент, когда в очередь кладут первую пачку задач.
final class JobManagerService
{
    private const BATCH_CHUNK_SIZE = 100;

    /** @var array<string, IlluminateBusBatch> */
    private array $batches = [];

    /** @var array<string, array<int, SendMail>> */
    private array $pending = [];

    /** @var array<string, CampaignSendGroup> */
    private array $groups = [];

    public function __construct(
        private readonly Campaign $campaign,
        private readonly QueueManagerService $queues,
    ) {
    }

    public function add(Recipient $recipient): void
    {
        $group = $this->groupFor($recipient);

        $this->pending[$group->id][] = new SendMail($this->campaign, $recipient);

        $this->flush();
    }

    public function flush(bool $force = false): void
    {
        foreach ($this->pending as $groupId => $jobs) {
            if (! $force && count($jobs) < self::BATCH_CHUNK_SIZE) {
                continue;
            }

            $this->push($this->groups[$groupId], $jobs);

            unset($this->pending[$groupId]);
        }
    }

    private function groupFor(Recipient $recipient): CampaignSendGroup
    {
        $group = $this->campaign->sendGroupFor($recipient->host);

        $this->groups[$group->id] = $group;

        return $group;
    }

    private function push(CampaignSendGroup $group, array $jobs): void
    {
        if (isset($this->batches[$group->id])) {
            $this->batches[$group->id]->add($jobs);

            return;
        }

        $this->queues->startIfMissing(
            $group->getSupervisorName(),
            [$group->getBatchQueueName()],
            ['maxProcesses' => $group->workers_count],
        );

        $this->batches[$group->id] = Bus::batch($jobs)
            ->name(sprintf('Campaign %s, %s', $this->campaign->id, $group->host))
            ->allowFailures()
            ->onConnection('redis')
            ->onQueue($group->getBatchQueueName())
            ->dispatch();
    }
}
Супервизор создаётся до диспатча первой пачки, хотя порядок здесь ни на что не влияет: мгновенно он всё равно не появится, потому что команда сначала ложится в очередь master’а и ждёт очередного витка его цикла, а джобы спокойно полежат в Redis, пока за ними не придут. Уборщик, который появится дальше и умеет убивать супервизоры над пустыми очередями, тут тоже никого не догоняет: у него свои тайминги, и до них мы ещё дойдём.
Размер пачки зажат с двух сторон, и обе видны невооружённым глазом. Bus::batch() — это запись в таблицу батчей плюс несколько операций в Redis на каждый вызов, так что пачка из 5 джоб платит эту цену в 20 раз чаще, чем пачка из 100. А пачка из 10 000 заставляет ждать: воркеры простаивают, пока приложение набирает адреса, хотя работа для них уже есть.
Размер пачки в 100 задач — мой собственный кейс, и воспринимать её как готовый рецепт незачем. Где в этом промежутке окажется ваш оптимум, зависит от того, сколько стоит одна ваша джоба и как быстро приложение их производит. Искать его придётся у себя: снять время от создания первой джобы до старта первого воркера, покрутить размер и посмотреть, где график перестаёт улучшаться.
startIfMissing() намеренно неатомарен: между проверкой и отправкой команды действительно может вклиниться другой процесс, и в очередь master’а лягут две команды AddSupervisor с одинаковым именем, но Horizon разгребёт это сам — второй процесс при старте вызывает ensureNoDuplicateSupervisors(), находит тёзку и выходит с кодом 13, тем самым из dontRestartOn, после чего master помечает его мёртвым и поднимать не пытается. Городить сверху распределённую блокировку — значит решать за Horizon задачу, которую он уже решил.
…а потом приходит деплой
Выкатка заканчивается вызовом horizon:terminate: master гасит детей и выходит, менеджер процессов поднимает php artisan horizon заново, новый master читает конфиг и разворачивает его, после чего всё описанное в конфиге возвращается на место, а всё, чего в конфиге не было, испаряется.
Для рассылок это выглядит так: очереди в Redis на месте, джобы в них на месте, а воркеров, которые их разбирают, нет. Рассылка не падает, не отменяется и вообще никак о себе не сообщает — она просто перестаёт двигаться, и заметить это можно по графику отправок, если на график кто-то смотрит и он вообще есть.
Про завершение провижининга Horizon сообщает событием, и приходит оно с именем master’а:
// LaravelHorizonProvisioningPlan
event(new MasterSupervisorDeployed($this->master));
Дальше остаётся пройтись по активным группам отправки и поднять тех, у кого супервизора нет.
final class DeployCampaignsQueues
{
    public function handle(MasterSupervisorDeployed $event): void
    {
        $queues = QueueManagerService::forDeployedMaster($event->master);

        CampaignSendGroup::query()
            ->active()
            ->chunkById(100, static function (Collection $groups) use ($queues): void {
                foreach ($groups as $group) {
                    $queues->startIfMissing(
                        $group->getSupervisorName(),
                        [$group->getBatchQueueName()],
                        ['maxProcesses' => $group->workers_count],
                    );
                }
            });
    }
}
startIfMissing() делает слушателя идемпотентным: событие приходит на каждый деплой, а деплои случаются подряд. Заодно закрывается случай, когда master перезапустился, а часть супервизоров успела подняться другим путём.
Восстанавливается всё это намеренно грубо. «Активная группа отправки» — это запись в базе без флагов отмены и завершения, и про то, осталась ли в очереди работа, она не знает ничего, так что после деплоя поднимется и десяток супервизоров над пустыми очередями, где рассылка фактически закончилась, а статус ещё не проставлен. Разбираться с этим прямо на деплое незачем: через полчаса их приберёт механизм уборщика, он же приберёт их, когда они опустеют по любой другой причине. Одна процедура на все случаи вместо двух похожих.
Обход чанками вместо одного get() — из того же разряда предосторожностей: слушатель работает в процессе master’а, в окне между стартом и циклом мониторинга, и выгружать туда коллекцию на десятки тысяч моделей ради одного поля у каждой — лишний риск ровно там, где от процесса зависит весь провижининг.
Кто уберёт за рассылкой
Рассылка закончилась: последнее письмо ушло, очередь пуста, а супервизор остался — держит свой минимальный процесс, ждёт работы, которой больше не будет, и бодро отчитывается о себе в интерфейсе Horizon. Через неделю таких наберётся несколько сотен, и каждый из них — живой процесс PHP с поднятым фреймворком и занятой памятью.
Убивать супервизора там же, где рассылка помечается завершённой, недостаточно: рассылку могут отменить, могут не закончить, у неё может не сойтись статистика, а процесс, который должен был проставить флаг, может упасть на середине. Опираться надо на наблюдаемое состояние — работы нет и давно не было.
Наблюдать удобнее всего изнутри самого супервизора, благо Horizon на каждой итерации цикла бросает событие:
// LaravelHorizonSupervisor
event(new SupervisorLooped($this));
Приходит оно в процессе супервизора, десятки раз в минуту, и приносит с собой его самого — с опциями, состоянием и методом terminate().
Два таймера
Уборщику нужно знать две вещи: сколько времени очередь пустует и сколько времени её размер не меняется. Оба вопроса закрываются одинаково устроенным счётчиком, живущим в памяти процесса.
final class ElapsedTimer
{
    /** @var array<string, CarbonImmutable> */
    private array $since = [];

    public function minutes(string $key, CarbonImmutable $now): int
    {
        $this->since[$key] ??= $now;

        return (int) $this->since[$key]->diffInMinutes($now);
    }

    public function reset(string $key): void
    {
        unset($this->since[$key]);
    }
}
final class StableValueTimer
{
    /** @var array<string, array{value: int, since: CarbonImmutable}> */
    private array $state = [];

    public function minutes(string $key, int $value, CarbonImmutable $now): int
    {
        $state = $this->state[$key] ?? null;

        if ($state === null || $state['value'] !== $value) {
            $this->state[$key] = ['value' => $value, 'since' => $now];

            return 0;
        }

        return (int) $state['since']->diffInMinutes($now);
    }

    public function reset(string $key): void
    {
        unset($this->state[$key]);
    }
}
Redis и база тут ни к чему: событие прилетает десятки раз в минуту на каждого супервизора, и поход в хранилище за отметкой времени стоит дороже всего остального в обработчике вместе взятого. Ограничение у памяти процесса одно — она не переживает перезапуск Horizon, но после перезапуска и супервизоры создаются заново, так что отсчёт начинается с нуля вместе с ними.
Обнуление таймеров вместе с деплоем выглядит безобидно, пока деплои случаются реже, чем срабатывают пороги. В целом, маловероятно — никто не деплоится постоянно и раз в полчаса; но теоретически возможно. Об этом подробнее в разделе про границы решения: там же, где остальное, во что эта конструкция упирается.
Чтобы состояние дожило хотя бы до соседней итерации, таймеры регистрируются синглтонами: слушатели Laravel создаются заново на каждое событие, а их зависимости — нет.
$this->app->singleton(ElapsedTimer::class);
$this->app->singleton(StableValueTimer::class);
Собственно, Уборщик
final class RemoveStaleCampaignQueues
{
    private const TERMINATE_AFTER_MINUTES = 30;
    private const DUMP_AFTER_MINUTES = 30;

    public function __construct(
        private readonly QueueFactory $queues,
        private readonly ElapsedTimer $idle,
        private readonly StableValueTimer $frozen,
        private readonly QueueDumper $dumper,
    ) {
    }

    public function handle(SupervisorLooped $event): void
    {
        $supervisor = $event->supervisor;

        if (! $this->isCampaignSupervisor($supervisor->name)) {
            return;
        }

        $size = $this->size($supervisor->options);
        $now = CarbonImmutable::now();

        if ($size === 0) {
            $this->frozen->reset($supervisor->name);

            if ($this->idle->minutes($supervisor->name, $now) >= self::TERMINATE_AFTER_MINUTES) {
                $this->idle->reset($supervisor->name);

                $supervisor->terminate(QueueManagerService::EXIT_TERMINATED_ON_PURPOSE);
            }

            return;
        }

        $this->idle->reset($supervisor->name);

        if (! $supervisor->isPaused()) {
            $this->frozen->reset($supervisor->name);

            return;
        }

        if ($this->frozen->minutes($supervisor->name, $size, $now) >= self::DUMP_AFTER_MINUTES) {
            $this->frozen->reset($supervisor->name);

            foreach ($this->queueNames($supervisor->options) as $queue) {
                $this->dumper->dump(sprintf('queues:%s', $queue));
            }
        }
    }

    private function size(SupervisorOptions $options): int
    {
        $connection = $this->queues->connection($options->connection);

        $size = 0;

        foreach ($this->queueNames($options) as $queue) {
            $size += $connection->size($queue);
        }

        return $size;
    }

    /** @return array<int, string> */
    private function queueNames(SupervisorOptions $options): array
    {
        return explode(',', $options->queue);
    }

    private function isCampaignSupervisor(string $name): bool
    {
        return Str::startsWith(
            Str::after($name, ':'),
            CampaignSendGroup::SUPERVISOR_PREFIX,
        );
    }
}
QueueDumper в зависимостях — это выгрузка очереди на диск, к которой мы придём в следующем разделе; пока достаточно знать, что она удаляет ключи очереди из Redis.
Фильтр по префиксу стоит первым по понятной причине: событие приходит от всех супервизоров подряд, и уборщик, промахнувшийся мимо своих, пойдёт убивать чужих. Str::after() безопаснее разбора через explode() с обращением ко второму элементу — имя без двоеточия вернёт само себя, вместо того чтобы уронить обработчик прямо посреди цикла супервизора, но в целом — перестраховка, так как мы ранее договорились, что имена — это заранее определённый контракт.
Сброс таймера простоя при появлении работы выглядит мелочью, но без него супервизор, который 29 минут простоял пустым, потом 3 часа разбирал новую пачку, а потом опустел снова, будет убит на первой же пустой итерации — отсчёт-то идёт с того давнего момента. Ошибка живучая: проявляется она только на группах с рваным темпом, то есть там, где большой подтормаживает, а приложение подливает адреса порциями.
Чем мерить размер очереди
Напрашивается readyNow(), и он же врёт:
// LaravelHorizonRedisQueue
public function readyNow($queue = null)
{
    return $this->getConnection()->llen($this->getQueue($queue));
}
Это один LLEN по списку готовых джоб, а взятые воркерами лежат в queues:<name>:reserved, отложенные ретраи — в queues:<name>:delayed, и ни те ни другие в счёт не идут, так что супервизор, у которого всё разобрано или уехало в отложенные, для readyNow() выглядит пустым.
Считать надо через size(), он есть у любой очереди Laravel:
-- IlluminateQueueLuaScripts::size()
return redis.call('llen', KEYS[1]) + redis.call('zcard', KEYS[2]) + redis.call('zcard', KEYS[3])
Здесь готовые, отложенные и взятые в работу считаются одним атомарным вызовом, и разница между двумя счётчиками заодно объясняет, почему порог взят таким большим: с readyNow() полчаса были страховкой от ложного нуля, а с size() они нужны разве что рассылкам, которые докладывают адреса редкими порциями.
Пауза ценой в гигабайт
С динамическими супервизорами пауза наконец стала настоящей: Pause останавливает воркеров, и холостая карусель из начала статьи исчезает, — а вот вторая половина проблемы остаётся на месте.
Приостановленная рассылка на 800 000 адресов — это 800 000 джоб, лежащих в Redis. Полезной нагрузки в джобе немного, но ею дело не ограничивается: сериализованный объект с идентификаторами, класс, метаданные батча, теги Horizon. Полтора-два килобайта на письмо — и одна приостановленная рассылка держит больше гигабайта оперативки. Оператор поставил её на паузу в пятницу вечером, разбираться будет в понедельник, и все выходные Redis бережно хранит этот гигабайт, не делая с ним ровно ничего. А если таких созданных заранее и приостановленных рассылок две? А если три? А если ещё и таких хитроумных операторов, которые понасоздавали рассылок впрок, с десяток?..
Первое, что просится, — повесить на ключ очереди TTL, и идея плоха ровно тем местом, которым выглядит удобной: TTL уничтожает данные. Рассылка, снятая с паузы через сутки, должна продолжиться с того места, где встала, а не начаться заново, потеряв 800 000 адресов, по которым уже посчитана статистика. Истекать должно место хранения, а не сама работа.
Выходит, очередь надо не удалять, а выгружать куда-то, откуда её можно положить обратно.
Почему DUMP, а не свой сериализатор
Очередь Laravel в Redis — это 4 ключа: список готовых джоб queues:<name>, сортированные множества queues:<name>:delayed и queues:<name>:reserved и список уведомлений queues:<name>:notify; в отложенных лежат ретраи со временем, когда их можно брать, в зарезервированных — джобы, которые воркер уже взял, со сроком, после которого их вернут в работу.
Писать поверх этого свой сериализатор — значит воспроизвести внутренний формат очереди целиком, вместе со скорами и порядком, и переписывать его на каждом мажорном обновлении Laravel. У Redis для таких случаев есть пара команд: DUMP отдаёт значение ключа в собственном бинарном формате вместе с версией кодировки, RESTORE собирает из этого байт в байт то же самое — порядок списка, скоры, типы, всё на месте, и про устройство очереди знать не нужно вообще.
Шаблон queues:<name>* цепляет все 4 ключа разом, так что выгружается очередь целиком, а не её видимая часть.
Дампер
final class QueueDumper
{
    private const LOCK_SECONDS = 600;
    private const SPILL_TO_DISK_AFTER = 8 * 1024 * 1024;

    public function __construct(
        private readonly Connection $redis,
        private readonly Filesystem $disk,
        private readonly LockProvider $locks,
        private readonly string $prefix,
    ) {
    }

    public function dump(string $pattern): void
    {
        $this->locked($pattern, function () use ($pattern): void {
            $path = $this->path($pattern);

            if ($this->disk->exists($path)) {
                throw new DumpAlreadyExists($path);
            }

            $partial = $path . '.part';

            $this->disk->writeStream($partial, $this->export($pattern));
            $this->disk->move($partial, $path);
        });
    }

    public function restore(string $pattern): void
    {
        $this->locked($pattern, function () use ($pattern): void {
            $path = $this->path($pattern);

            if (! $this->disk->exists($path)) {
                return;
            }

            $stream = $this->disk->readStream($path);

            while (($line = fgets($stream)) !== false) {
                if (trim($line) === '') {
                    continue;
                }

                [$key, $payload] = json_decode($line, true, 512, JSON_THROW_ON_ERROR);

                $this->redis->restore($key, 0, base64_decode($payload), 'REPLACE');
            }

            fclose($stream);

            $this->disk->delete($path);
        });
    }

    public function exists(string $pattern): bool
    {
        return $this->disk->exists($this->path($pattern));
    }

    public function forget(string $pattern): void
    {
        $this->locked($pattern, function () use ($pattern): void {
            $this->disk->delete($this->path($pattern));
        });
    }

    /** @return resource */
    private function export(string $pattern)
    {
        $stream = fopen('php://temp/maxmemory:' . self::SPILL_TO_DISK_AFTER, 'w+');

        foreach ($this->keys($pattern) as $key) {
            // DUMP and DEL travel together so that nothing can be pushed and lost
            // between reading the key and removing it.
            [$serialized] = $this->redis->transaction(static function ($tx) use ($key): void {
                $tx->dump($key);
                $tx->del($key);
            });

            fwrite(
                $stream,
                json_encode([$key, base64_encode($serialized)], JSON_THROW_ON_ERROR) . "n",
            );
        }

        rewind($stream);

        return $stream;
    }

    /** @return Generator<int, string> */
    private function keys(string $pattern): Generator
    {
        $cursor = 0;

        do {
            [$cursor, $keys] = $this->redis->scan($cursor, [
                'match' => $this->prefix . $pattern . '*',
                'count' => 100,
            ]);

            foreach ($keys as $key) {
                yield Str::replaceFirst($this->prefix, '', $key);
            }
        } while ((int) $cursor !== 0);
    }

    private function locked(string $pattern, Closure $callback): void
    {
        $lock = $this->locks->lock('queue-dump:' . $pattern, self::LOCK_SECONDS);

        if (! $lock->get()) {
            throw new DumpIsLocked($pattern);
        }

        try {
            $callback();
        } finally {
            $lock->release();
        }
    }

    private function path(string $pattern): string
    {
        return 'redis/' . Str::slug($pattern) . '.redis-dump';
    }
}
Три решения в этом классе стоит объяснить: каждое закрывает свой способ потерять данные.
Блокировка берётся через LockProvider, а не проверкой lock-файла, потому что между «проверили, что файла нет» и «создали файл» отлично помещается второй процесс, после чего два дампа одной очереди поедут одновременно. В Redis блокировка атомарна по построению, а срок жизни ей нужен на тот случай, если взявший её процесс умрёт на середине.
Пишется дамп во временный файл и переименовывается уже по завершении, так что падение посреди выгрузки оставит .part, до которого никому нет дела, вместо усечённого .redis-dump, который при возобновлении рассылки заботливо восстановится как «очередь, в которой половина писем».
php://temp с порогом держит мелкие дампы в памяти и сам сбрасывает крупные на диск. Поднимать memory_limit не нужно — а значит, не нужно и объяснять следующему человеку, почему обработчик очередей позволяет себе гигабайт.
Чего этот код не гарантирует: выгрузка идёт ключ за ключом, и между ключами состояние может меняться — если в момент дампа джоба переедет из
reservedобратно в основной список, она окажется в уже выгруженном ключе, в дамп не попадёт и будет затёрта при восстановлении. На выходе это несколько неотправленных писем.Получасовой порог перед выгрузкой прикрывает именно этот случай, но гарантией он не является. Хотя бы потому, что
size()складывает ready, delayed и reserved: джоба, переехавшая из одного в другой, общую сумму не меняет, так что размер выглядит застывшим, пока внутри вполне себе идёт движение. Расчёт тут другой и чисто практический: у приостановленного супервизора воркеры новых джоб не берут, а взятые до паузы за полчаса обычно успевают вернуться по своемуretry_after. Обычно — не всегда, и держать это в голове стоит.Это потенциальная причина проблем, но в моём случае из-за больших таймаутов такого фактически никогда не возникало, поэтому было принято решение — не усложнять.
Также нужно отдельно следить, куда этот файл дампа денется потом. В k8s, например, контейнеры эфемерны и файл дампа уйдёт в забытие вместе с ним. Что с этим делать и какое постоянное хранилище использовать — решение на вашей стороне.
Как это сцепляется с уборщиком
Выгрузка не завершает супервизора и вообще о нём не знает — она просто удаляет ключи очереди, после чего на следующей же итерации цикла размер становится нулём и включается первый таймер: полчаса пустоты, Terminate с кодом 2, master помечает процесс мёртвым и поднимать не пытается.
Через час после паузы приостановленная рассылка выглядит так: супервизора нет, очереди в Redis нет, на диске лежит файл дампа, в базе — группа отправки с поднятым флагом паузы, и памяти всё это хозяйство стоит ровно ноль.
Возвращаем всё как было
Снятие с паузы собирает конструкцию обратно, и порядок операций тут не вопрос вкуса.
final class SendGroupService
{
    public function __construct(
        private readonly QueueManagerService $queues,
        private readonly QueueDumper $dumper,
        private readonly SendGroupState $state,
    ) {
    }

    public function pause(CampaignSendGroup $group, string $reason): bool
    {
        $supervisor = $group->getSupervisorName();

        if (! $this->queues->exists($supervisor) || $this->queues->isPaused($supervisor)) {
            return false;
        }

        $this->queues->pause($supervisor);
        $this->state->markPaused($group, $reason);

        return true;
    }

    public function resume(CampaignSendGroup $group): void
    {
        $supervisor = $group->getSupervisorName();

        $this->dumper->restore($this->dumpKey($group));

        $this->state->markRunning($group);

        if ($this->queues->exists($supervisor)) {
            $this->queues->resume($supervisor);

            return;
        }

        $this->queues->start($supervisor, [$group->getBatchQueueName()], [
            'maxProcesses' => $group->workers_count,
        ]);
    }

    private function dumpKey(CampaignSendGroup $group): string
    {
        return sprintf('queues:%s', $group->getBatchQueueName());
    }
}
SendGroupState — тонкая обёртка над тем местом, где приложение держит флаг паузы: читается он часто, поэтому живёт в кеше, а перезапуск кеша переживает за счёт метаданных группы отправки.
final class SendGroupState
{
    private const TTL = 120;

    public function markPaused(CampaignSendGroup $group, string $reason): void
    {
        $group->meta = ['pauseReason' => $reason] + $group->meta;
        $group->save();

        Cache::put($this->key($group->id), true, self::TTL);
    }

    public function markRunning(CampaignSendGroup $group): void
    {
        $meta = $group->meta;
        unset($meta['pauseReason']);

        $group->meta = $meta;
        $group->save();

        Cache::put($this->key($group->id), false, self::TTL);
    }

    public function isPaused(string $groupId): bool
    {
        return Cache::remember($this->key($groupId), self::TTL, static function () use ($groupId): bool {
            return CampaignSendGroup::query()
                ->whereKey($groupId)
                ->value('meta->pauseReason') !== null;
        });
    }

    private function key(string $groupId): string
    {
        return 'send-group:' . $groupId . ':paused';
    }
}
Дамп восстанавливается первым: RESTORE с флагом REPLACE перезаписывает ключ целиком, так что если воркеры к этому моменту уже работают, джоба, которую воркер успел взять в reserved, исчезнет вместе с ключом. Очередь должна существовать полностью до того, как появится тот, кто её разбирает.
Флаг паузы снимается вторым, до команды супервизору, и причина в следующем разделе: за состоянием паузы следит сторож, и если снять паузу у супервизора, не тронув флаг, сторож честно вернёт всё как было.
Веток в resume() две, потому что супервизора может и не быть: рассылку, простоявшую на паузе сутки, уборщик давно прибил, и поднимать её надо с нуля, вместо того чтобы будить процесс, которого нет.
Пауза не переживает деплой
Состояние паузы Horizon держит рядом с супервизором, а супервизор после деплоя создаётся заново — и создаётся активным. Слушатель деплоя, честно подняв все группы отправки, поднимет и те, что стояли на паузе, после чего приостановленная рассылка радостно продолжит отправлять письма, поэтому источник истины о паузе живёт в приложении: флаг лежит в кеше и в метаданных группы отправки, а сверкой занимается сторож, который смотрит на то же событие цикла, что и уборщик.
У команды
horizon:supervisorесть флаг--paused, и напрашивается мысль поднимать супервизор сразу приостановленным. Через командную очередь так не выйдет: вSupervisorOptionsполя для паузы нет вовсе, а строку запуска собираетQueueCommandString::toSupervisorOptionsString(), который--pausedне добавляет. Параметр$pausedесть у соседнегоtoOptionsString(), но ни один вызов внутри Horizon не передаёт тудаtrue, так что флаг остаётся доступен только при ручном запускеhorizon:supervisorв обход master’а — а за таким процессом master уже не следит.Впрочем, будь флаг доступен, сторожа он бы не отменил. Начальное состояние процесса и сходимость состояний — разные задачи. Супервизор пересоздаётся деплоем, вызовом
resume(), самим Horizon после неподходящего кода выхода, и в каждом из этих случаев желаемое состояние лежит в базе приложения, а фактическое надо к нему приводить.--pausedотвечает за то, каким процесс родится; сторож — за то, что с ним будет дальше.
final class KeepSupervisorPausedOnRestart
{
    public function __construct(private readonly SendGroupState $state)
    {
    }

    public function handle(SupervisorLooped $event): void
    {
        $name = Str::after($event->supervisor->name, ':');

        if (! Str::startsWith($name, CampaignSendGroup::SUPERVISOR_PREFIX)) {
            return;
        }

        if ($event->supervisor->isPaused()) {
            return;
        }

        $groupId = Str::after($name, CampaignSendGroup::SUPERVISOR_PREFIX);

        if ($this->state->isPaused($groupId)) {
            $event->supervisor->pause();
        }
    }
}
Сверка идёт на каждой итерации, а не один раз после деплоя, и расточительства тут нет. Супервизор поднимается не только из слушателя деплоя: его заведёт первая пачка джоб, пересоздаст resume(), вернёт к жизни сам Horizon, если процесс умер с неподходящим кодом выхода. Сторож, привязанный к конкретному сценарию, покрывал бы один из них, а сторож, который просто приводит наблюдаемое состояние к желаемому, покрывает все — включая те, о которых я не подумал.
Идентификатор группы достаётся из имени супервизора: событие приходит десятки раз в минуту на каждого супервизора, и ходить за этим в базу было бы разорительно, а имя из префикса и UUID содержит всё нужное. В том числе, поэтому имя само по себе является контрактом.
Отмена и завершение
Отменённая или завершённая группа отправки ждать уборщика не должна: у отменённой в очереди лежат письма, которые отправлять уже нельзя.
final class CampaignSendGroupObserver
{
    public function __construct(
        private readonly QueueDumper $dumper,
    ) {
    }

    public function saved(CampaignSendGroup $group): void
    {
        if (! $group->wasChanged(['is_cancelled', 'is_completed'])) {
            return;
        }

        $queues = QueueManagerService::forRunningMaster();
        $supervisor = $group->getSupervisorName();

        if ($queues->exists($supervisor)) {
            $queues->stop($supervisor);
            $queues->purge($group->getBatchQueueName());
        }

        $this->dumper->forget(sprintf('queues:%s', $group->getBatchQueueName()));
    }
}
Порядок здесь обратный тому, что был при возврате: сначала остановить супервизор, потом чистить очередь. Вычистите очередь под работающими воркерами — и они добьют то, что успели взять, так что часть писем всё-таки уйдёт.
Удаление дампа — тот самый последний штрих, про который забывают: рассылку могли поставить на паузу, дождаться выгрузки, а потом отменить, и оставшийся на диске файл превращается в чеховское ружьё: пока не выстрелит, будет просто занимать место, а выстрелит — письмами, отправленными после отмены.
Собираем всё вместе
Регистрация слушателей — единственное, что связывает всё перечисленное в работающую систему.
final class HorizonServiceProvider extends HorizonApplicationServiceProvider
{
    private const LISTENERS = [
        SupervisorLooped::class => [
            KeepSupervisorPausedOnRestart::class,
            RemoveStaleCampaignQueues::class,
        ],
        MasterSupervisorDeployed::class => [
            DeployCampaignsQueues::class,
        ],
    ];

    public function boot(): void
    {
        parent::boot();

        $dispatcher = $this->app->make(Dispatcher::class);

        foreach (self::LISTENERS as $event => $listeners) {
            foreach ($listeners as $listener) {
                $dispatcher->listen($event, $listener);
            }
        }
    }
}
Порядок в списке SupervisorLooped имеет значение: сторож паузы идёт первым, потому что он может перевести супервизора в приостановленное состояние прямо на этой итерации, и уборщик, идущий следом, увидит актуальное состояние и начнёт отсчёт до выгрузки, вместо того чтобы ждать следующего круга.
Событий всего 2, и они задают два независимых цикла: деплой — редкий, внешний, случается когда угодно, и на нём система восстанавливается, а цикл супервизора — частый, внутренний, идёт всё время, пока супервизор жив, и на нём система убирает за собой.
Здесь стоит проговорить всю конструкцию целиком, потому что по кускам кода она не читается, а деталь эта принципиальная. Желаемое состояние живёт в базе приложения: группа отправки активна или отменена, приостановлена или работает, ей положено столько-то процессов. Фактическое состояние живёт в Redis у Horizon: какие супервизоры подняты, что у них в очередях, кто на паузе. Ничего, что синхронизировало бы эти две картины в момент изменения, между ними нет, и это сделано намеренно.
Вместо синхронизации работают две петли сверки. На деплое DeployCampaignsQueues проходит по желаемому состоянию и поднимает недостающее. На каждом витке цикла супервизора KeepSupervisorPausedOnRestart сверяет флаг паузы, а RemoveStaleCampaignQueues — наличие работы, и оба приводят фактическое к желаемому. Команды start(), pause(), resume() и stop() при этом остаются тем, чем и должны быть: способом дотянуться до Horizon, а не местом, где хранится состояние.
Разница вылезает, когда что-то ломается. В императивной схеме процесс, умерший между «поставил флаг в базе» и «отправил команду супервизору», оставляет систему в противоречии навсегда, и разбирать это приходится руками. При сверке он не оставляет ничего: следующий виток увидит расхождение и закроет его сам. Ровно поэтому сторож проверяет паузу на каждой итерации, а не однократно после деплоя, и ровно поэтому уборщик смотрит на размер очереди, а не слушает событие «рассылка закончилась».
Жизненный цикл очереди
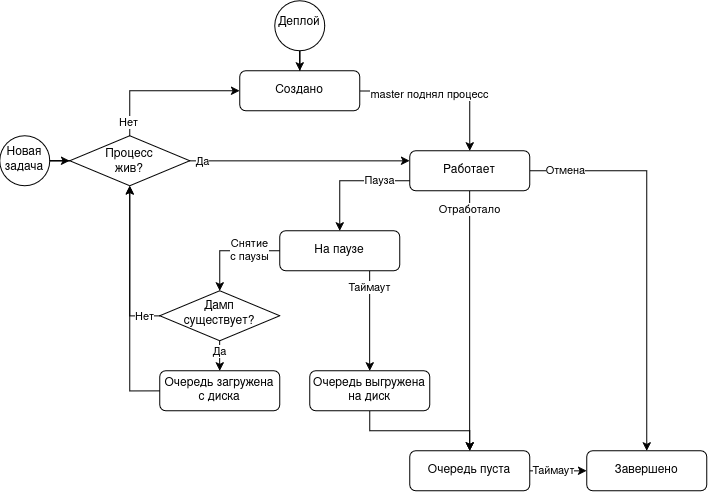
У сверки есть наглядное следствие, которое видно прямо на диаграмме: в неё не нужно дорисовывать переходы вида «процесс упал посередине». Любое состояние, в котором система оказалась, — это просто вершина, из которой следующий виток цикла находит дорогу дальше.
Что здесь ненадёжно
Решение работает в проде годами, что вовсе не то же самое, что «оно надёжно». Дальше по-честному: чего оно не гарантирует и где в него можно въехать.
Публичного API нет. AddSupervisor, HorizonCommandQueue, набор недокументированных ключей SupervisorOptions, коды из dontRestartOn, состав события SupervisorLooped — всё это внутренности, которые авторы Horizon вправе переписать в любом мажорном релизе, не потрудившись упомянуть об этом в changelog. Помогают тут пришпиленная версия и интеграционный тест, который на поднятом Horizon создаёт супервизора, дожидается его появления в репозитории и гасит: такой тест ломается на обновлении раньше, чем ломается прод.
Схема рассчитана на один master. Полное имя супервизора начинается с имени master’а, а forRunningMaster() берёт первого попавшегося из репозитория. Пока Horizon запущен на одной ноде, всё сходится; как только нод становится 2, приложение может создать супервизора через одного master’а, а искать через другого — и не найти. Косметикой это не лечится: выбор master’а придётся делать осознанно и хранить его имя вместе с группой отправки, чтобы все последующие команды уходили тому же процессу.
Таймеры не переживают перезапуск. Это терпимо ровно до тех пор, пока деплои случаются реже, чем срабатывают пороги. Команда, которая раскатывается каждые 20 минут, получит систему, где уборка не отработает никогда: отсчёт обнулится раньше, чем дойдёт до 30. Порог и частота деплоев — связанные величины, и помнить об этом стоит при выборе обоих.
Дамп по умолчанию лежит на диске той ноды, где его сделали. На одной машине это незаметно, в контейнере с эфемерным диском — фатально: рассылка встаёт на паузу, под уезжает на передеплой, дамп отлетает вместе с ним. Диск для дампов должен быть общим или хотя бы переживающим перезапуск контейнера, и выбирать его лучше до первой паузы, а не после первой потери.
Балансировка не видит соседей. Каждый супервизор автоскейлится сам по себе, в рамках своего maxProcesses. 200 одновременных рассылок по 5 процессов — это 1000 процессов PHP, и Horizon их честно запустит, а нода так же честно ляжет. Общего потолка в схеме нет, его приходится держать снаружи: либо ограничением на число одновременно активных групп, либо расчётом workers_count в одном месте, с оглядкой на суммарную ёмкость.
Очистка очереди грубая. horizon:clear --force вычищает очередь целиком. Пока у супервизора ровно одна очередь, это то, что нужно, но стоит кому-нибудь добавить вторую — и отмена одной группы заденет то, что не должна.
Метрики, которых не хватало
Всё описанное выше чинит проблему, но отдельного ответа заслуживает другой вопрос: какая величина показала бы её раньше, чем о ней сообщит клиент.
Главная — расхождение между числом активных групп отправки в базе и числом живых супервизоров с нужным префиксом. Устойчивое положительное значение означает, что где-то стоит рассылка, у которой некому разбирать очередь: слушатель деплоя не отработал, супервизор умер с неподходящим кодом, master не успел подняться.
Ноль при этом ни о чём не говорит. Сравниваются количества, а не соответствие, так что пропавший супервизор одной группы и лишний, оставшийся от другой, дадут в сумме тот же ноль; вдобавок max(0, …) срезает обратный перекос, и супервизоры, пережившие свои группы, этот счётчик не покажет вовсе. Строгий вариант — сравнивать множества имён, а не их размеры. Счётчик дешевле и ловит основную массу случаев, но принимать его ноль за доказательство сходимости не стоит.
final class DynamicQueueMetrics
{
    public function __construct(
        private readonly SupervisorRepository $supervisors,
        private readonly Connection $redis,
        private readonly string $prefix,
    ) {
    }

    public function orphanedGroups(): int
    {
        $active = CampaignSendGroup::query()->active()->count();

        $alive = collect($this->supervisors->all())
            ->filter(fn ($supervisor) => Str::startsWith(
                Str::after($supervisor->name, ':'),
                CampaignSendGroup::SUPERVISOR_PREFIX,
            ))
            ->count();

        return max(0, $active - $alive);
    }

    public function oldestJobAge(string $queue): ?float
    {
        $payload = $this->redis->lindex($this->prefix . 'queues:' . $queue, 0);

        if ($payload === null) {
            return null;
        }

        $pushedAt = json_decode($payload, true)['pushedAt'] ?? null;

        return $pushedAt === null ? null : microtime(true) - (float) $pushedAt;
    }
}
Вторая величина — возраст самой старой джобы в очереди, и достаётся он неожиданно дёшево: Horizon кладёт в полезную нагрузку pushedAt, очередь наполняется через RPUSH и разбирается через LPOP, так что самая старая джоба лежит в начале списка и читается одним LINDEX. Размер очереди об этом молчит: 10 000 джоб в быстро едущей рассылке — норма, а 100 джоб, лежащих там четвёртый час, — симптом.
Обе снимаются снаружи, обе стоят по десятку строк, и обе появились у меня позже, чем следовало.
Где это ещё применимо
Почтовые рассылки — частный случай, и та же конструкция нужна везде, где единицу изоляции заводит пользователь, а не разработчик: импорт и экспорт данных в SaaS, где клиент не должен стоять в очереди за чужой выгрузкой на 10 миллионов строк; кодирование видео, где заказ живёт часами и его надо уметь придержать; очереди к дорогому железу, где у каждого заказчика свой лимит. Общее у них одно: число параллельных потоков работы неизвестно на момент деплоя, а изолировать их надо по-настоящему — с паузой, лимитом и уборкой.
А если единиц изоляции конечное число и они известны заранее, всё это лишнее. Несколько очередей в конфиге и приоритеты воркера решают задачу без единой строки недокументированного кода, и менять их на рантайм-супервизоры стоит только тогда, когда конфиг перестал описывать реальность.
Чем это обошлось
Код писался несколько дней, а больше времени ушло на чтение исходников Horizon ради одной-единственной мысли: конфиг для него — просто штука, которая при старте производит команды AddSupervisor, а дальше всё выводится само.
За вход в недокументированную часть платить приходится на каждом обновлении. Плата небольшая и понятная — интеграционный тест и внимательное чтение диффа мажорных релизов, — но платить её придётся всегда, и закладываться на это стоит до того, как решение уедет в прод.
Оговорюсь: всё вышеописанное — про мир, где Horizon живёт на своих машинах. Если инфраструктура переехала в облако, а нагрузкой заведуют kubernetes, argocd и helm-чарты, ту же задачу решают уже их средствами, и решают по-другому. Разбирать это здесь я не стал: статья и так вышла немаленькой, а тема тянет на отдельную. ;-)
Что есть сегодня
Когда всё это писалось, поиск не давал ничего, но с тех пор кое-что появилось. Целиком задачу не закрывает ни один из вариантов ниже, и всё же начинать знакомство стоит с них.
-
laravel/horizon — официальная документация. Про рантайм-управление супервизорами в ней по-прежнему ни слова, зато подробно описаны параметры, которые уезжают в
SupervisorOptions. -
smskin/laravel-dynamic-horizon — самое близкое к описанному здесь. Хранит конфигурацию динамических супервизоров в Redis и сверяет её с реальностью на
MasterSupervisorLooped. Создание и остановка есть, уборки, паузы и выгрузки нет. -
MilesPong/dynamic-horizon — добавляет супервизоров через колбэк в сервис-провайдере и умеет добавлять их в рантайме. Всё, что происходит с супервизором после создания, остаётся на вас.
-
Laravel Horizon: dynamic queues, rate-limiting and tears from API design — другой подход к той же боли: статический конфиг и переписанный автоскейлер, который раздаёт процессы по ключу из тегов джобы.
Автор: Manriel
