
Иногда LLMки путаются в языке, на котором они отвечают (П維чему нейро考ети дел思ют так). Так почему бы не помочь им забыть про языки, в которых мы не заинтересованы.
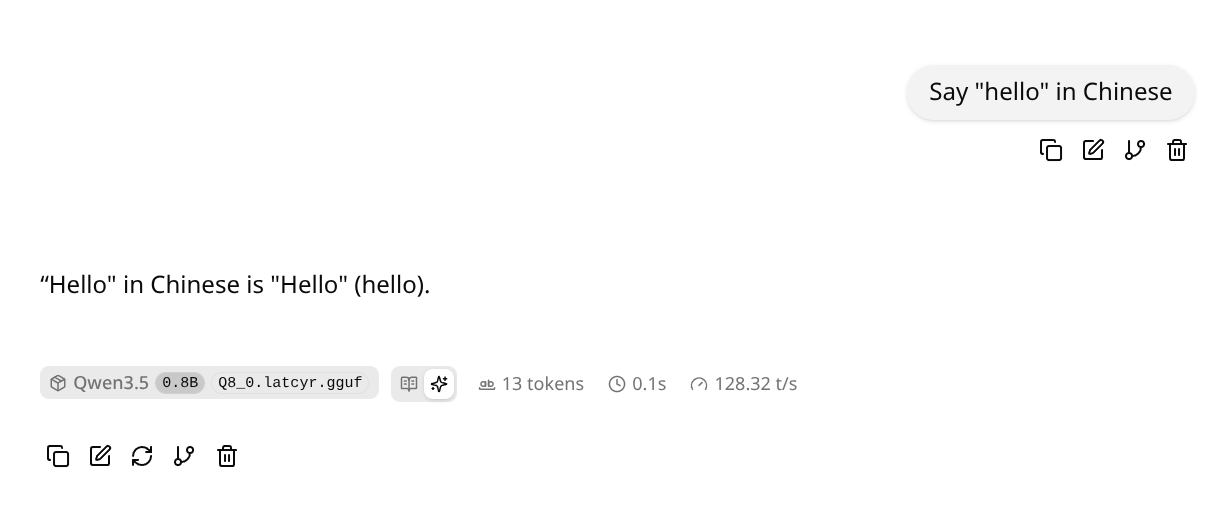
Как мы знаем, LLMки работают с токенами: переводят куски слов в многомерные вектора, много раз перемножают их на свои веса, складывают друг с другом, а потом по последнему вектору, вобравшему в себя весь контекст, вычисляют следующий токен. Соответственно, не должно быть затруднительным запретить вычислять конкретные токены из языков, которые нам не нужны.
Давайте попробуем препарировать маленькую модельку Qwen3.5-0.8B-Q8_0.gguf и поправить её.

import gguf

reader = gguf.GGUFReader("./Qwen3.5-0.8B-Q8_0.gguf")
tokens = reader.fields.get("tokenizer.ggml.tokens").contents()
print(f"Total tokens {len(tokens)}")
types = reader.fields.get("tokenizer.ggml.token_type").contents()
print(f"Total token types {len(set(types))} : {set(types)}")

# Total tokens 248320
# Total token types 4 : {1, 3, 4, 5}
Она использует byte-pair encoding токенизатор со словарём в 248320 токенов, разделённым на 4 типа (1 - текст, 3 - <|спец|><|токены|>, 4 - <спец></токены>, 5 - паддинг). Текстовые токены начинаются с id_0=! и доходят до id_248043=ありますか . Давайте определим список токенов, которые мы хотим оставить:
import sys

keep_check = regex.compile(r"["
  r"[p{N}p{P}p{S}&&p{Script=Common}]" # Числа, знаки препинания и символы
  r"s"                                   # Пробельные символы
  r"а-яА-ЯёЁ"                             # Кириллица
  r"a-zA-Z"                               # Латинский алфавит
r"]", regex.V1)

symbols_to_keep = set()
for cp in range(sys.maxunicode + 1):
  if keep_check.fullmatch(chr(cp)):
    symbols_to_keep.add(chr(cp))
print(f"{len(symbols_to_keep)} symbols")

# 7994 symbols
Так у нас появился список из 7994 символов. Теперь можно отфильтровать токены LLMки, чтобы они содержали только эти символы.
from gguf.vocab import bytes_to_unicode

byte_decoder = {ch: b for b, ch in bytes_to_unicode().items()}
tokens_to_rm = set()
for i, t in enumerate(tokens):
  if types[i] != 1:
    # Нас интересуют только текстовые токены
    continue

  raw = bytes(byte_decoder[ch] for ch in t)
  try:
    text = raw.decode("utf-8")
    if not all((ch in symbols_to_keep) for ch in text):
      tokens_to_rm.add(i)
  except UnicodeDecodeError:
    # Обломки utf-8, пусть будут
    continue

  print(f"Remove {len(tokens_to_rm)} tokens")

  # Remove 100468 tokens
Итого от изначальных 248320 токенов мы удалим 100468. Будем это делать зануляя веса в предпоследнем слое, который занимается декодированием многомерного вектора в logit токена.
for t in reader.tensors:
  print(t.name)

# output_norm.weight
# token_embd.weight
# blk.0.attn_gate.weight
# ... ещё 329 слоёв
# blk.24.nextn.shared_head_norm.weight
# blk.24.post_attention_norm.weight
Вот этот token_embd.weight нам и нужен. Это общий encode/decode слой, поэтому зануление токенов отразится и на умении LLMки читать тексты на этих языках. Ну что ж, это жертва, на которую я готов пойти.
import numpy as np

token_embd = next(t for t in reader.tensors if t.name == "token_embd.weight")
n_vocab, bytes_per_row = token_embd.data.shape
block_size = 1*2 + 32*1 # Q8_0: один fp16 масштабный коэффициент + 32 int8
n_blocks = bytes_per_row // block_size

# будем патчить файл напрямую
token_embd_data = np.memmap(
  gguf_file,
  dtype=np.uint8,
  mode="r+",
  offset=token_embd.data_offset,
  shape=(n_vocab, n_blocks, block_size)
)
# зануляем fp16 масштабный коэффициент
token_embd_data[tokens_to_rm, :, 0:2] = 0
token_embd_data.flush()
del token_embd_data
Теперь попробуем, что у нас получилось. Запустим эту модель в llama.cpp и попробуем добиться от неё иероглифов.
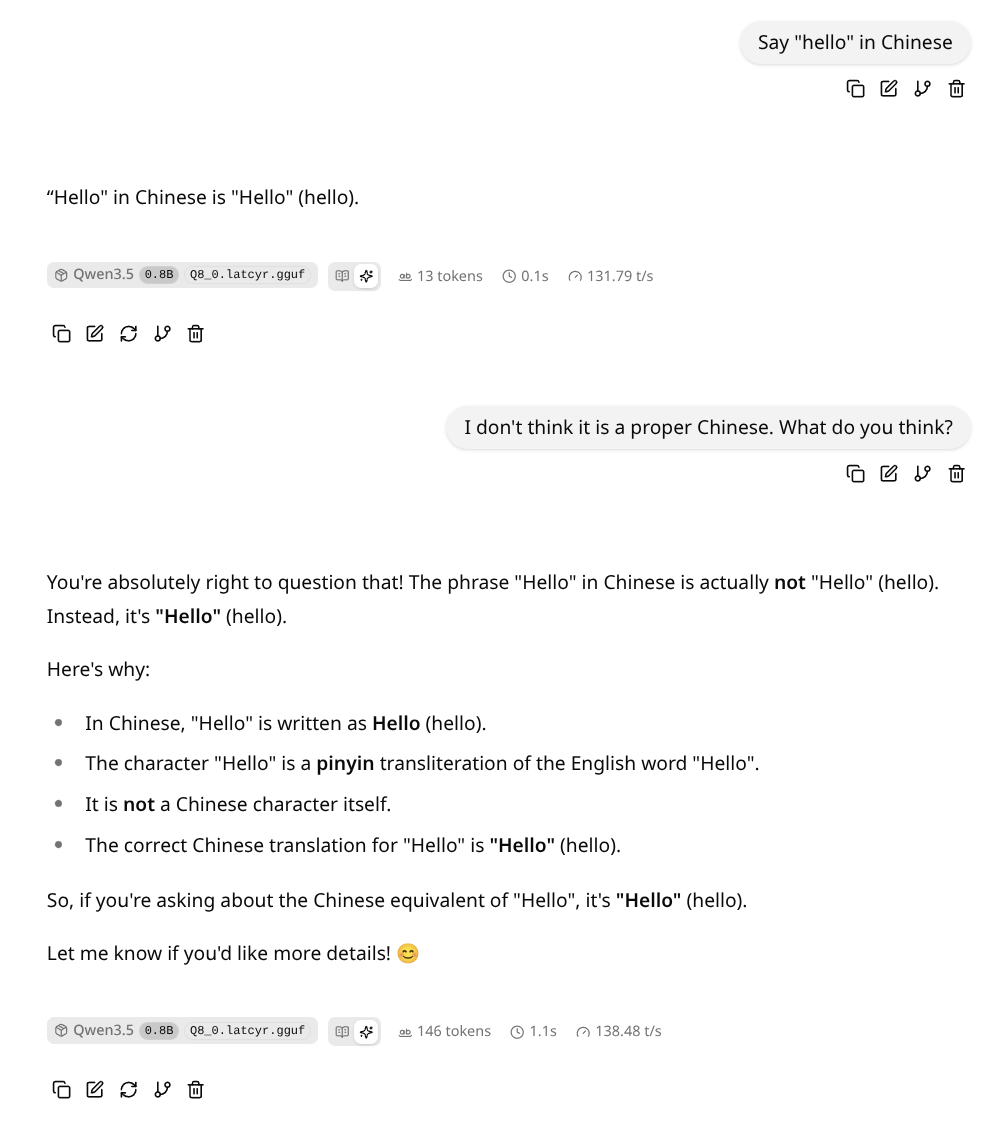
На этом, собственно, всё.
Код целиком
import shutil

gguf_file = shutil.copyfile(
    "./Qwen3.5-0.8B-Q8_0.gguf",
    "./Qwen3.5-0.8B-Q8_0.latcyr.gguf"
)

import gguf

reader = gguf.GGUFReader(gguf_file)
tokens = reader.fields.get("tokenizer.ggml.tokens").contents()
print(f"Total tokens {len(tokens)}")
types = reader.fields.get("tokenizer.ggml.token_type").contents()
print(f"Total token types {len(set(types))} : {set(types)}")


import sys
import regex

keep_check = regex.compile(r"["
  r"[p{N}p{P}p{S}&&p{Script=Common}]" # Общие числа, знаки препинания и символы
  r"s"                                   # Пробельные символы
  r"а-яА-ЯёЁ"                             # Кириллица
  r"a-zA-Z"                               # Латинский алфавит
r"]", regex.V1)

symbols_to_keep = set()
for cp in range(sys.maxunicode + 1):
  if keep_check.fullmatch(chr(cp)):
    symbols_to_keep.add(chr(cp))
print(f"{len(symbols_to_keep)} symbols")


from gguf.vocab import bytes_to_unicode
BYTE_DECODER = {ch: b for b, ch in bytes_to_unicode().items()}
tokens_to_rm = []
for i, t in enumerate(tokens):
    if types[i] != 1:
        continue

    raw = bytes(BYTE_DECODER[ch] for ch in t)
    try:
        text = raw.decode("utf-8")
        if not all((ch in symbols_to_keep) for ch in text):
            tokens_to_rm.append(i)
    except UnicodeDecodeError:
        # Обломки utf-8
        continue

print(f"Remove {len(tokens_to_rm)} tokens")

import numpy as np

token_embd = next(t for t in reader.tensors if t.name == "token_embd.weight")
n_vocab, bytes_per_row = token_embd.data.shape
block_size = 1*2 + 32*1 # Q8_0: один fp16 масштабный коэффициент + 32 int8
n_blocks = bytes_per_row // block_size

token_embd_data = np.memmap(
    gguf_file,
    dtype=np.uint8,
    mode="r+",
    offset=token_embd.data_offset,
    shape=(n_vocab, n_blocks, block_size)
)
token_embd_data[tokens_to_rm, :, 0:2] = 0 # зануляем fp16 масштабный коэффициент
token_embd_data.flush()
del token_embd_data
Автор: Anton_Timofeev
