
Рубрика «llm-модели»
Guardrails для LLM: как устроена защита языковых моделей
2026-10-08 в 8:00, admin, рубрики: chatgpt, guardrails, llm-модели, selectel, waf, ии-система, инфраструктура, нейросети, политика безопасности, угрозы
Зачем нейросети «обвязка»: как превратить LLM в рабочий AI-сервис
2026-09-30 в 12:00, admin, рубрики: AI, harness, harness engineering, llm, llm-модели, ml, mlops, обвязка, обвязка агента
Большую языковую модель можно скачать с Hugging Face, развернуть на сервере с GPU и отправить ей первый запрос. Технически LLM уже работает: получает текст на вход и генерирует ответ. Но до готового бизнес-сервиса еще далеко.
Как запустить Gemma на сервере: сравниваем Ollama и llama.cpp
2026-09-30 в 8:00, admin, рубрики: AI, ai-агенты, gemma, Gemma 4, llama.cpp, llm, llm-модели, ml, Ollama, selectel
Откройте любую статью-инструкцию по установке LLM, в которой фигурирует Ollama. Уверен, в комментариях к ней автору уже объяснили, насколько он неправ и что единственное верное решение — использовать llama.cpp.
Иногда LLMки путаются в языке, на котором они отвечают (П維чему нейро考ети дел思ют так). Так почему бы не помочь им забыть про языки, в которых мы не заинтересованы.
Как запустить 176B‑класс Qwen3.8-Flash‑Next в DeepSeek Harness на GTX 1080 Ti
2026-09-23 в 8:49, admin, рубрики: AI, ai-агенты, deepseek harness, llama, llama.cpp, LLM-агенты, llm-моделиВведение: как запустить модель на 100+ GB веса на видеокарте с 11 GB VRAM
Когда смотришь на характеристики современных MoE‑моделей, иногда возникает странная мысль: а что будет, если взять модель с сотнями миллиардов параметров и попробовать запустить её на старом игровом GPU?
С Qwen3.8-Flash‑Next этот эксперимент оказался особенно интересным.
https://huggingface.co/Qwen/Qwen3.8-27B
Кратко:
-
Размер модели относительно небольшой, довольно быстро работает на карточках с 24+ GB VRAM.
-
"Понимает" изображения и видео
-
по некоторым бенчмаркам - лучше чем Opus 4.6
-
контекст: 262K, с помощью YARN можно увеличить до 1M

Как я сделал AiRevit: от обычного текста до BIM-модели в Revit б без LLM
2026-07-29 в 9:51, admin, рубрики: autocad, dynamo, gnn, llm, llm-модели, revit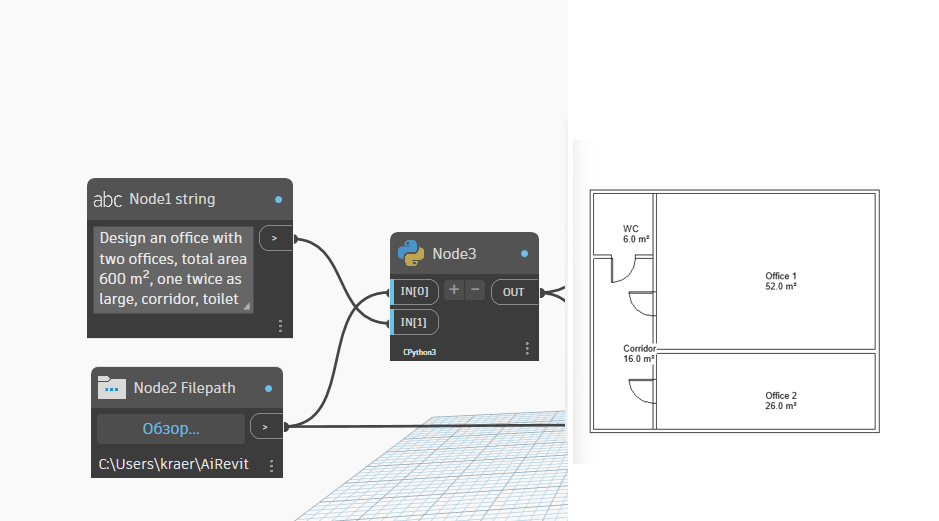
Агенты, или Путешествие к LLM и обратно
2026-07-22 в 9:21, admin, рубрики: ai-агенты, llm, LLM-агенты, llm-моделиАгенты сейчас обсуждают все подряд. Меняются фреймворки, появляются MCP-серверы, облака обещают «агента из коробки». Но в центре любой такой схемы по-прежнему одна и та же вещь — LLM: она читает контекст и формулирует следующий шаг. А между запросом к агенту и самой моделью — ещё несколько слоёв.
ИИ снова закрывается: почему нейросети оказались на грани блокировок
2026-07-08 в 11:00, admin, рубрики: AI, alibaba, claude, claude mythos, DouBao, glm, llm-модели, qwen, selectel, искусственный интеллект
Локальная большая лингвистическая модель на Windows 11: выбор среды, модели и пошаговое развёртывание
2026-07-02 в 4:01, admin, рубрики: bot, llm, llm-модели, telegram, боты, обстановка, обстановка в мире, телеграмботыЭто третья статья в рамках проекта "Ситуационная осведомленность 24/7". С нее мы начинаем подготовку к развертыванию своей локальной системы круглосуточной ситуационной осведомленности. В данном материале пойдет доклад о том, как поднять свою локальную большую лингвистическую модель (далее - БЛМ).
Приступим.