

Заголовок этой статьи, частично, наглядная демонстрация того, как его видит языковая модель. Куски слов, нарезанные по логике, которая к русскому языку не имеет вообще никакого отношения.
Заголовок этой статьи, частично, наглядная демонстрация того, как его видит языковая модель. Куски слов, нарезанные по логике, которая к русскому языку не имеет вообще никакого отношения.
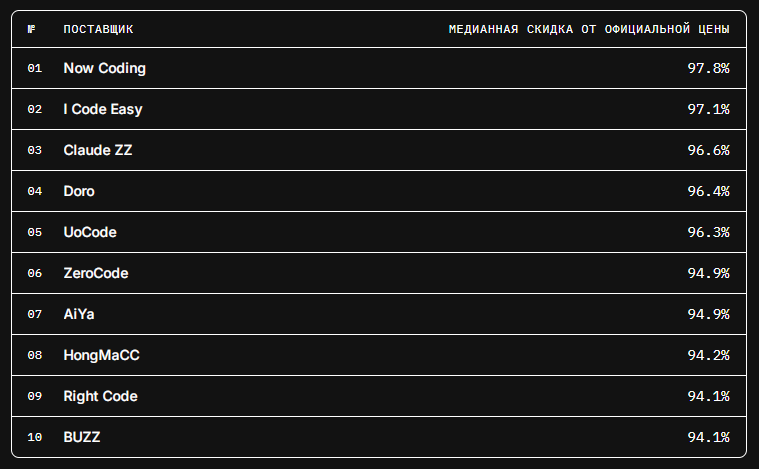
Я долгое время размышлял о мошенничестве с токенами — проблеме, с которой впервые столкнулся, когда работал разработчиком ПО в ИИ-шлюзе.
Всем привет! Меня зовут Николай.
Сначала отвечу на вопрос из заголовка. Нафаня - это агентный RAG-помощник по нормативно-технической документации, связанной со строительством и ценообразованием (методики Минстроя, ГОСТы, СНиПы, СП и профильные законы).
Эта статья о том, как устроен Нафаня, как прошла его проверка на сложном бенчмарке и как архитектура менялась шаг за шагом, чтобы преодолеть потолок метрик.
В моём распоряжении домашняя рабочая станция с двумя RTX 4070 по 16 ГБ и одной RTX 5060 на 16 ГБЧитать полностью »

В декабре 2023 по ML-тусовке прокатилась волна заголовков в духе «трансформерам конец». Поводом стала статья двух исследователей — Альберта Гу и Три Дао — со скучным названием: Читать полностью »
Эта статья про мои эксперименты с языковыми моделями, в которых не используется машинное обучение и аппаратное ускорение. Чтобы избежать недопонимания поясню, что я имею ввиду под языковой моделью (ЯМ).
Несколько недель назад моя коллега переводила интерфейс одной программы на иностранный язык. Задача была обычная: LLM в помощь, проверить вручную, отдать в локализацию. В одном месте у LLM не нашлось подходящего слова в целевом языке, и вместо того чтобы выбрать ближайший вариант или оставить кальку, она придумала новое слово. Оно состояло из существующих корней языка, было фонетически естественным, и точнее передавало смысл оригинала, чем любое из реальных слов этого языка.
Технократический разбор для инженеров и бизнес-аналитиков. Без преувеличений и продающих лозунгов.
Данная статья представляет собой результат кабинетного исследования об основных особенностях работы ИИ (LLM, модель). Здесь в систематизированном виде относительно простым языком описано, как реализуется вся та “магия” про ИИ, с которой мы сталкиваемся сами или слышим в восторженно-продающих материалах.
Сразу уточню, что под ИИ тут понимается именно публичная Большая языковая (текстовая) модель (LLM), вроде ЧатаГПТ, ГигаЧата, Дипсика и др.
В этой статье мы:
Один из распространенных инструментов на основе ИИ – автозаполнение с подсказкой. В идеале, он должен ускорить набор текста. Однако, такие инструменты незаметно меняют наше мировоззрение. Масштабное исследование показало, что подсказки автозаполнения с заранее заложенным паттерном смыслов, меняют позицию пользователя в отношении к смертной казни и добыче сланцевого газа методом гидроразрыва. И это только то, что нам известно.
Уже больше года назад у меня зародилась идея создать свою архитектуру языковой модели. Традиционные модели, "думающие" на уровне токенов мне решительно не нравились. Колоссальный вычислительный бюджет на то, чтобы просто предсказать один токен. Логичным мне казалось оторвать мышление модели от токенов, перенеся его в латентное пространство. Примерно полгода назад я начал первые практические эксперименты и сейчас получил первые практические результаты. Поскольку уровень подготовки читателей очень сильно различается, в статье не будет глубоких технических разборов, а скорее история эксперимента.
