
Мы с женой хотели вместе поиграть в Split Fiction на PS5. Но с английским у нас обоих не очень: понимать диалоги на слух трудно, а хочется следить за историей и слышать реплики на понятном нам языке.
Так появилась идея: пусть MacBook читает игровые субтитры по-русски, пока мы играем на телевизоре. С этого и начался проект.
К телевизору уже была подключена карта видеозахвата с HDMI-входом, HDMI-выходом и USB. Оставалось получить картинку на MacBook, вырезать нижнюю треть экрана, распознать текст и прочитать его вслух. Главное — не повторять одну реплику всё время, пока она висит на экране.
Потом выяснилось, что субтитры могут быть английскими. Что в игре на двоих одна фраза появляется сразу в двух местах. Что героиня должна говорить «я была готова». И что русский перевод иногда можно найти вообще без переводчика — по контрольной сумме исходной строки.
Так получилось приложение PS5 Voice. Собирал его вместе с Codex, а требования и проверки приходили из самой игры: запускал сцену, слушал результат и разбирался, что пошло не так. Мы уже играли с женой с этой озвучкой. Ниже расскажу, как она устроена и какие задачи пришлось решить по дороге. В конце оставлю промпт, с которым можно попробовать собрать такое приложение в своём агенте.
Приставка играет, ноутбук читает
Схема подключения такая:
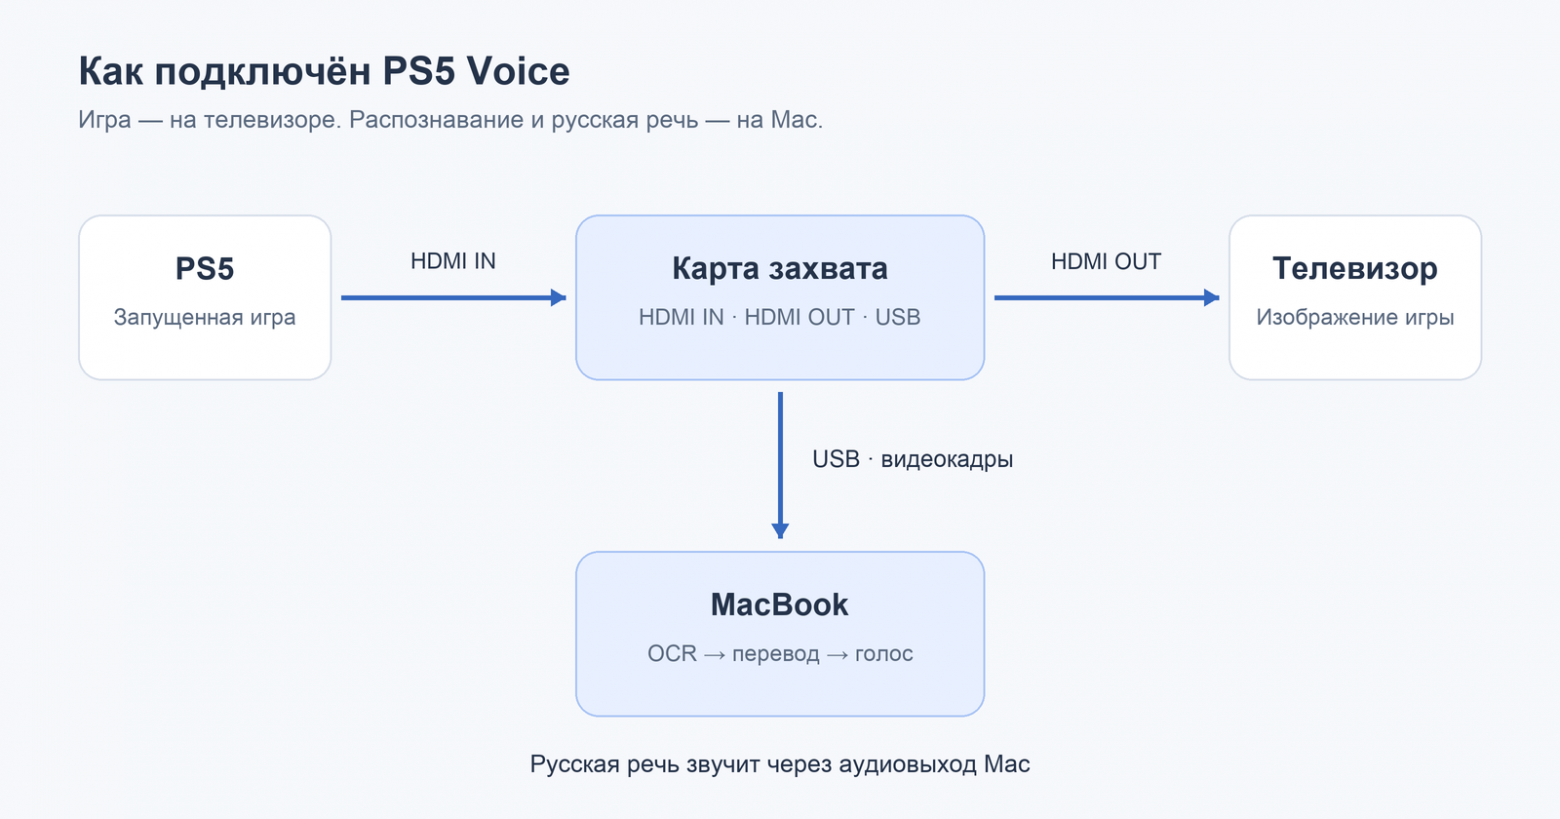
Игра остаётся на телевизоре. На Mac приходит копия изображения, а из динамиков ноутбука звучит русский текст. Оригинальная английская дорожка продолжает играть на телевизоре. Громкость оригинала и русской речи регулируется отдельно.
Я использовал OEM 4K HDMI USB 3.0 Video Capture Card с Kaspi. Со стороны macOS она называется USB3.0 Video и выглядит как камера. Поэтому для получения кадров приложению нужно разрешение на доступ к камере. Для распознавания субтитров я использую захват 1920 × 1080.
Приложение ничего не устанавливает на приставку и не читает файлы с PS5. Всё, что оно знает об игре, сначала приходит в виде пикселей.
Экранные переводчики уже существуют — например, на Хабре есть разбор AssistAnt. Меня интересовала конкретная связка: приставка, телевизор и MacBook, который сам следит за субтитрами и озвучивает новые реплики.
Сейчас у PS5 Voice два основных режима: читать русские субтитры или переводить английские на русский и читать перевод. Дополнительно можно подключить файл готовых диалогов и назначить персонажам разные голоса. Приложение написано на Swift и SwiftUI, минимальная версия системы — macOS 15. Проверял я его на MacBook Air с M4 и 24 ГБ памяти.
Почему нельзя просто читать каждый распознанный текст
За захват отвечает AVFoundation, за распознавание — Apple Vision. В OCR попадает только выбранная область кадра. Изначально это нижняя треть; высоту и отступы можно менять в окне приложения.
Это первая полезная настройка. Если захватить слишком большую область, голос с одинаковым удовольствием прочитает и диалог, и пункт меню. OCR умеет находить буквы, но не знает, что я собираюсь слушать именно разговор персонажей.
Проверять каждый видеокадр не требуется. По умолчанию приложение запускает OCR пять раз в секунду; частоту можно поднять до десяти. Если обработка не успевает, старые кадры пропускаются. Копить очередь картинок для такой задачи бессмысленно: к моменту распознавания разговор уже уйдёт вперёд.
После OCR текст не сразу отправляется в озвучку. Сначала он должен подтвердиться хотя бы в двух наблюдениях и продержаться заданное время — сейчас по умолчанию 0,24 секунды. При пяти проверках в секунду для этого обычно нужны три наблюдения. Так случайная строка на одном кадре не превращается в реплику.
Дальше начинается борьба с повторами.
Сравнивать только с последней строкой недостаточно. На экране может появиться фраза А, затем Б, затем снова А. К тому же OCR иногда меняет регистр, теряет апостроф или видит «е» вместо «ё». Для сравнения текст приводится к общей форме, а принятые реплики сохраняются в памяти сеанса.
С небольшими ошибками OCR нужна осторожность. «У нас есть выход» и «У нас нет выхода» очень похожи, но пропустить вторую фразу было бы обидно. Поэтому изменившиеся числа, короткие слова и добавленные отрицания не считаются безобидным шумом.
Ещё бывают растущие субтитры: сначала показана одна строка, потом к ней добавляется следующая. Если начало уже принято, приложение старается прочитать только новую часть.
У этого подхода есть цена. Если персонаж намеренно повторит ту же короткую команду позже, точное совпадение тоже будет подавлено. Я изначально просил не читать повторы, поэтому оставил такое поведение. Для повторного прохождения сцены есть кнопка сброса памяти.
Два игрока — одна реплика дважды
Первый вариант искал текст в нижней полосе целого экрана. Затем я запустил Split Fiction с вертикальным разделением на двух игроков.
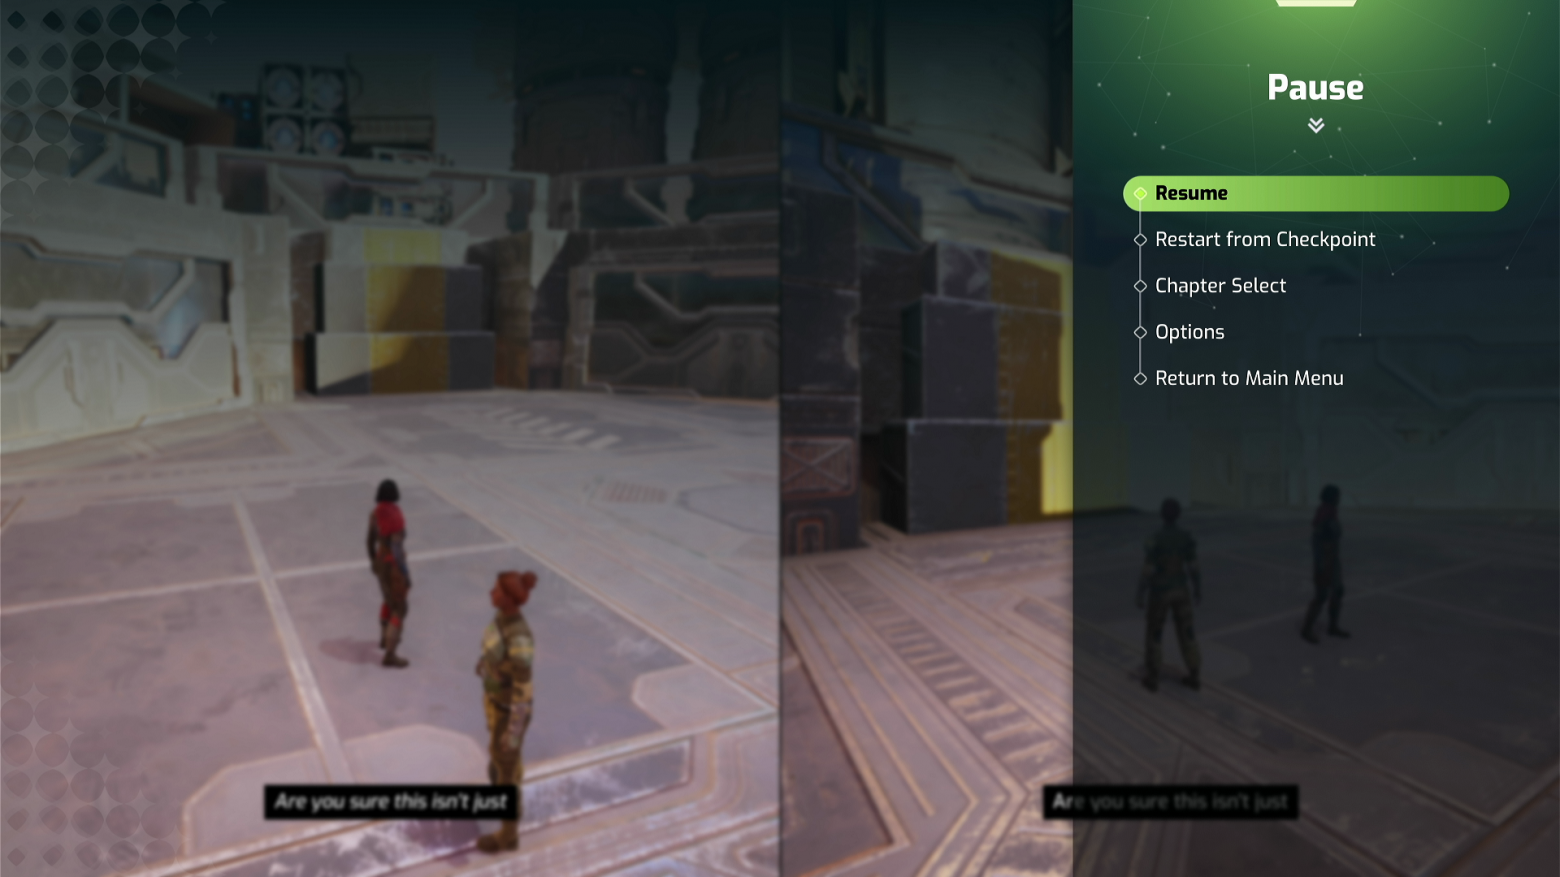
Сохранённый кадр с PS5. Игра стоит на паузе; один и тот же субтитр виден слева и справа.
Для OCR здесь действительно два текстовых блока. Если просто собрать всё найденное и передать дальше, получится одна фраза, повторённая дважды. При этом нельзя безусловно выкинуть правую половину: там может быть другая реплика.
Поэтому появился режим «Два игрока · слева/справа». Распознанные блоки распределяются по координатам, строки каждой половины собираются отдельно и независимо проходят проверку стабильности. Затем обе стороны обращаются к общей памяти повторов.
Одинаковая реплика с двух сторон проходит один раз. Разные реплики сохраняются обе и поступают в речь последовательно. Текст, пересекающий центральную границу, обрабатывается целиком — это нужно для общих субтитров в кат-сценах.
Границу между игроками можно двигать в настройках. При необычном расположении субтитров область распознавания подстраивается вручную.
«Я был готов», сказала героиня
Для английских субтитров в цепочке появился Apple Translation. После первоначальной загрузки языков перевод выполняется на Mac. Ни видеокадры, ни текст реплик приложение в облачный сервис не отправляет.
Повторы по-прежнему отсекаются до перевода, по английскому оригиналу. Иначе можно несколько раз переводить один субтитр, а затем ещё и принимать немного разные русские варианты за новые реплики.
Проблему рода английский текст решает не всегда. По фразе I was ready нельзя узнать, кто её произносит. А женский тембр не исправит мужское окончание в уже подготовленном русском предложении.
В настройках появились два независимых выбора: голос и грамматический род. В режиме «Автоматически» остаётся результат переводчика. В женском или мужском режиме локальный обработчик на Natasha и pymorphy3 пытается согласовать сказуемое: «я хотела», «ты готова», «я хотел», «ты готов».
Простая замена окончаний здесь быстро испортила бы текст. «Мост был разрушен» должен остаться мостом независимо от того, кто на него смотрит. Поэтому обработчик учитывает синтаксические связи и старается менять формы, относящиеся к «я» и «ты», а также некоторые реплики с пропущенным подлежащим.
Это ограниченная коррекция, которой можно помочь переводчику. Понимания всей сцены у неё нет. Выбранный род применяется ко всем автоматически переведённым репликам; если в разговор вступит другой персонаж, приложение не определит его пол по картинке.
А что, если перевод уже существует?
С машинным переводом случались вполне наглядные промахи. В сохранённой сцене Bogeys from behind! превратилось в «Боги сзади!». Озвучить это можно быстро и приятным голосом, но смысл от этого не появится.
Тогда возникла другая идея: у Split Fiction могут быть опубликованные переводы диалогов. Если найти исходную реплику в такой базе, можно сразу взять русский вариант. А если рядом есть имя говорящего — ещё и выбрать голос.
Для эксперимента нашёлся русификатор olddude версии 0.4. Автор указывает, что использовал Gemini и затем редактировал перевод. Это существенно: готовый файл сам по себе не гарантирует качество профессиональной локализации.
Внутри архива оказался файл Split.locres. В нём 13 450 записей вместе с интерфейсом. После отбора русских записей диалогов с ключами VO_ осталось 9 500. Часть ключей содержит идентификатор персонажа. Например:
VO_DES_Prologue_Oilrig_ControllableShip_EnemyDestroyed_Zoe_030
Здесь Zoe позволяет связать реплику с Зои.
Но обычной таблицы «английский текст → русский текст» в файле не было. Английские строки уже заменили русскими. Зато у записей сохранилось поле SourceStringHash — контрольная сумма исходного текста. Устройство формата и расчёт суммы можно посмотреть в UnrealLocres и его реализации CRC.
Это и позволило проверить гипотезу. Английская фраза у меня уже есть — её только что прочитал OCR. Можно посчитать её контрольную сумму и поискать соответствующую запись в файле.
Упрощённая схема поиска:
английский текст с экрана
          ↓
контрольная сумма по алгоритму Unreal
          ↓
запись в локальном каталоге
          ↓
русский текст + персонаж, если он указан
Восстанавливать оригинал из хеша не требуется. Проверяется уже известная строка. В рабочем приложении этот код написан на Swift; короткий эквивалент расчёта на Python выглядит так:
import zlib

def source_hash(text: str) -> int:
    utf16 = text.encode("utf-16-le")
    # Каждая 16-битная единица подаётся в CRC как четыре байта.
    data = b"".join(
        utf16[i:i + 2] + b"x00x00"
        for i in range(0, len(utf16), 2)
    )
    return zlib.crc32(data)
Здесь мешает любая мелочь: перенос строки, тире перед репликой, другая пунктуация. Приложение пробует ограниченный набор вариантов оформления. Есть и точечная поправка для случаев, когда OCR увидел цифру 1 вместо английского I перед глаголом.
Поиск использует контрольные суммы и ограниченный набор вариантов оформления строки. Если подходящие варианты дают разные русские переводы, приложение передаёт реплику локальному переводчику.
На 21 сохранённом фрагменте OCR из сцены с кораблём удалось найти 17 однозначных переводов. Для 11 фрагментов хватило данных, чтобы назначить голос персонажа с учётом правила коротких реплик. Замер сделан на сохранённом OCR одной сцены.
Качество самого каталога видно на двух примерах:
|
Английская реплика |
Текст из файла |
Персонаж |
|---|---|---|
|
|
Я попала, я попала! |
Зои |
|
|
Еще один корабль, убей его! |
Мио |
Вторая строка приведена как есть. В такой сцене хочется услышать «сбей его» или «уничтожь его», но приложение берёт именно то, что лежит в файле. Подключение готового перевода переносит ответственность за формулировки на его автора.
Кому каким голосом говорить
Для речи используется локальная модель Silero, сейчас v5_5_ru. Python-процесс загружает её один раз и остаётся работать между репликами. Это позволяет не тратить время на запуск модели перед каждой фразой.
В обычном режиме выбран один голос. Для диалогов из каталога можно назначить отдельные: сейчас для Мио стоит kseniya, для Зои — xenia. Это два готовых голоса синтезатора; голоса актрис я не клонировал.
С короткими репликами решил не угадывать. «Да», «Беги» или What!? могут встречаться у разных героев. Поэтому фразы длиной до трёх слов, а также реплики с неоднозначным или неизвестным говорящим звучат стандартным голосом.
Если готовый перевод найден уверенно, он идёт прямо в синтез. Если совпадения нет или варианты противоречат друг другу, включается запасной путь: Apple Translation, выбранный грамматический род и стандартный голос. Поэтому отсутствие строки в каталоге само по себе не превращается в тишину.
Готовые и автоматически переведённые реплики проходят одну очередь. У каждой сохраняется свой голос. Это понадобилось, в частности, для двух разных субтитров в одном кадре: второй не должен отменять первый только потому, что они пришли одновременно.
Сколько приходится ждать
В приложении есть счётчик «Кадр → звук». Он считает время от первого обработанного кадра с репликой до запуска её воспроизведения. Внутри этого интервала — стабилизация текста, OCR, перевод при необходимости, синтез и ожидание предыдущей речи.
Вот что получилось в сохранённых тестах на моём Mac:
|
Проверка |
Объём |
Результат |
|---|---|---|
|
Русские игровые субтитры → речь |
12 реплик с USB-захвата |
Медиана около 375 мс; диапазон 344–604 мс |
|
Английский субтитр на двух половинах экрана → русский текст в женском роде → речь |
Одна реплика с USB-захвата |
571 мс; две копии прочитаны один раз |
|
Поиск готового перевода |
21 сохранённый фрагмент OCR |
17 совпадений; среднее время самого поиска — 0,084 мс |
В первой строке я исключил из истории пробную фразу кнопки проверки голоса и распознанные пункты меню. Вторая строка — замер одной английской реплики. Третья показывает время поиска по каталогу, без захвата и воспроизведения.
Есть ещё задержки, которые счётчик не видит: прохождение сигнала через карту захвата, ожидание первой проверки кадра и физический буфер аудиоустройства. Только ожидание проверки при пяти запусках OCR в секунду может добавить до 200 мс. Показатель в таблице описывает именно обработку внутри приложения.
И самая заметная задержка бывает совсем не в OCR. Если первая фраза ещё звучит, второй приходится ждать. В отдельной проверке двух голосов, куда текст подавался без камеры, первая реплика начала играть через 141 мс, вторая — через 2179 мс: она дождалась окончания первой.
В очереди ограничено число ожидающих реплик, текст старше восьми секунд пропускается. Следующая фраза по возможности синтезируется, пока звучит текущая. Есть настройка прерывания новой репликой, но она обрывает предыдущую речь. Если игра выдаёт длинные диалоги быстрее, чем их можно произнести, настройкой OCR эту проблему не решить.
Как мы теперь играем
Мы уже играли с женой в Split Fiction с этой озвучкой. Всё работает: PS5 выводит игру на телевизор, MacBook получает картинку и читает реплики по-русски. Мы слышим диалоги на понятном языке и следим за тем, что происходит в игре.
И играть так — кайф. Ради этого всё и затевалось: проводить время вместе, понимать историю и получать удовольствие от игры.
За распознаванием текста, двумя половинами экрана и поиском перевода по контрольной сумме стояла простая задача — помочь нам поиграть вдвоём. Приложение эту задачу решило.
Промпт для своего агента
Чтобы собрать такое приложение у себя, можно передать этот промпт своему coding-агенту с доступом к терминалу на Mac и отдельной папке проекта. В нём собраны требования, которые у меня появлялись постепенно. Агенту достаётся сборка и настройка под ваше окружение, вам — подключение карты, системные разрешения и запуск игры.
Промпт: локальная озвучка субтитров с HDMI-захвата на Mac
Собери и запусти локальное приложение для macOS, которое получает видео с
USB-карты HDMI-захвата, распознаёт игровые субтитры и озвучивает их
по-русски. Мне нужен работающий проект, а не только план или пример кода.

Подключение: PS5 → HDMI IN карты; HDMI OUT карты → телевизор; USB карты →
Mac. Я играю на телевизоре, речь должна звучать на выбранном аудиовыходе
Mac. Используй стандартный видеозахват; доступ к файлам приставки не нужен.

Сначала изучи окружение, доступные инструменты и локальные инструкции
проекта. Проверь macOS, архитектуру, Swift/Python и реальные устройства
видеозахвата. Не включай встроенную камеру вместо отсутствующей USB-карты.
Название моей карты в системе было USB3.0 Video, но не привязывай код к
нему. Если карта не видна, продолжай сборку на тестовых кадрах и сообщи, что
нужно подключить для живой проверки.

Предпочтительная основа: SwiftUI, AVFoundation, Vision, Apple Translation;
Silero для русской речи через отдельный постоянный Python-процесс. Сверяй
API и поддержку языков с документацией. Ориентир — macOS 15+, новые API
включай с проверкой доступности. Если предложишь другой стек, объясни
практическую причину. Обработка видео, OCR, перевод и синтез должны работать
локально после скачивания зависимостей и моделей. Облачные API и платные
ключи не использовать.

Реализуй по этапам, оставляя после каждого запускаемую версию:

1. Захват и интерфейс. Выбор устройства, предпросмотр, старт/стоп. Начальная
область OCR — нижняя треть кадра; настройка высоты, нижнего и боковых
отступов с видимой рамкой. Разрешение камеры запрашивай через macOS. Потерю
устройства показывай явно. Не блокируй интерфейс обработкой кадров. Начни с
5 проверок OCR в секунду, дай диапазон 2–10; пропускай устаревшие кадры.

2. Русские субтитры и голос. Подтверждай текст минимум в двух наблюдениях и
жди примерно 0,24 секунды стабильности; параметры вынеси в настройки.
Загружай модель речи один раз. Предложи послушать локальные мужской и
женский голоса, добавь скорость, громкость и кнопку немедленной остановки
речи с очисткой очереди. Подготовку моделей показывай в интерфейсе.

3. Повторы. Нормализуй регистр, пробелы, переносы, пунктуацию и ё/е для
сравнения. Точные повторы подавляй до сброса памяти, включая
последовательность А → Б → А. При растущем субтитре читай только новую часть
при надёжном перекрытии. Небольшие ошибки OCR сравнивай осторожно: новые
числа, отрицания и короткие слова должны сохранять новую реплику. Добавь
явный сброс и объясни, что одинаковая команда позже тоже будет подавлена.
Определи и проверь поведение при отменённой или неудавшейся озвучке, чтобы
случайно не терять текст навсегда.

4. Разделённый экран. Режимы «один экран» и «два игрока слева/справа»,
регулируемая граница. Группируй найденный текст по координатам отдельно для
каждой стороны; общий субтитр через центр сохраняй целиком. Проверка
стабильности — по областям, память повторов — общая. Одинаковые фразы с двух
сторон читать один раз, разные — сохранить обе и озвучить последовательно.
Прерывание новой группой не должно отменять второй элемент этой же группы.

5. Английский → русский. Отсекай повторы до перевода. Подготовь языки Apple
Translation, покажи состояние загрузки и реальные ошибки. Не передавай
английский текст русскому голосу при сбое. Кешируй исходные переводы с
ограничением размера. Род перевода выбирается отдельно от тембра:
автоматически / женский / мужской. Для принудительного рода используй
локальный синтаксический и морфологический разбор, например Natasha и
pymorphy3. Согласовывай «я/ты» и допустимые неполные предложения, сохраняй
предметы, явное третье лицо, множественное число и средний род. Не делай
глобальную замену окончаний. Обозначь ограничения этой коррекции.

6. Необязательный каталог диалогов. Импорт локального JSON: название пакета
и массив записей id, source (английский), russian, speaker (необязательно).
Проверяй структуру, размеры и уникальность id. Если найдётся предоставленный
пользователем LOCRES с русскими строками и SourceStringHash, исследуй формат
и реализуй поиск по совместимой контрольной сумме Unreal; используй
проверяемые источники и реальные строки для проверки. Не выдумывай оригиналы
или персонажей. Для Split Fiction можно изучить опубликованный перевод
olddude: https://steamcommunity.com/sharedfiles/filedetails/?id=3441449608 .
Файлы перевода не обязательны для остальных режимов.

При надёжном совпадении бери готовый русский текст и назначенный голос
персонажа без повторного перевода и коррекции рода. Если совпадения нет или
найдены разные русские варианты — автоматически переводи через Apple
Translation, применяй выбранный род и стандартный голос. Реплики до трёх
слов и неоднозначный/неизвестный говорящий всегда используют стандартный
голос. Ограничь исправления OCR при поиске; не подставляй произвольную
похожую реплику. Добавь назначение голосов персонажам, проверку введённой
фразы и отображение источника перевода.

7. Очередь и измерения. Сохраняй порядок готовых и автоматически
переведённых реплик. Готовь следующую речь во время текущей, ограничь
ожидание двумя репликами и срок актуальности восемью секундами. Добавь
настройку прерывания. Смена языка, остановка и смена критичных настроек
должны отменять устаревшие результаты. Показывай OCR, перевод, синтез и
время от первого обработанного кадра до запуска аудио. Эта метрика не
включает задержку самой карты захвата, ожидание первой выборки и физического
аудиовыхода. Не называй её полной задержкой относительно телевизора.

Проверяй не только сборку. Нужны проверки повторов, растущих строк,
отрицаний и чисел; OCR двух одинаковых и двух разных субтитров на
разделённом экране; центрального субтитра; грамматического рода; известной,
неизвестной и неоднозначной строки каталога; переключения голосов и отмены
очереди. Используй подписанные синтетические кадры, затем реальные кадры и
звук с моего согласованного запуска игры. Не подменяй живой тест вводом
текста. Если оборудования сейчас нет, точно перечисли непроверенное.

Работай самостоятельно в папке проекта. Сообщай существенные результаты и
конкретные блокеры. Спроси меня, когда нужно запустить игру, выбрать
недоступный тебе источник или ответить на системный запрос. Не придумывай
показания устройств, прогресс скачивания, качество OCR и задержки. Подготовь
понятный запуск приложения и README: установка, модели и их
источники/лицензии, настройки, тесты, ограничения, реальные измерения.
Доведи доступные проверки до конца и оставь приложение готовым к совместному
тесту.
Если соберёте свою версию по промпту, расскажите в комментариях, в какую игру играли и как справилась озвучка.
Автор: zubinator
