
 GWT – отличный фреймворк. Я — Java-разработчик, и мне доводилось работать с тонкими клиентами с использованием JSP, JSF и GWT. Про JSP говорить особо нечего, технология сейчас практически вымерла, а вот в JSF-е пришлось повариться пару лет на двух проектах, и впечатления, мягко говоря, не из лучших: мешанина JSTL, HTML, JavaScript и прочего доставляет несказанное “удовольствие”, доходящее до экстаза в моменты разбора непонятного поведения какой-нибудь сложной страницы. Да, в примерах все выглядит аккуратно и просто, но реальная жизнь не такая, и JSF-страницы проекта даже среднего размера и, вроде бы, с грамотным неторопливым подходом при проектировании, с использованием шаблонов, все равно начинает “попахивать”, особенно в части читабельности. В GWT все достаточно аккуратно, ведь пишем на родном языке Java, пусть и в урезанном варианте, но того что есть более чем достаточно.Читать полностью »
Рубрика «java» - 265
GWT – подглядываем в передаваемые данные
2013-07-12 в 3:44, admin, рубрики: GWT, java, отладка, Песочница, Программирование, метки: GWT, java, отладкаСтатистика использования баз данных, серверов, версий Java и PHP в облаке
2013-07-11 в 9:29, admin, рубрики: couchdb, glassfish, java, Java 6, java 7, jetty, mariadb, mongo, mysql, php, php 5.3, php 5.4, postgres, tomcat, tomee, базы данных, Блог компании Jelastic, облако, Облачные вычисления, статистика, метки: couchdb, glassfish, java, Java 6, java 7, jetty, mariadb, mongo, mysql, PHP, php 5.3, php 5.4, postgres, tomcat, tomee, базы данных, облако, облачные вычисления, статистикаВсем привет! По многочисленным просьбам наших пользователей и читателей выкладываем статистические данные по использованию баз данных, серверов приложений, а также версий Java и PHP в облаке Jelastic. Данные собирались довольно простым образом: мы просто подсчитали количество наших пользователей, которые использовали тот или иной программный стек при создании окружений на платформе Jelastic за прошлый месяц (все тестовые аккаунты, конечно же, исключили). В статистической выборке учтены предпочтения более 5 000 активных пользователей. Также в данной статье можно отследить тренды за последний год для баз данных и всего, что касается Java, и за последние 5 месяцев для серверов приложений и версий PHP (так как поддержка PHP была реализована в конце января этого года).
Базы данных
Как видим, победитель среди баз данных вполне предсказуем – это MySQL (65%). С большим отрывом второе место занимает «сестра» MySQL – MariaDB, которую используют 12% наших пользователей. Тройку лидеров замыкают Postgres и Mongo – по 11% у каждой. Ну, и аутсайдер, нашего состязания — CouchDB, которая набрала всего один процент.

Изучаем Storm Framework. Часть I
2013-07-10 в 14:58, admin, рубрики: BigData, java, storm framework, параллельное программирование, метки: BigData, java, storm frameworkВ 2011 году Twitter открыл, под лицензией Eclipse Public License, проект распределенных вычислений Storm. Storm был создан в компании BackType и перешел к Twitter после покупки.
Storm это система ориентированная на распределенную обработку больших потоков данных, аналогичная Apache Hadoop, но в реальном времени.
Ключевые особенности Storm:
- Масштабируемость. Задачи обработки распределяются по узлам кластера и потокам на каждом узле.
- Гарантированная защита от потери данных.
- Простота развертывания и спровождения.
- Восстановление после сбоев. Если какой либо из обработчиков отказывает, задачи переадресуются на другие обработчики.
- Возможность написания компонентов не только на Java. Простой Multilang protocol с использованием JSON объектов. Есть готовые адаптеры для языков Python, Ruby и Fancy.
В первой части рассматриваются базовые понятия и основы создания приложения c использованием Storm версии 0.8.2.
Читать полностью »
Простой и быстрый фреймворк для стресс-тестирования приложений
2013-07-10 в 9:56, admin, рубрики: java, netty, performance tests, тестирование, метки: java, netty, performance tests, стресс-тестВеб-приложений под высокие нагрузки в последнее время создается все больше, но вот с фреймворсками позволяющими гибко их стресс тестировать — не густо. Их конечно много разных (см. голосование в конце поста) но кто-то куки не поддерживает, кто-то нагрузку слабую дает, кто-то очень тяжеловесен, да и годятся они в основном для совсем однотипных запросов, т.е. динамически генерить каждый запрос используя свою логику и при этом еще максимально быстро (и в идеале на java чтобы допилить если что) — не нашел таких.
Поэтому было решено писать свой. Основные требования: быстрота и динамическая генерация запросов. При этом быстрота это не просто тысячи RPS, а в идеале — когда стресс упирается только в пропускную способность сети и работает с любой свободной машины. Читать полностью »
Быстрый поиск в «Альфа-Клике»
2013-07-08 в 14:28, admin, рубрики: java, Альфа-Банк, Альфа-Клик, Блог компании «Альфа-Банк», Веб-разработка, интернет-банк, поиск, метки: Альфа-Банк, Альфа-Клик, интернет-банк, поискВсем привет! Меня зовут Тамара, я – разработчик интернет-банка «Альфа-Клик».
Недавно команда Альфа Lab запустила новый поиск по Клику. Ежедневно интернет-банком пользуются сотни тысяч клиентов, и даже такая, казалось бы небольшая, доработка упростит им жизнь и поможет быстрее найти нужную функцию или получателя платежей.
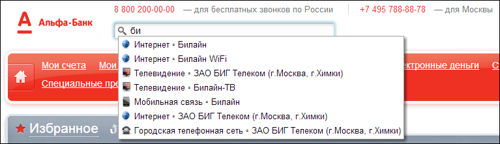
На Хабре много клиентов Альфы, и будет проще и быстрее спросить напрямую – как бы вы хотели пользоваться таким сервисом, какие функции вам были бы удобны и полезны? Предлагаю обсудить это в комментариях.
Несколько слов о том, как работает поиск и о его возможностях – под катом.
Читать полностью »
Много-файловое хранилище Java объектов в формате xml
2013-07-08 в 11:53, admin, рубрики: java, java objects xml store, java xml store, multifiles store, xdstore, XML, метки: java objects xml store, java xml store, multifiles store, xdstoreВведение
В программировании часто перед нами встают задачи, которые мы можем решить несколькими путями: найти и использовать уже готовые решения, или же решать задачу самостоятельно. Хоть и написано множество спецификаций и их реализаций, они не всегда дают нам то, что требуется в конкретном случае. Вот и мне в очередной раз пришлось столкнуться с подобной ситуацией.
Задача состояла в хранении объектов в файле в формате xml. Ничего казалось бы сложного, если бы не несколько «но». Объектов много, имеют они древовидную структуру и над ними постоянно выполняются операции добавления, изменения и удаления в разных потоках. Как вы понимаете постоянные запись и чтение большого xml файла довольно трудоемкая задача. Тем более если с одними и теми же данными работают несколько потоков. Так собственно и родилась идея написать много-файловое хранилище объектов в формате xml.
В этой статье я не буду рассматривать саму реализацию. Приведу лишь основные идеи и как использовать эту реализацию. Если вы хотите углубиться, то можете скачать посмотреть исходные коды.
Исходники доступны по ссылке: xdstore-1.3
Исходные тексты немного отличаются от приведенных в этой статье. В них были глубже проработаны исключительные ситуации, а именно, — для каждой операции, включая чтение, выбрасывается свое исключение. Также в последней версии реализована фрагментация.
Основная идея разработки
Главная идея заключается в том, чтобы объекты хранить не в одном файле, а в некотором множестве. При этом предоставить возможность настраивать политики хранения для каждого требуемого класса. Для класса можно установить одну из следующих политик:
- ParentObjectFile – объекты класса будут сохраняться в файле объекта владельца как дочерние элементы, эта политика применяется по умолчанию;
- SingleObjectFile – каждому объекту класса предоставляется отдельный файл, а в файле объекта владельца будет сохранена лишь ссылка на этот объект (в дальнейшем буду просто называть ее объектной ссылкой); все файлы каждого объекта будут сохраняться в отдельной папке внутри хранилища;
- ClassObjectsFile – все объекты этого класса будут храниться в отдельном файле, а в файлах объектов владельцев будут сохранены лишь объектные ссылки.
Под понятием объектной ссылки понимается объект указанного класса, у которого проставлено одно поле – идентификатор. В xml файле вместо полных данных этого объекта сохраняется лишь имя класса и идентификатор, чтобы в дальнейшем по этой ссылке можно было получить все данные. Загрузка таких объектов подобна поздней инициализации в hibernate.
Сохраняемые объекты должны быть реализованы как JavaBeans с методами get(is) и set для сохраняемых полей.
PowerMock(+Mockito) +TestNG и имитация вызова (mock) статических методов
2013-07-07 в 19:32, admin, рубрики: java, maven, mockito, PowerMock, примеры кода, Программирование, тестирование, метки: java, maven, mockito, PowerMock, примеры кода, Программирование, тестированиеНа хабре уже была статья с примерами использования PowerMock, но в ней не хватает такого описания, как имитации вызова статических методов как самостоятельных «единиц» в классе, так и в гибридном использовании, когда часть статических методов у класса подменяются «заглушкой», а часть вызываются реально. Попробую исправить эту нишу.
Для начала создадим демонстрационный класс со статическими методами (commit):
public class ClassStatic {
	static String getValue() {
		return "value";
	}

	static String getValue(final String s) {
		return getValue() + s;
	}
}
RMI для нескольких сетевых интерфейсов
2013-07-05 в 16:32, admin, рубрики: java, rmi, Сетевые технологии, метки: java, rmi Здравствуй!
В ходе работы появилась задача создать несколько RMI реестров, доступных через разные сетевые интерфейсы (локальная сеть и интернет). И к моему удивлению я ничего толком не нашел в сети по этому вопросу. Поэтому разобравшись сам, решил поделиться решением с людьми.
Дано
Сервер с двумя сетевыми интерфейсами: локальный и внешний IP-адреса. Интерфейс, используемый клиентом и реализуемый сервером:
public interface Server extends Remote {
    public String getMessage() throws RemoteException;
}
Задача
Создать два RMI реестра, каждый для своего сетевого интерфейса.
Читать полностью »
Организуем поиск молекулярных структур с помощью Lucene и Chemistry Development Kit
2013-07-03 в 12:45, admin, рубрики: Chemistry, java, lucene, Песочница, Поисковые машины и технологии, метки: chemistry, java, lucene Библиотека полнотекстового поиска Lucene предоставляет возможность организовать поиск по текстовым документам. Существуют так же средства, с помощью которых можно организовать поиск «похожих» химических структур, например, OpenBabel. Иногда может возникнуть потребность объединить эти два вида поиска в единой «канве». Например, если нужно создать систему, которая может отвечать на такие запросы: найти вещество, в текстовом описании которого есть слово «аминокислота», структурно похожее на индол (ожидается, что мы найдём аминокислоту триптофан). В этой статье описано решение данной задачи на основе полнотекстового движка Lucene.
Читать полностью »
JAXB и XSLT с использованием StAX
2013-07-02 в 15:10, admin, рубрики: java, JAXB, XML, xslt, метки: java, JAXB, XML, xslt В одном из проектов понадобилось обрабатывать большие XML файлы, от сотен мегабайт до десятков гигабайт.
Причем выдернуть надо было только некоторые тэги с расположенные на различной «глубине». XSLT «в лоб» ломался от недостатка памяти. Пришлось подумать и вспомнить о потоковом парсере.
Читать полностью »