
Рубрика «интерпретируемость»
Я подсвечивал нейроны крохотного ИИ, чтобы понять, когда тот врет
2026-10-28 в 8:00, admin, рубрики: AI, llm, logit lens, ml, pytorch, qwen2.5, residual stream, галлюцинации, детектор лжи, интерпретируемость
Что скрывают в себе меры расстояния: от kNN и k‑means до стилометрии
2026-09-29 в 13:07, admin, рубрики: k-means, KNN, nlp, интерпретируемость, кластеризация, косинусное расстояние, машинное обучение, метрики расстояния, стилометрияПредставим, что kNN отнес новую точку к некоторому классу. Пусть для простоты это будет 1-NN, в котором решение базируется на одном ближайшем соседе. Возьмем точку  и двух кандидатов: Читать полностью »
Почему нейробиологи 60 лет назад понимали мозг лучше, чем мы понимаем нейросети
2026-09-24 в 9:14, admin, рубрики: computer vision, machine learning, xai, интерпретируемость, контурные методы, нейронаука, разреженные автокодировщикиКонец 1950-х, Гарвард, лаборатория Дэвида Хьюбела и Торстена Визеля. Кошке под наркозом через слайд-проектор показывают полоски света, а электрод фиксирует, как на это откликается отдельный нейрон зрительной коры. Никаких компьютеров, только аналоговые инструменты. Но из этого вырос один из главных результатов в истории нейробиологии: открытие нейронов зрительной коры, избирательно реагирующих на ориентацию. За него Хьюбел и Визель позже получили Нобелевскую премию.
Как сделать нейросети понятнее: эксперимент OpenAI с разреженными моделями
2025-11-14 в 9:57, admin, рубрики: attention, circuits, mechanistic-interpretability, OpenAI, sparse-transformer, архитектура-моделей, интерпретируемость, разреженные-модели, цепочки-вычисленийКоманда AI for Devs подготовила перевод исследования OpenAI о том, как обучение разреженных моделей может сделать ИИ более прозрачным. Авторы показывают: если заставить модель использовать меньше связей, внутри неё появляются понятные цепочки вычислений, которые можно изучать и проверять. Это может стать шагом к созданию мощных, но интерпретируемых систем.
Circuit Tracing: как заглянуть в галлюцинации модели и найти там смысл
2025-09-26 в 18:30, admin, рубрики: circuit, llm, rag, tracing, transcoder, атрибуционная модель данных, галлюцинации, граф, детектор, интерпретируемость
Геометрия ландшафта потерь и «понимание» нейросети
2025-05-02 в 9:23, admin, рубрики: flat minima, PAC-Bayes, Гессиан, интерпретируемость, ландшафт ошибки, машинное обучение, нейросети, обобщение, функция потерьВведение
Когда нейросеть обучается, ее функция потерь образует сложный ландшафт в пространстве параметров – с вершинами (области высокой ошибки) и долинами (области низкой ошибки). Свойства этого ландшафта – его кривизна, форма минимальных долин, спектр матрицы Гессе и пр. – могут многое рассказать о том, насколько модель усвоила закономерности данных. Идея состоит в том, что не все минимумы одинаковы: одни могут быть «плоскими» (широкими и неглубокими), другие «острыми»Читать полностью »
Новый подход к пониманию мышления машин
2019-02-15 в 10:57, admin, рубрики: Google Brain, интерпретируемость, искусственный интеллект, машинное обучениеНейросети известны своей непостижимостью – компьютер может выдать хороший ответ, но не сможет объяснить, что привело его к такому заключению. Бин Ким разрабатывает «переводчик на человеческий», чтобы, если искусственный интеллект сломается, мы смогли это понять.
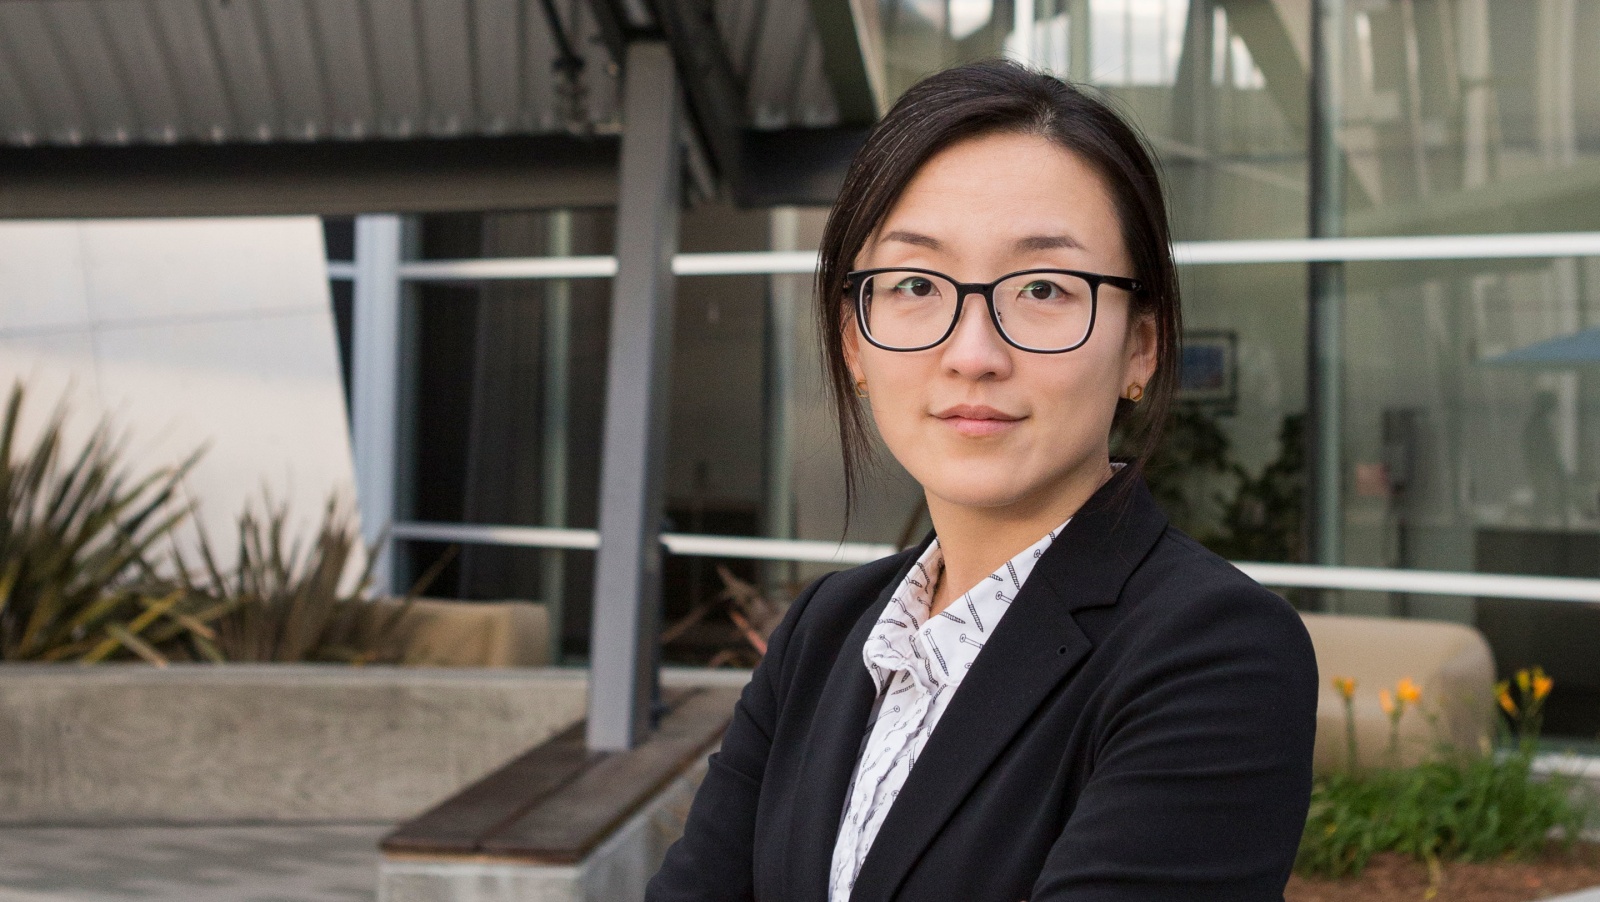
Бин Ким, исследователь из Google Brain, разрабатывает способ, который позволит расспросить систему, использующую машинное обучение, по поводу принятых ею решений
Если доктор скажет вам, что вам нужна операция, вы захотите узнать, почему – и вы будете ожидать, что его объяснение покажется вам осмысленным, даже если вы не обучались на врача. Бин Ким [Been Kim], исследователь из Google Brain, считает, что мы должны иметь возможность ожидать того же от искусственного интеллекта (ИИ). Она — специалист по «интерпретируемому» машинному обучению (МО), и хочет создать ИИ, который сможет объяснять свои действия кому угодно.
Читать полностью »