Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения. В данном выпуске достаточно много интересных материалов для новичков. Присутствует пара интересных видеоматериалов. Есть материалы по теме Data Engineering. Как обычно некоторые количество статей посвящено примерам кода, связанного с анализом данных и машинным обучением. И уже традиционно несколько статей посвящено теме участия в соревнованиях по машинному обучению.
Рубрика «big data» - 128
Обзор наиболее интересных материалов по анализу данных и машинному обучению №10 (18 — 25 августа 2014)
2014-08-25 в 6:18, admin, рубрики: big data, data mining, data science, data science digest, machine learningКак проиндексировать логи бизнес приложений в Hadoop (SolrCloud)
2014-08-20 в 16:16, admin, рубрики: big data, Hadoop, logs, logs логи, solrВведение
У одного из наших клиентов возникла задача вынести логи из большинства корпоративных приложений и их баз данных «куда-нибудь» — уж больно с ними много возни: растут как на дрожжах, чисти их периодически, а к некоторым еще и доступ должен быть обеспечен в течение многих лет, да еще и анализ хочется проводить системным образом. Конечно же, вынести логи – это не первичная цель, и по совокупности требований мы выбрали Hadoop, версию от Cloudera (CDH 5).
Требования указывали, что решение, помимо прочего, должно предоставлять возможность поиска и просмотра списка событий (из логов) по заданным критериям, причем желательно быстрого. Причем некоторые приложения также должны быть переделаны, чтобы формы просмотра логов стали использовать Hadoop вместо своих баз данных.
Как одно из решений — использовать поисковый модуль SolrCloud, который входит в комплект Hadoop от Cloudera. В Cloudera «из коробки» входят тулзы для выгрузки данных из баз данных приложений и их индексации пачкой (не построчно). Однако такой способ оказался хоть и рабочим, но более трудоемким и непредсказуемым в настройке, чем, скажем, если бы мы использовали Impala для выборки данных. Поэтому я решил поделиться как мы это делали, в надежде сэкономить время тем, кто столкнется с похожей задачей.
Эта статья описывает детали настройки, а также встреченные в процессе работы особенности.
Читать полностью »
Обзор наиболее интересных материалов по анализу данных и машинному обучению №9 (11 — 18 августа 2014)
2014-08-18 в 8:17, admin, рубрики: big data, data mining, data science, data science digest, machine learning 
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения. В данном выпуске достаточно много интересных видеоматериалов. Некоторые количество материалов посвящено теме Data Engineering. В данном выпуске достаточно много практических примеров кода на языках программирования R и Python. Как обычно много материалов посвящено алгоритмам машинного обучения.
Роза кишечных бактерий
2014-08-11 в 7:18, admin, рубрики: big data, data mining, dataviz, Блог компании Лаборатория данных, визуализация данных, генетика, Лаборатория данных, метагеномНаучные задачи, связанные с обработкой и визуализацией сложных данных, — одни из самых нетривиальных и интересных. В научных экспериментах накапливаются огромные объёмы данных с разнообразными измерения и параметрами, характерными для конкретной области знаний, зачастую взаимосвязанными. При этом удобный и наглядный способ интерпретации этих данных быстро приводит к результату и наглядно демострирует его заинтересованным лицам — а там и до важного открытия рукой подать. Вспомните таблицу Менделеева, диаграммы Фейнмана, спектральные серии веществ, геномные схемы ДНК, карты реликтового излучения.
Я расскажу о научной задаче, с которой нам в Лаборатории данных посчастливилось работать. Мы придумали и реализовали инструмент для сравнения филогенетического расстояния образцов микробиоты и назвали его розой кишечных бактерий:

Обзор наиболее интересных материалов по анализу данных и машинному обучению №8 (4 — 11 августа 2014)
2014-08-11 в 6:47, admin, рубрики: big data, data mining, data science, data science digest, machine learning 
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения. В данном выпуске достаточно много практических примеров кода на языках программирования R и Python. Также в данном обзоре есть достаточно много статей, которые будут интересны новичкам. Несколько статей посвящено онлайн-курсам. Как обычно много материалов посвящено алгоритмам машинного обучения

8 августа 2014 года вышла новая версия HP Vertica 7.1. Команда Майкла Стоунбрейкера продолжает утверждать, что работа с большими данными сродни БАМу и продолжает новым версиям выдавать названия с строительной тематикой. Итак, Бульдозером (6 версия) по таблицам данные разровняли, сверху неструктурированными данными во Flex зону приложили (версия 7.0), пришла пора большого Экскаватора повернуть реки вспять. Встречаем версию Dragline 7.1! В этой статье я опишу, что же изменилось в новой версии.
Расширения функциональности проекций
Напомню для тех, кто в курсе и расскажу для тех, кто не знает: проекцией в Vertica называется материализация данных таблицы. Таблица в Vertica это описание структуры таблицы (столбцов), constraints и партиций. А непосредственно данные хранятся в проекциях, которые создаются на таблицы. Проекции чем-то похожи на индексы, они хранят данные по всем или не всем столбцам таблицы. Может быть более одной проекции на таблицу, проекции могут хранить отсегментированные и отсортированные данные по разным правилам. Данные во всех проекциях автоматически обновляются при обновлении записей таблицы. Фактически проекции содержат данные таблицы полностью всех колонок или частично определенных колонок. Жертвуется дисковое место серверов кластера, но значительно ускоряются выборки для разных групп запросов.
Выражения в проекциях
До новой версии в проекциях можно был указать исключительно только колонки таблицы. Это накладывало определенные ограничения на использование проекций. Например, если в запросах часто в фильтрации использовалось выражение по колонкам таблицы, поиск по этому фильтру не был максимально эффективным за счет того, что в проекции не было возможности указать сортировать хранимые данные по выражению. Сортировка же по столбцам выражения вряд ли помогла повысить производительность. Это могло вылиться в достаточно серьезную проблему. В качестве решения потребовалось бы добавить в таблицу новую колонку, в которую можно сохранять результат вычисления. Так же потребовалось изменить алгоритм загрузки в эту таблицу данных первоисточников, чтобы во время загрузки заполнять вычисляемый столбец. Так же пришлось бы перегружать всю таблицу, чтобы заполнить добавленное поле. Если в таблице десятки и сотни миллиардов записей и в нее идет постоянная загрузка, такое решение физически было бы невыполнимо.
В новой версии для проекций введена возможность указать как столбцы, так и выражения:
CREATE PROJECTION sales_proj (sale_id, sale_count,  sale_price, sale_value) AS
  SELECT sale_id, sale_count, sale_price, sale_count * sale_price
  FROM sales
  ORDER BY sale_count * sale_price
  SEGMENTED BY HASH(sale_id) ALL NODES KSAFE 1;
Следующий запрос:
SELECT *, sale_count * sale_price AS value
FROM sales
WHERE value > 1000000
ORDER BY value;
при выполнении использует созданную проекцию и фактически моментально отдаст результат, используя сортировку выражения.
На такие проекции накладываются следующие ограничения:
- Нельзя использовать функции, которые могут изменить результат (например функцию TO_CHAR, так как она вернет разный результат в зависимости от выставленной кодировки клиента)
- Нельзя использовать служебные мета функции
- Нельзя обновлять записи таблицы оператором MERGE (UPDATE и DELETE разрешены)
Проекции такого типа можно создать и перестраивать на таблицу в любой момент времени, без остановки работы с ней пользователей и загрузки данных. Таким образом, проблема включения вычисляемого столбца в сортировку для повышения производительности запросов более не актуальна.
Читать полностью »
Made with IBM: где используются технологии IBM?
2014-08-09 в 10:27, admin, рубрики: big data, ibm watson, Блог компании IBM, Большие данные, облака, Облачные вычисления 
Не так давно в блоге IBM публиковалось несколько постов, в которых показывались возможности суперкомпьютера Watson и сферы практического применения этих возможностей. Вот первый пост по этой теме, а вот второй.
И в первой, и во второй записи упоминался не только Watson, но и другие технологии корпорации, включая IBM Cloud. Сейчас мы хотим показать области применения и других сервисов/технологий. И само собой, такая демонстрация возможностей будет проводиться на практических примерах.
Социально-культурная миграция 2600-летнего периода истории в 5 минутах: познавательная визуализация
2014-08-07 в 12:17, admin, рубрики: big data, анализ данных, Анимация и 3D графика, визуализация, визуализация данных, культура 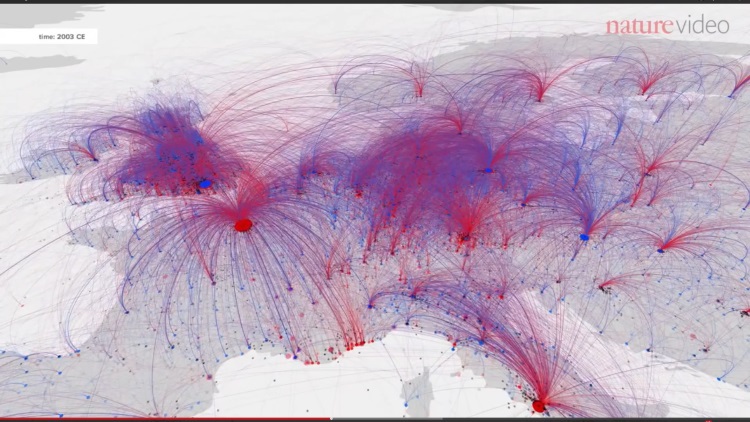
Все дороги ведут в Рим — так было когда-то. Сейчас дороги ведут во многие места, и люди более-менее свободно путешествуют по миру, с целью обретения либо второй родины, либо просто места для комфортной жизни.
Maximilian Schich, историк из Техасского Университета в Далласе, использовал данные огромной базы данных Freebase для поиска путей миграции 120 тысяч человек, мыслителей, ученых, представителей культуры, с древних времен по наши дни.
Восстановление данных из внутренней памяти на Android для чайников
2014-08-06 в 7:02, admin, рубрики: android, big data, Восстановление данных, чайник - чайникуСейчас всё больше смартфонов идут без слота для sd-card, и информацию приходится хранить на встроенной памяти с доступом к ней по MTP. Такой режим подключения не позволяет стандартными средствами восстановить данные телефона после waip’а или случайного удаления.
Сегодня на примере связки Xiaomi Mi2s и Windows 8.1 я постараюсь рассказать, как можно восстановить утерянные данные, кому интересно, добро пожаловать под кат.
Читать полностью »
Эволюция списка рекомендаций в SmartProgress
2014-08-05 в 9:11, admin, рубрики: big data, data mining, smartprogress, Блог компании SmartProgress, рекомендательная системаВыборка наиболее интересного пользовательского контента для пользователей — актуальная задача для многих проектов, и мы не исключение. В этой статье я хочу рассказать про то как мы решали эту задачу с момента старта проекта и до сегодняшнего дня на примере списка целей в SmartProgress.