Рубрика «big data» - 127

IBM Watson становится ближе к бизнесу и обычным пользователям

Компания IBM представляет Watson Analytics – инновационный когнитивный сервис, способный понимать естественные языки, который предоставляет непрерывный доступ к мощным средствам предиктивной и визуальной аналитики. Согласно данным исследований, лишь небольшая часть бизнес-пользователей использует средства аналитики с целью принятия решений. В свою очередь, сервис Watson Analytics предоставляет возможность упрощенной и удобной работы со средствами предиктивной аналитики любым категориям пользователей.

Первая версия Watson Analytics будет представлять собой условно-бесплатный сервис, совместимый с настольными ПК и мобильными устройствами. Watson Analytics предлагает полный спектр инструментов аналитики, включая организацию удобного доступа к сервисам уточнения и хранения данных, позволяя, таким образом, собирать информацию и готовить отчеты в сложных форматах для последующего анализа и визуализации, а также принятия решений и взаимодействия.
Читать полностью »

Добрый день!

Cybercortex.org — open source проект. Находится на этапе старта и видится как возможность сконцентрировать и скоординировать усилия компаний и разработчиков для решения задач по развитию интеллекта человека. Для внедрения в быт новых форм усиления мышления и ускорения продуктивной коммуникации. Поэтому все, кто так или иначе заинтересован в вопросе, приглашаются к сотрудничеству.

Ниже представлено описание первого модуля алгоритма Cybermean, «ядра» Cybercortex. Если описанная ниже логика будет представляться хабравчанам адекватной, то можно было бы продолжить описание и обсуждение модулей Cybermean и Cybercortex в целом. Также, в конце поста, помимо логики первого модуля, приводится изображение связи интерфейсов в рамках Cybercortex, в качестве дополнительного наглядного материала, характеризующего тематику проекта.

image
Читать полностью »

Привет!

Что дают человечеству открытые данные? В этом году они помогли воссоздать Данию в Майнкрафте – достижение интересное, но вряд ли значимое для простого обывателя. Данные позволяют сравнить города по определенным параметрам, узнать мнения людей о них (выгрузив те же твиты с геолокацией), узнать о передвижении людей (данные с навигационных сервисов), после чего их можно использовать для улучшения жизни – например, для снижения нагрузки на дороги.

Интересное исследование я вчера услышал на одном мероприятии: проанализировав передвижение автомобилей по Москве, команда разработчиков платформы для такого анализа выяснила, что новые шоссе в этом городе не решат проблему пробок. Потому как по городу люди движутся абсолютно хаотично, так что для устранения проблемы необходимо строить «капиллярные» сети дорог. С другой стороны, в Московской области все передвигаются именно по основным дорогам.

Это лишь один из способов практического использования открытых данных. Можно долго говорить еще и о том, как эти данные помогут продавать что-либо, но меня интересует вопрос чуть более гуманитарный – вопрос улучшения жизни, безопасности и так далее.

Как открытые данные помогут предсказать преступления

Читать полностью »

Обзор наиболее интересных материалов по высокой производительности (15 — 21 сентября 2014)
Представляю вашему вниманию первый выпуск обзора наиболее интересных материалов по высокой производительности. Когда я готовил очередной выпуск обзора наиболее интересных материалов по анализу данных и машинному обучению, то понял, что выделяется вполне себе самодостаточная тематика собранных материалов. Надеюсь, что данный тип обзоров будет тоже полезен и интересен. Буду стараться расширять список ресурсов за которыми слежу при подготовке данных обзоров.
Читать полностью »

Обзор наиболее интересных материалов по анализу данных и машинному обучению №14 (15 — 21 сентября 2014)
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения. Хочу также обратить внимание, что я выпустил первый дайджест по теме высокой производительности и Data Enginering: Обзор наиболее интересных материалов по высокой производительности (15 — 21 сентября 2014). Думаю, что кого-то он тоже может заинтересовать.
Читать полностью »

Приглашаем на HadoopKitchen

Спешим сообщить вам о нашей новой инициативе, которая будет интересна как программистам, так и ряду других IT-специалистов: 27 сентября, в следующую субботу, в московском офисе Mail.Ru Group состоится первая встреча HadoopKitchen. Почему именно Hadoop и чем эта встреча может быть интересна непрограммистам?

  • Hadoop является центром настоящей экосистемы, с ним связаны многочисленные проекты и технологии.
  • Многие компании целиком полагаются на коммерческие дистрибутивы Hadoop.
  • Hadoop входит в продуктовые линейки почти всех крупных поставщиков информационных технологий, что говорит о его востребованности и популярности.

Программа первой Hadoop-встречи будет очень насыщенной, выступят аж четыре докладчика. Все они замечательные специалисты с большим опытом, которым хотят поделиться с аудиторией. Под катом читайте программу мероприятия и анонсы докладов.
Читать полностью »

Эта статья нацелена на Большие и Очень большие Хранилища Данных, но для ровной картины в классификации немного упомянуты и маленькие.

Статья написана для специалистов, которые ценят главный критерий работы с базами данными — скорость. Речь пойдет о системах, нацеленных на грубый full scan (ораклисты уже напряглись, а терадатовцы радуются).

Давайте рассмотрим, под какой объем данных и работ лучше всего подходит Oracle или Hadoop/NoSQL.
Читать полностью »

Обзор наиболее интересных материалов по анализу данных и машинному обучению №11 (25 августа — 1 сентября 2014)
Представляю вашему вниманию очередной выпуск обзора наиболее интересных материалов, посвященных теме анализа данных и машинного обучения. В данном выпуске достаточно много разноплановой информации. Есть много статей, посвященных теме Data Engineering. Есть материалы для новичков и несколько видеолекций. Как обычно упоминаются соревнования по машинному обучению на Kaggle. Интересная статья про стартапы в области Data Science. Любопытная статья про улучшение игрового AI при помощи использования машинного обучения.

Читать полностью »

image

Введение

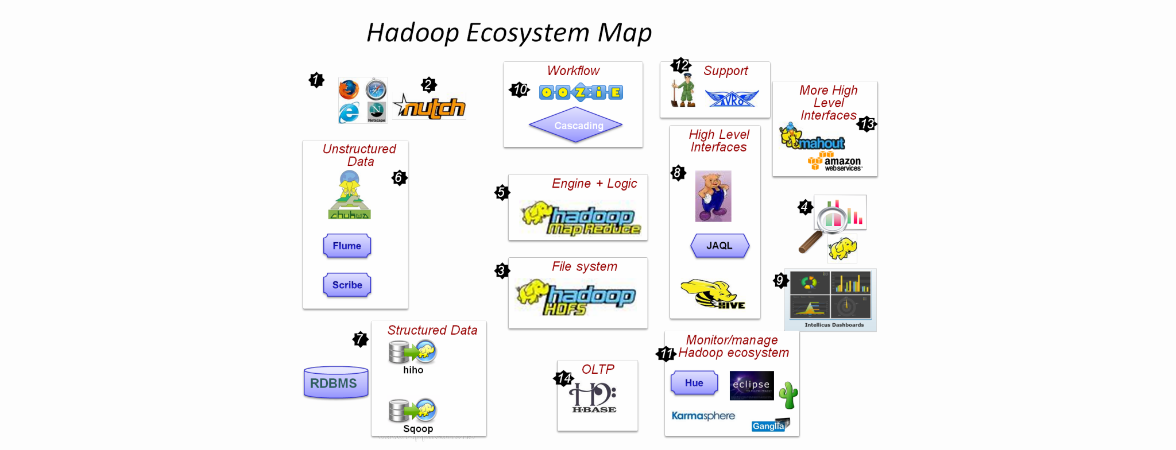
Как человеку с не очень устойчивой психикой, мне достаточно одного взгляда на картинку, подобную этой, для начала панической атаки. Но я решил, что страдать буду только сам. Цель статьи — сделать так, чтобы Hadoop выглядел не таким страшным.

Что будет в этой статье:

  • Разберем, из чего состоит фреймворк и зачем он нужен;
  • разберем вопрос безболезненного развертывания кластера;
  • посмотрим на конкретный пример;
  • немного коснемся новых фич Hadoop 2 (Namenode Federation, Map/Reduce v2).
Чего не будет в этой статье:

  • вообще статья обзорная, поэтому без сложностей;
  • не будем лезть в тонкости экосистемы;
  • не будем зарываться глубоко в дебри API;
  • не будем рассматривать все околоdevops-задачи.

Читать полностью »

Повышение конверсии с помощью Big Data: 9 платформ прогнозной аналитики Прогнозная аналитика — это технология, опирающаяся на большие массивы данных для прогнозирования будущего поведения людей с целью принятия оптимальных решений. Она задействует множество методов из статистики, интеллектуального анализа данных, учитывает как текущие данные, так и данные за прошлые периоды, на основе которых составляет прогнозы о будущих событиях. В бизнесе модели прогнозирования используют паттерны, составленные на основе данных за определенный период, чтобы оценить потенциальные риски и возможности. Модели выявляют связи среди многих факторов, чтобы сделать возможной оценку рисков или потенциала, связанного с конкретным набором условий. Итогом использования прогнозной аналитики является принятие верных (максимально эффективных для бизнеса) решений.

Как прогнозная аналитика может пригодиться e-commerce?

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js