В сентябре 2026 года на Hugging Face есть 3 модели, которые хочется поставить на пару DGX Spark под Claude Code: DeepSeek‑V4.1-Flash на 552B, GLM-5.3-Flash на 320B и Qwen3.8-Flash‑Next на 125B. Первая лучше всех в бенчмарках, но не помещается в 243 ГиБ даже в 4 битах. Вторая занимает 198 ГБ и грузится 15 минут. Третья влезает в один спарк — если не считать 2 ГБ, которых ей не хватает. Ниже — почему на этом кластере выбор делает арифметика памяти, а не таблица бенчмарков, почему 6 миллиардов активных параметров не дают 90 ток/с, и почему для Claude Code решающим оказывается не tok/s, а один флаг vLLM, который в самом быстром конфиге выключен.
Рубрика «prefix caching»
Выбор агентской модели для кластеров из 2× DGX Spark (сентябрь 2026)
2026-09-24 в 15:06, admin, рубрики: claude code, DGX Spark, gb10, NVFP4, prefix caching, vllm, локальные llm, спекулятивное декодирование, тензорный параллелизмСвой инференс для 25 разработчиков: 452:1, KV‑пул и почему это не экономит денег
2026-08-22 в 12:05, admin, рубрики: claude, kv-cache, LiteLLM, prefix caching, qwen, RTX PRO 6000, vllm, агентская разработка, локальные llmВсе цифры сняты с работающего стенда: потребление токенов — за календарную неделю по данным шлюза, метрики движка — кумулятивно за период аптайма (11 426 обработанных запросов). Продолжение — про выбор модели по замерам, а не по бенчмаркам — будет отдельной статьёй.
Для кого эта статья
Для тех, кто держит или собирается держать LLM внутри контура: тимлидов, DevOps, архитекторов. Здесь конфиги, цифры и грабли, а не введение в трансформеры.
KV-Cache в LLM: разбираем инференс через 9 ключевых вопросов
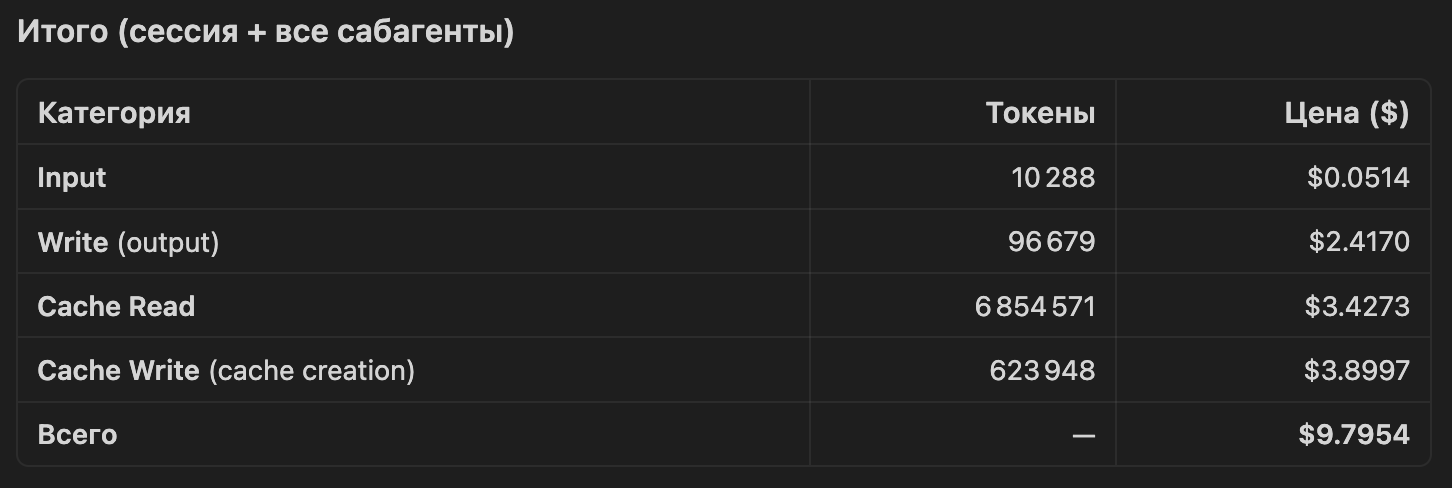
2026-04-10 в 11:21, admin, рубрики: attention, gpu, kv-cache, llm, prefix caching, prompt caching, Transformers, vllm, машинное обучение, машинное обучение. нейросетиНе так давно лимиты на использование Claude Code резко уменьшились, и люди стали лучше считать свои токены. Я не стал исключением, поэтому первым делом собрал информацию по использованию токенов в своих сессиях и посмотрел, что и сколько бы стоило, если бы отправлял это через API.