Рубрика «prompt caching»
KV-Cache в LLM: разбираем инференс через 9 ключевых вопросов
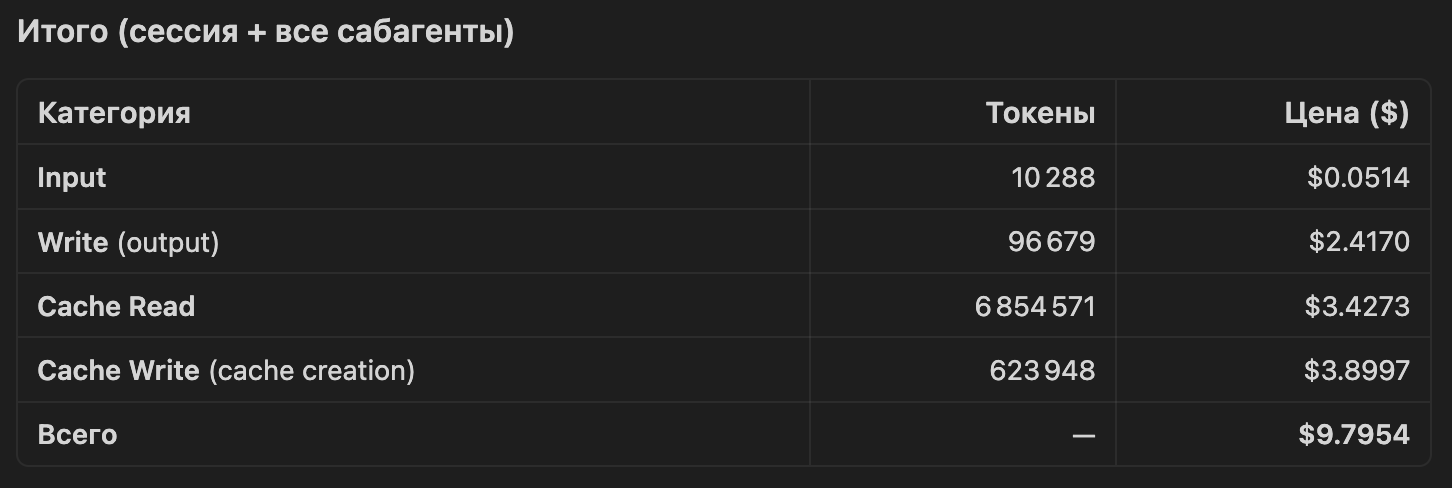
2026-04-10 в 11:21, admin, рубрики: attention, gpu, kv-cache, llm, prefix caching, prompt caching, Transformers, vllm, машинное обучение, машинное обучение. нейросетиНе так давно лимиты на использование Claude Code резко уменьшились, и люди стали лучше считать свои токены. Я не стал исключением, поэтому первым делом собрал информацию по использованию токенов в своих сессиях и посмотрел, что и сколько бы стоило, если бы отправлял это через API.