В сентябре 2026 года на Hugging Face есть 3 модели, которые хочется поставить на пару DGX Spark под Claude Code: DeepSeek‑V4.1-Flash на 552B, GLM-5.3-Flash на 320B и Qwen3.8-Flash‑Next на 125B. Первая лучше всех в бенчмарках, но не помещается в 243 ГиБ даже в 4 битах. Вторая занимает 198 ГБ и грузится 15 минут. Третья влезает в один спарк — если не считать 2 ГБ, которых ей не хватает. Ниже — почему на этом кластере выбор делает арифметика памяти, а не таблица бенчмарков, почему 6 миллиардов активных параметров не дают 90 ток/с, и почему для Claude Code решающим оказывается не tok/s, а один флаг vLLM, который в самом быстром конфиге выключен.
Рубрика «vllm»
Выбор агентской модели для кластеров из 2× DGX Spark (сентябрь 2026)
2026-09-24 в 15:06, admin, рубрики: claude code, DGX Spark, gb10, NVFP4, prefix caching, vllm, локальные llm, спекулятивное декодирование, тензорный параллелизмСвой инференс для 25 разработчиков: 452:1, KV‑пул и почему это не экономит денег
2026-08-22 в 12:05, admin, рубрики: claude, kv-cache, LiteLLM, prefix caching, qwen, RTX PRO 6000, vllm, агентская разработка, локальные llmВсе цифры сняты с работающего стенда: потребление токенов — за календарную неделю по данным шлюза, метрики движка — кумулятивно за период аптайма (11 426 обработанных запросов). Продолжение — про выбор модели по замерам, а не по бенчмаркам — будет отдельной статьёй.
Для кого эта статья
Для тех, кто держит или собирается держать LLM внутри контура: тимлидов, DevOps, архитекторов. Здесь конфиги, цифры и грабли, а не введение в трансформеры.
«Тосок бессмысл»: как я не смог заставить Gemma 4 писать хорошие стихи
2026-08-12 в 7:03, admin, рубрики: gemma, llm, lora, reward hacking, vllm, генерация стихов, ограниченное декодирование, рифма, силлабо-тоника, файнтюнингВсем привет! Меня зовут Даниил Шеремет, я AI-инженер в Agentic Lab. Днём я проектирую агентные системы, а по вечерам весь последний месяц жёг GPU-часы, пытаясь заставить Gemma 4 писать русские стихи — с правильным ямбом, честной рифмой и хоть каким-то смыслом.
Ускорение инференса энкодерной guard‑модели: TensorRT, Triton, vLLM, Ray Serve
2026-08-05 в 11:26, admin, рубрики: gliner guard, gliner2, guardrails, Nvidia, tensorrt, triton-inference-server, vllm, инференс нейросетейКогда в системе есть узел между LLM и пользователем его скорость также важна, как и скорость самой LLM. Когда этот узел сам является моделью (и иногда даже — тоже LLM) — задача ускорения становится совсем веселой и её нужно уметь решать разными способами. В этой работе я опишу процесс ускорения guardrail‑модели — узла, которые проверяет — нет ли на входе или выходе опасного контента.
vLLM vs LMDeploy vs Triton: обзор бэкендов для инференса LLM
2026-07-18 в 8:00, admin, рубрики: lmdeploy, ml, mlops, Nvidia, selectel, triton-inference-server, vllm
Лучший способ сжечь бюджет компании на инфраструктуру — запуск LLM в продакшене. Но только если вы не знаете, какой бэкенд использовать и как его настраивать.
Как я разогнал Qwen3.6-27B до 73 токен-с в llama.cpp: параметры, которые реально работают
2026-06-02 в 12:57, admin, рубрики: AI, javascript, llama.cpp, llm, vllmЛокальные LLM сейчас — это действительно мощный инструмент. Они уже вплотную приблизились к проприетарным моделям вроде Claude, особенно в задачах кодинга. Я сам активно использую локальные модели для разработки на TypeScript и Go.
На данный момент самая интересная модель для моего стека — Qwen3.6-27B. Но один только выбор хорошей модели ничего не гарантирует. Без правильных параметров вы не получите ни скорости, ни качества.
В этой статье я расскажу, с какими конкретно параметрами запускаю Qwen3.6-27B в llama.cppЧитать полностью »
Как я собрал на DGX Spark приватный AI-сервер, и теперь рассказываю, что туда вошло
2026-05-03 в 9:15, admin, рубрики: arm64, DGX Spark, Dify, gb10, llm, rag, ragflow, vllmУ меня на столе стоит небольшая золотистая коробочка размером чуть больше Mac mini. Внутри — приватный AI-сервер: чат с локальной 26B-моделью, поисковая индексация моих документов с GPU-парсингом, конструктор агентов в Dify, RAGFlow для тяжёлого парсинга PDF, мониторинг, бэкапы, опциональный кластер из двух машин по QSFP 200G. Тридцать контейнеров, пять минут на установку через sudo bash install.sh, ноль обращений к внешним API.
Практическое руководство по Qwen: установка, настройка vLLM и работа через API
2026-04-22 в 12:00, admin, рубрики: AI, inference, llm, ml, OpenAI, openai api, qwen, selectel, self-hosted, vllm
KV-Cache в LLM: разбираем инференс через 9 ключевых вопросов
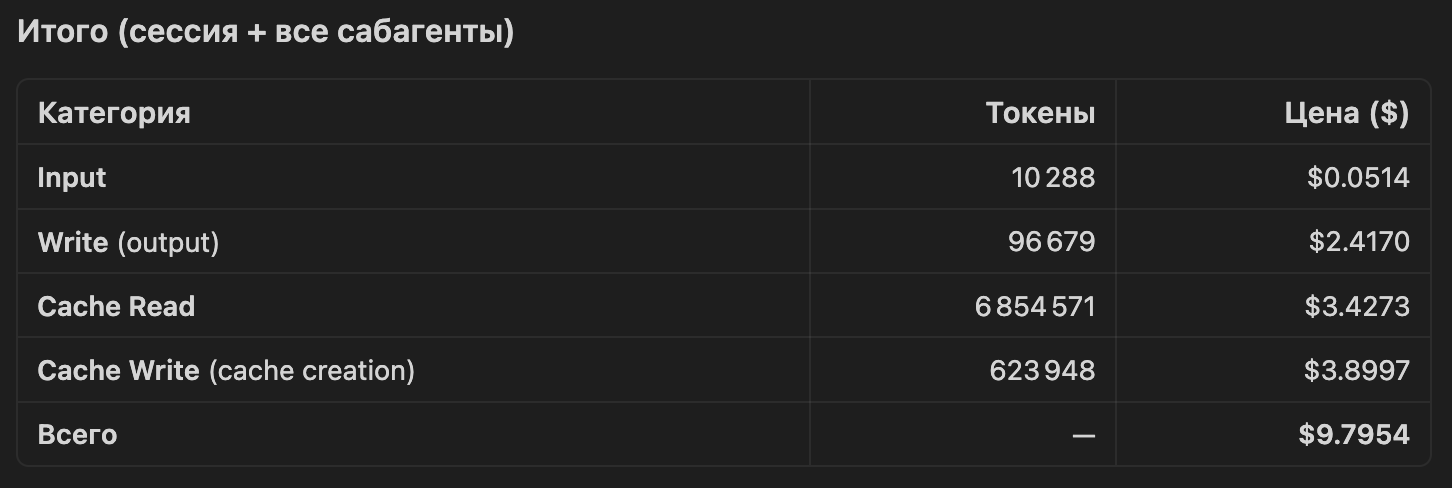
2026-04-10 в 11:21, admin, рубрики: attention, gpu, kv-cache, llm, prefix caching, prompt caching, Transformers, vllm, машинное обучение, машинное обучение. нейросетиНе так давно лимиты на использование Claude Code резко уменьшились, и люди стали лучше считать свои токены. Я не стал исключением, поэтому первым делом собрал информацию по использованию токенов в своих сессиях и посмотрел, что и сколько бы стоило, если бы отправлял это через API.
Собственная облачная LLM на 16 ГБ VRAM — часть 1: базовая сборка, tools и MCP
2026-03-06 в 8:00, admin, рубрики: api-сервис, LangChain, langgraph, localai, MCP, python, qwen3, selectel, vllm, ии-агенты
Привет! На фоне ажиотажа вокруг нейросетей все чаще встает вполне приземленный вопрос — сколько стоит содержать собственную LLM.