

Рубрика «tensorrt»
Zero-Host-Copy инференс: как написать пайплайн на C++-CUDA исключающий участие CPU в горячем цикле (165 FPS)
2026-11-06 в 8:31, admin, рубрики: c++, CUDA, gpgpu, jetson orin, onnxruntime, rtx, tensorrt, zero-copy
Как мы автоматизировали контроль сборки заказов для сети ресторанов быстрого питания
2026-09-24 в 14:53, admin, рубрики: HoReCa, tensorrt, yolo, машинное зрение, общепит, ресторанный менеджмент, рестораныРассказываем о кейсе внедрения компьютерного зрения в ресторане быстрого питания. Ценность кейса для бизнеса: запись с камеры длиной в 24 часа превращается в 30-секундный эпизод, который проверяющий может разобрать за минуту.
В ресторане быстрого питания есть два источника данных: касса и камера. Касса знает, что продали. Камера видит, что положили на поднос. Не всегда касса и камера фиксируют одно и то же.
Ускорение инференса энкодерной guard‑модели: TensorRT, Triton, vLLM, Ray Serve
2026-08-05 в 11:26, admin, рубрики: gliner guard, gliner2, guardrails, Nvidia, tensorrt, triton-inference-server, vllm, инференс нейросетейКогда в системе есть узел между LLM и пользователем его скорость также важна, как и скорость самой LLM. Когда этот узел сам является моделью (и иногда даже — тоже LLM) — задача ускорения становится совсем веселой и её нужно уметь решать разными способами. В этой работе я опишу процесс ускорения guardrail‑модели — узла, которые проверяет — нет ли на входе или выходе опасного контента.
Как троттлинг процессора ломает видеокарту через PCIe: хроники абсурда в сервисном центре DNS
2026-07-05 в 10:53, admin, рубрики: ComfyUI, DNS, pcie, rtx 4090, tensorrt, WHEA-Logger, гарантийный ремонт, деградация GPU, зозпп, троттлингДисклеймер: все события основаны на реальном кейсе борьбы за гарантийный ремонт топового железа в СЦ DNS. Диалоги воспроизведены по памяти, максимально близко к оригиналу, технический абсурд передан без приукрашиваний. Авторское настроение: «мне нихуя, блять, не смешно».
Нейросетевой апскейлинг: как собрать все грабли и почему очевидные настройки всё портят
2026-05-29 в 6:01, admin, рубрики: ffmpeg, tensorrt, апскейлинг, нейросети, цветовое пространство
В своих прошлых статьях «Три пути к 4K» и Читать полностью »
Эффективный инференс множества LoRA адаптеров
2025-06-27 в 8:19, admin, рубрики: async inference, benchmark, inference, lora, multilora, offline inference, PEFT, tensorrt, TensorRT-LLM, vllmLoRA — популярный метод дообучения больших моделей на небольших датасетах, однако на этапе инференса низкоранговые адаптеры работают неэффективно, а их объединение с весами требует хранения отдельной полной копии модели для каждого адаптера.
MultiLoRA решает эту проблему, позволяя одновременно выполнять инференс с несколькими адаптерами на основе одной базовой модели.
В статье мы сравним производительность MultiLoRA-инференса в двух популярных фреймворках — vLLM и TensorRT-LLMЧитать полностью »
Neural Network Optimization: океан в капле
2023-03-16 в 14:51, admin, рубрики: cезон machine learning, neural networks, OpenVINO, tensorrt, Блог компании Doubletapp, дистилляция, искусственный интеллект, квантование, кластеризация, машинное обучение, нейронные сети, обработка изображений, Серверная оптимизацияВсех приветствую, меня зовут Антон Рябых, работаю в Doubletapp. Вместе с коллегой Данилом Гальпериным мы написали статью про важный этап в процессе обучения нейронных сетей и получения необходимых нам результатов — оптимизацию модели. Зачем нужно оптимизировать модель, если и так все работает? Но как только вы начнете разворачивать модель на устройстве, которое будет ее обрабатывать, перед вами встанет множество проблем.
Как запихать нейронку в кофеварку
2020-10-27 в 6:34, admin, рубрики: devops, Edge TPU, Google Edge, Google TPU, gyrfalcon, inference, MNN, myriad, ncnn, ONNX, ONNX runtime, ONNX.js, opencv, OpenVINO, pytorch, Pytorch mobile, Tencent cnn, TensorFlow, Tensorflow lite, tensorrt, TorchScript, triton, Анализ и проектирование систем, Блог компании Recognitor, Компьютерное железо, машинное обучениеМир машинного обучения продолжает стремительно развиваться. Всего за год технология может стать мейнстримом, и разительно измениться, придя в повседневность.
За прошедший год-полтора, одной из таких технологий, стали фреймворки выполнения моделей машинного обучения. Не то, что их не было. Но, за этот год, те которые были — стали сильно проще, удобнее, мощнее.
В статье я попробую осветить всё что повылезало за последнее время. Чтобы вы, решив использовать нейронную сеть в очередном калькуляторе, знали куда смотреть.
Читать полностью »
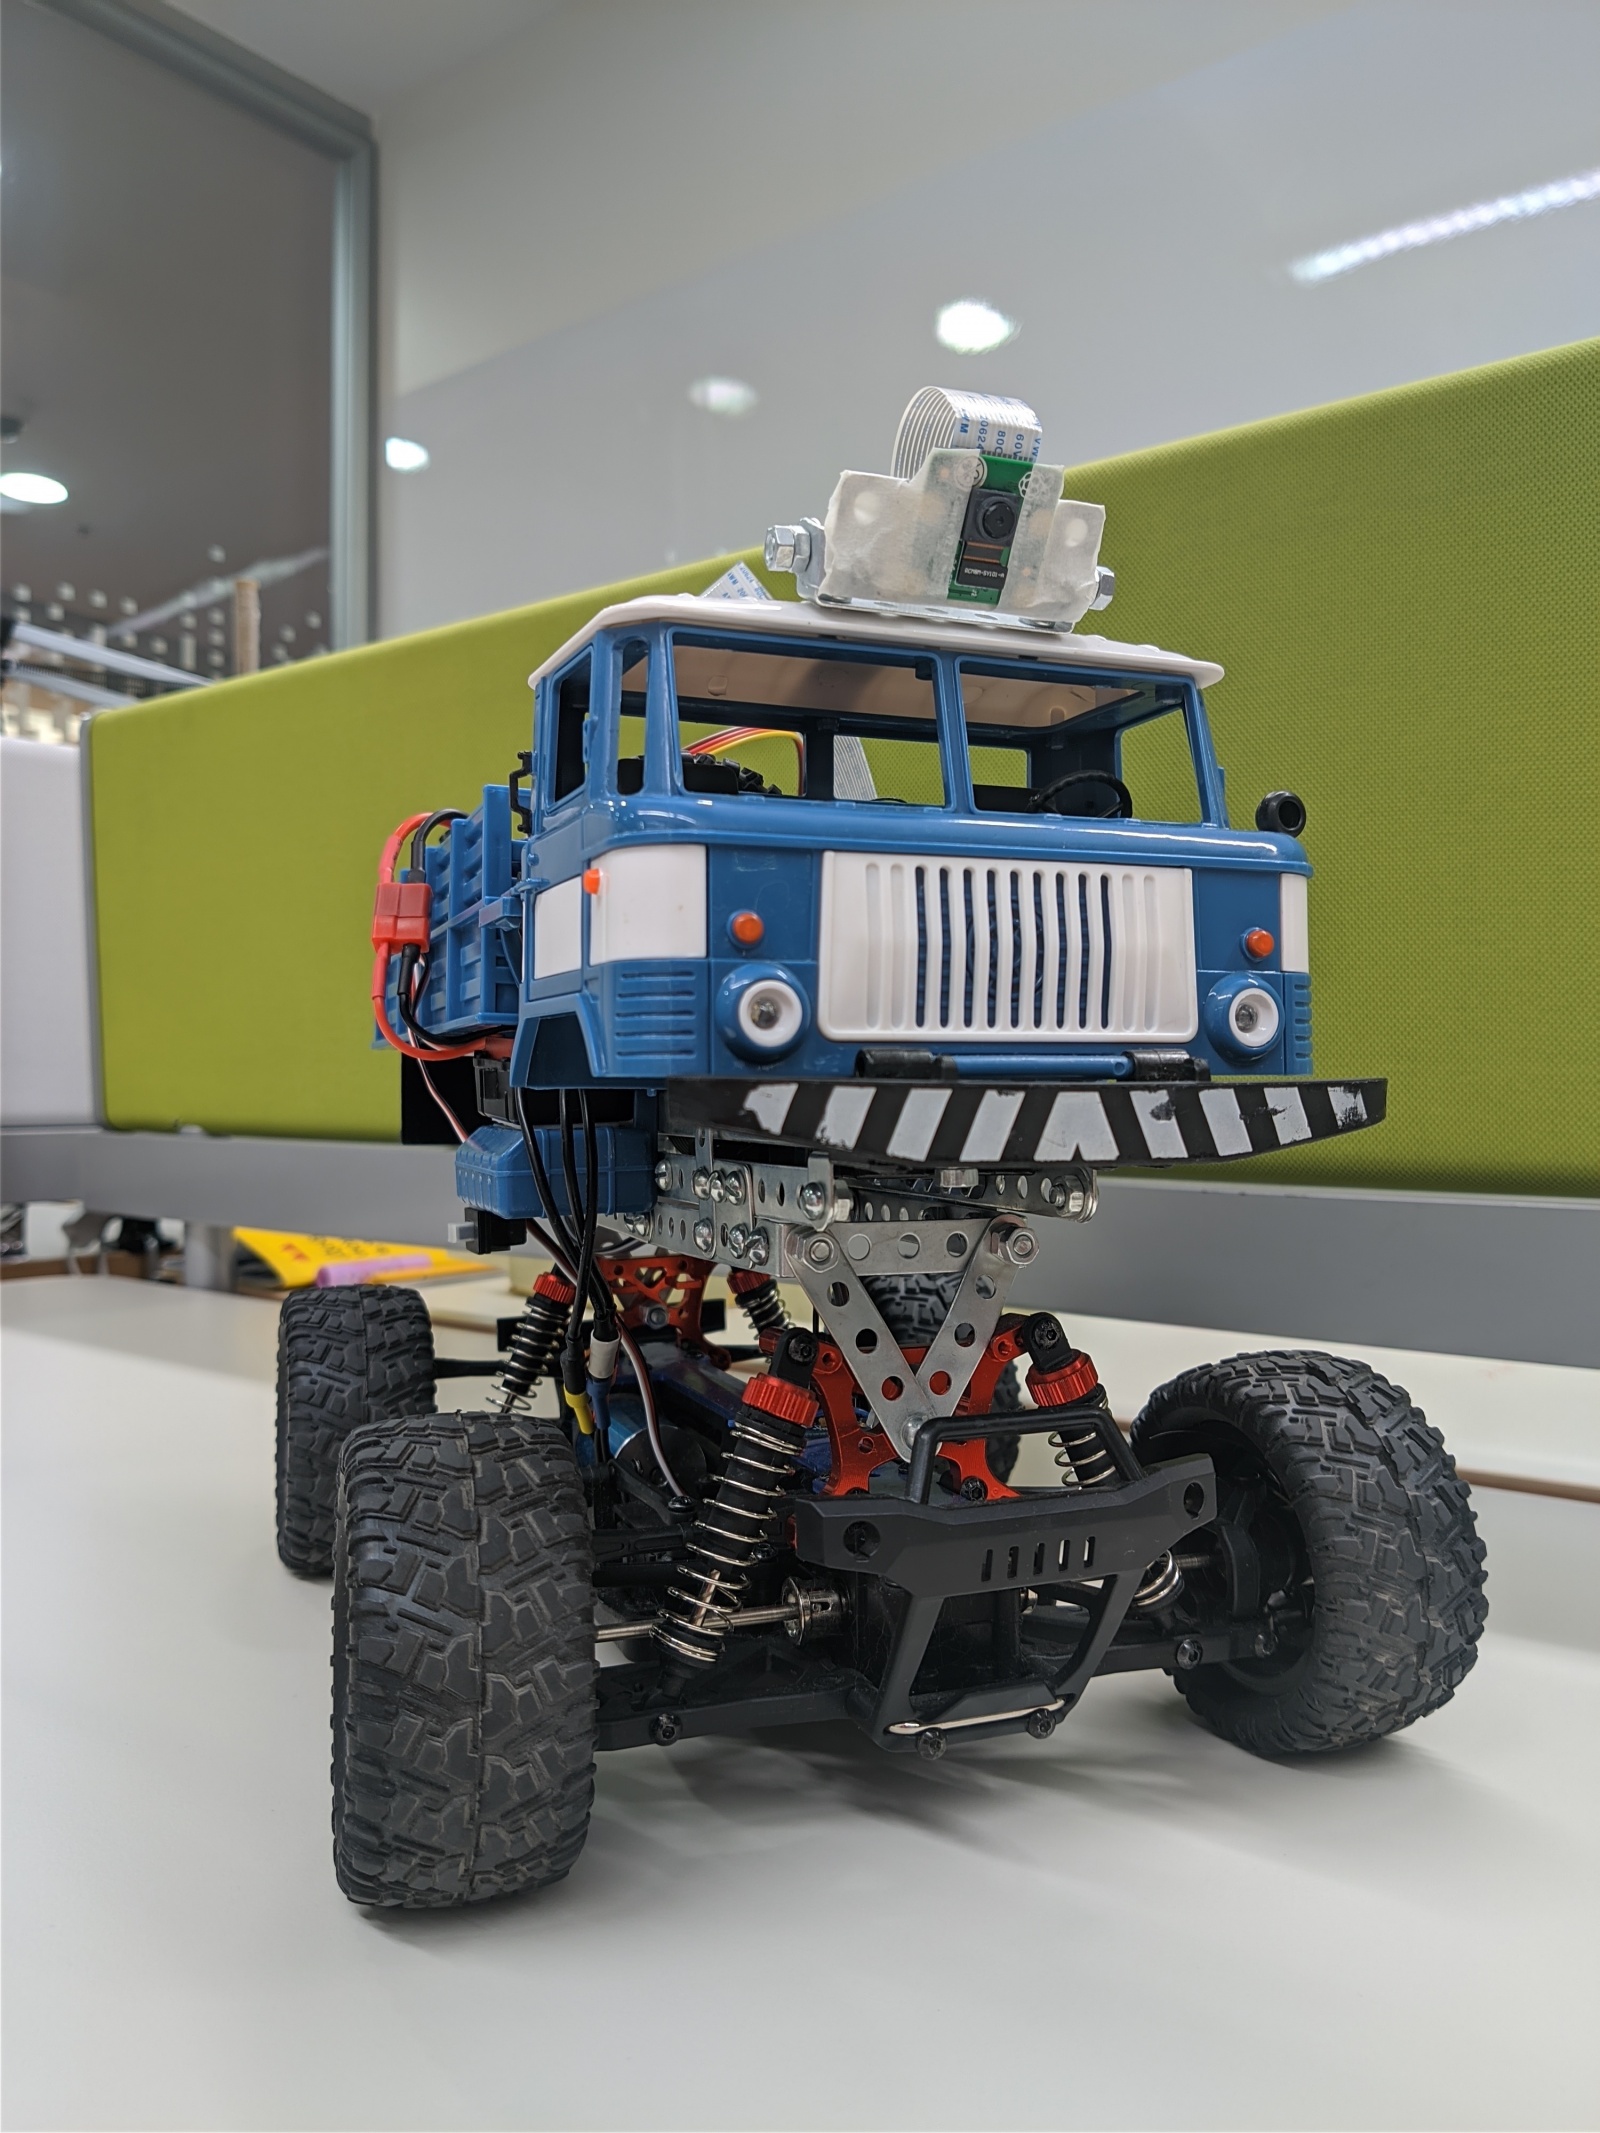
Self-driving ГАЗ66 Monster Truck 1-16
2020-02-19 в 11:28, admin, рубрики: DIY, diy или сделай сам, Jetson Nano, opencv, RC cars, TensorFlow, tensorrt, машинное обучениеХочу рассказать вам о том, как я делал и сделал самоуправляему машинку :)
Я мог бы рассказать сразу, как делать, сухо прикрепив схемы и bash команды, но так будет скучно. Предлагаю вам интересную (я надеюсь) историю о том, как лично я прошел этот путь, и куда пришел.
Те места, где было что фоткать, с фотками. Там, где про софт — скорее всего без фото.
Это будет действительно история в формате повествования, как я рассказывал бы вам за чашкой кофе. Это не про bash команды, python скрипты, и вот это вот всё.
Начнём с фотки и видео того, что получилось, и дальше вся история под катом.
TensorRT 6.x.x.x — высокопроизводительный инференс для моделей глубокого обучения (Object Detection и Segmentation)
2020-01-20 в 12:17, admin, рубрики: aurorai.ru, devops, docker, machine learning, object detection, ods.ai, python, pytorch, segmentation, tensorrt, Блог компании Open Data Science, машинное обучение, обработка изображений
Больно только в первый раз!
Всем привет! Дорогие друзья, в этой статье я хочу поделиться своим опытом использования TensorRT, RetinaNet на базе репозитория github.com/aidonchuk/retinanet-examples (это форк официальной репы от nvidia, который позволит начать использовать в продакшен оптимизированные модели в кратчайшие сроки). Пролистывая сообщения в каналах сообщества ods.ai, я сталкиваюсь с вопросами по использованию TensorRT, и в основном вопросы повторяются, поэтому я решил написать как можно более полное руководство по использованию быстрого инференса на основе TensorRT, RetinaNet, Unet и docker.
Читать полностью »