
TL;DR: Проблема переносимости CUDA для меня оказалась не столько в самих арифметических операциях, сколько в огромном количестве инфраструктуры вокруг них. Поэтому вместо попытки повторять CUDA runtime я решил перехватить программу раньше — на уровне PTX. Я написал ROUGE‑V — открытый AOT‑компилятор, разработанный по принципу clean‑room: берёт PTX, сгенерированный официальным
nvcc13.4, транслирует его в LLVM IR, дальше собирает обычныйclang. Исполняется на x86-64 и на живой GeForce MX450 (побитово с хост‑эталоном); AMD и RISC‑V — пока только сборка, без вранья про «любое железо».Мой GitHub: Читать полностью »
Рубрика «CUDA»
ROUGE‑V: как я транслировал CUDA-PTX в LLVM IR и запускал его без CUDA runtime
2026-10-01 в 12:40, admin, рубрики: AMDGPU, CUDA, gpgpu, gpu, LLVM, Nvidia, PTX, risc-v, Компиляторы, транспиляцияТаинственный остров: находим геолокацию с помощью геометрии и программирования GPU CUDA
2026-08-21 в 8:23, admin, рубрики: CUDA, Google Maps, геолокация, детектив данных, спутниковые снимки
Свой пост я написал после участия в соревнованиях gralhix 004, организованных Софией Сантос | Gralhix.
Задача
Это фотография островного курорта.
Вопросы:
а) Как называется курорт?
Читать полностью »
Как найти остров по одной фотографии: геолокация через геометрию и CUDA
2026-08-21 в 7:23, admin, рубрики: CUDA, gpu, NDVI, OpenStreetMap, OSINT, python, sentinel-2, геолокация, геометрия, спутниковые снимки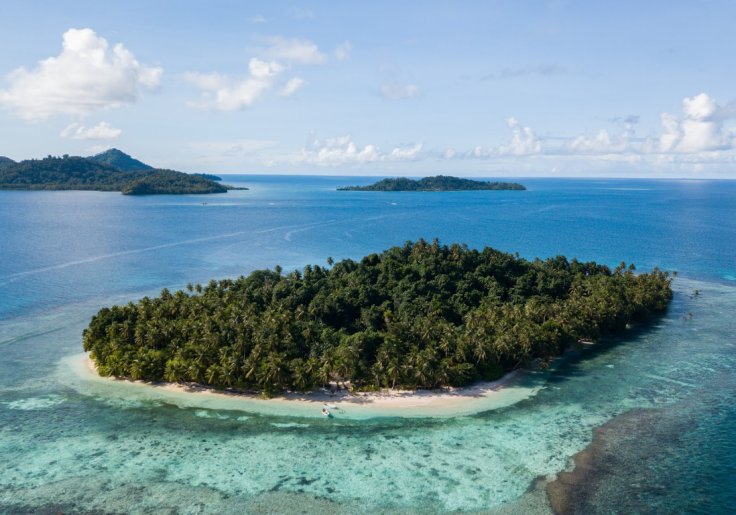
Перед вами фотография островного курорта.
-
Как называется курорт?
-
Какие координаты у острова?
-
В какую сторону света была направлена камера в момент съёмки?
На мой взгляд, пытаться ответить на эти вопросы через google lensЧитать полностью »
MoE на 5090 недобирает полтора раза, и дело не в маршрутизации
2026-08-12 в 8:45, admin, рубрики: CUDA, gpu, llama.cpp, qwen 3.5, rtx 5090, инференс ллм, пропускная способность памяти, профилированиеНачну с пары чисел, которая меня остановила.
RTX 5090, одна и та же сборка llama.cpp (b10326, коммит 3653e6d6d), один драйвер, квант Q4_0, батч 1. Плотная Qwen3.5-9B выбирает 72% пропускной способности памяти карты. MoE Qwen3.5-35B-A3B на той же карте выбирает 41%.
Сразу оговорюсь, чтобы не унесли неверный вывод: MoE при этом быстрее в абсолюте, 317 токенов в секунду против 240. Она просто оставляет на столе примерно полтора раза от собственного потолка, и оставляет по причине, которую можно назвать и померить.
Маршрутизация экспертов тут почти ни при чём. Я её измерил отдельно.
48-кубитный гибридный симулятор Гровера на домашней видеокарте: пробиваем стены памяти и времени
2026-06-04 в 8:06, admin, рубрики: CUDA, dynamic circuits, python, sha48, алгоритм bbht, алгоритм Гровера, высшая математика, квантовые вычисления, квантовый симулятор, оптимизация памятиВокруг квантовых вычислений много маркетингового шума. Если вы попытаетесь смоделировать честное 48-кубитное квантовое состояние в комплексном базисе complex128, то неизбежно упретесь в «стену памяти» в 4.5 Петабайта. Если же вы решите применить блочную декомпозицию пространства состояний для ее поочередного обсчета, то упретесь в «стену времени» длиною в несколько лет непрерывных вычислений на GPU.
В этой статье мы разберем проект гибридного симулятора, который обходит обе стены, удерживая потребление видеопамяти в пределах 268 МБ, а время симуляции сокращает в 400 раз.
Планирование движения для ровера на ходовой Ackerman’а
2026-05-26 в 16:58, admin, рубрики: CUDA, DIY, jetson, ROS, ros2, робототехника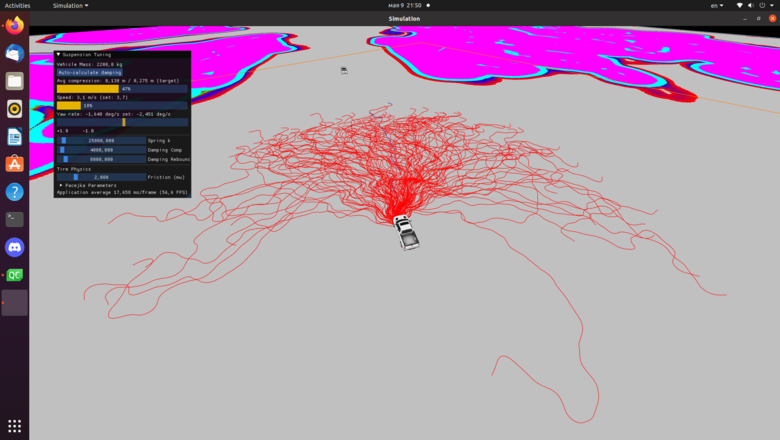
Куда и почему уходят бабки на нейросети
2026-01-30 в 15:19, admin, рубрики: attention, chatgpt, claude, CUDA, gpu, inference, kv-cache, llm, transformer, токеныМалоизвестный среди обычных людей факт: у нейросетей нет никаких "разговоров". Ты смотришь в веб-интерфейсе на "диалог" - но это обман, красивый фокус.
Каждый раз, когда ты пишешь новое сообщение, все старые сообщения обрабатываются заново. У нейросетей по-настоящему многоразовых задач не существует. Если результат немного поменялся — тебе просто не покажут в веб-интерфейсе изменившиеся сообщения.
Production AI сервер за ₽0: полный гайд по сборке ML-станции для Stable Diffusion на б-у комплектующих
2025-10-31 в 14:20, admin, рубрики: AI, CUDA, deeplearning, DIY, gpu, hardware, machinelearning, python, pytorch, stablediffusion
Я это сделал. За один день.
Часть 1: Аппаратная часть
Выбор видеокарт: RTX 2060 vs RTX 1060
Nvidia CMP – микроскопы для забивания гвоздей?! Копаем глубже…
2025-09-18 в 19:06, admin, рубрики: 40hx, 50HX, 90HX, CMP, cublas, CUDA, llm, LM Studio, Nvidia, майнингПочему видеокарта, имеющая неплохие вычислительные возможности, в Stable Diffusion работает в 20 раз медленнее, чем RTX 3060? Почему в LM Studio она становится фаворитом, а в ComfyUI карета превращается в тыкву? Почему FurMark на CMP 90HX тормозит, а на CMP 50HX «бублик» крутится почти нормально? Разгадки в разных программных ограничениях, которые можно найти с помощью экспериментов. Я купил три майнинговые карты Nvidia, чтобы понять, можно ли заставить их эффективно работать.
В этот раз мы рассмотрим:
-
статистику производительности в LM Studio
-
как всё печально в ComfyUI и Stable Diffusion
-
анатомию программного кода GPU