Рубрика «Nvidia»

Предыстория

Есть домашний сервер обычной “подстольной” конфигурации. Proxmox с несколькими виртуалками. В какой-то момент прикупил на аукционе NVIDIA CMP 50HX за копейки, ради поиграться с простенькими модельками. Модели запускаю через llama.cpp, дополнительно использую Whisper для распознавания речи. Быстро смирился со скоростью работы и жил с этим всем спокойно несколько месяцев, пока не наткнулся на статью NVIDIA CMP – микроскопы для забивания гвоздей? Копаем глубже….

Очень рекомендую прочесть статьюЧитать полностью »

TL;DR: Проблема переносимости CUDA для меня оказалась не столько в самих арифметических операциях, сколько в огромном количестве инфраструктуры вокруг них. Поэтому вместо попытки повторять CUDA runtime я решил перехватить программу раньше — на уровне PTX. Я написал ROUGE‑V — открытый AOT‑компилятор, разработанный по принципу clean‑room: берёт PTX, сгенерированный официальным nvcc 13.4, транслирует его в LLVM IR, дальше собирает обычный clang. Исполняется на x86-64 и на живой GeForce MX450 (побитово с хост‑эталоном); AMD и RISC‑V — пока только сборка, без вранья про «любое железо».

Мой GitHub: Читать полностью »

Ваша подписка — это верхний этаж пирамиды. Мы будем спускаться всё ниже, что б понять на чём же стоит ИИ-бум на самом деле?

TL;DR: Opus 5.5 вышел, а месячный план не изменился и уже кажется привычным. Как будто всё честно: я плачу разумные деньги и получаю технологию. Однако это только верхний этаж. Что сложено под ним и почему оттуда пахнет порохом, разбираю ниже, шаг за шагом. Каждое звено по отдельности называют «управляемым риском». Но есть одна вещь, которая давит на все звенья сразу, и мы в ней разберемся. О локальном опыте подсчёта стоимости я писал в предыдущей статье. Здесь же совершенно другой масштаб.

Читать полностью »

Типичный ролик из недалёкого будущего: Гуманоид уверенно шагает рядом с полицейскими. Робособака обследует территорию. Робот-официант объезжает посетителя с таким выражением «лица», что чаевых сегодня не будет.

Хочется верить, что внутри каждого сидит единый искусственный разум: видит мир, понимает происходящее, принимает решения и управляет телом. Но это не совсем так.

Например, внутри AgiBot X2 Ultra работают три самостоятельных компьютераЧитать полностью »

Рискованный бизнес Nvidia - 1

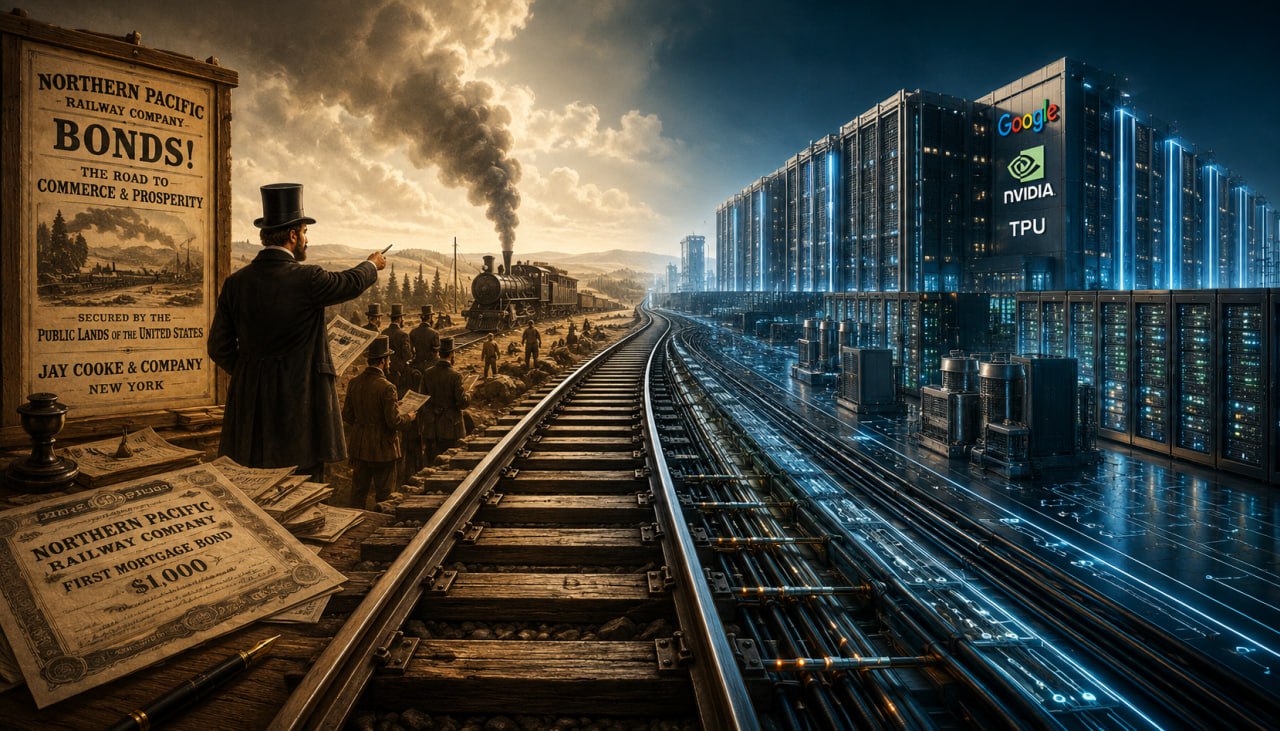
Джей Кук, который прославился как американский герой за решающую роль в обеспечении финансирования Союзных сил в Гражданской войне, 1 января 1870 года подписал контракт, который, по сути, привёл уже к Мировой войне.

Читать полностью »

Разбор AMD EPYC Venice: 256 ядер, 2-нм TSMC, два сокета и СЖО как неизбежность - 1

Всем привет, с вами Сергей Ковалёв, менеджер выделенных серверов в SelectelЧитать полностью »

Когда в системе есть узел между LLM и пользователем его скорость также важна, как и скорость самой LLM. Когда этот узел сам является моделью (и иногда даже — тоже LLM) — задача ускорения становится совсем веселой и её нужно уметь решать разными способами. В этой работе я опишу процесс ускорения guardrail‑модели — узла, которые проверяет — нет ли на входе или выходе опасного контента.

Читать полностью »

Мой рабочий компьютер собирался как игровой: 5800X3D, приличная видеокарта. Ирония в том, что играю я на нём всё меньше, а с недавних пор он и вовсе переехал в шкаф в прихожую и стал домашним сервером — кино, файлы, всё как у всех. Смотреть, как игровое железо вечерами раздаёт сериалы, было больно, и я решил: пусть оно стримит игры туда, где я в них действительно играю — на телевизор, Steam Deck и ноутбук.

Читать полностью »
vLLM vs LMDeploy vs Triton: обзор бэкендов для инференса LLM - 1

Лучший способ сжечь бюджет компании на инфраструктуру — запуск LLM в продакшене. Но только если вы не знаете, какой бэкенд использовать и как его настраивать.

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js