
Рубрика «Nvidia» - 2
От Triton Inference Server к NVIDIA Dynamo: как изменился inference для агентов в 2026
2026-07-07 в 9:41, admin, рубрики: AI, dynamo, gpu, llm, Nvidia
Нейро сети для самых маленьких. Часть первая (которая после нулевой). Удобство в прокрустовом ложе оптимизации
2026-07-01 в 7:00, admin, рубрики: ethernet, gpu, gpudirect rdma, infiniband, Nvidia, NVLink, RDMA, roce, tcpЭто первая (после нулевой) статья из серии Нейро сети для самых маленьких, в которой мы разбираем инфраструктуру для запуска нейронных сетей.
Для обучения и инференса нейросетей и для любых видов High Performance Computing используются специализированные технологии: GPU/TPU, RDMA, Kernel bypass, NVLink, InfiniBand, RoCE и другие. Про некоторые из них большинство только что-то слышали, но сталкиваться с ними не приходилось.
Нельзя просто взять ванильный стек Linux, воткнуть в него 400 Gb Ethernet+IP и получить рабочее решение. Почему?

80% мирового HBM. Как Корея захватила рынок памяти для ИИ
2026-06-25 в 6:04, admin, рубрики: dram, HBM, Nvidia, Samsung, sk hynix, искусственный интеллект, память, полупроводники, чипы, южная кореяКакой главный корейский продукт? Многие назовут автомобили, электронику и бытовую технику, сериалы, косметику или даже K-Pop. Но главный корейский продукт другой. Без него не работали бы смартфоны и ноутбуки, не было бы ИИ-бума, а весь мировой прогресс серьёзно бы замедлился. Эта корейская суперсила - память. В этой статье мы разберемся, как небольшая азиатская страна, отнюдь не сверхдержава, подмяла под себя главную драгоценность мировых технологий.
Начнём с одной новости. В мае Samsung вошёлЧитать полностью »
Как я собрал LLM-печку на 4 GPU, и на что она способна
2026-05-30 в 6:51, admin, рубрики: AI, homelab, homeserver, llm, multi-gpu workstation, Nvidia, opencode, Агент, Железо, сборка
288-ядерный Xeon 6+ и другие серверные CPU
2026-05-27 в 7:02, admin, рубрики: cerebras, intel, Nvidia, ruvds_статьи, дата-центры, серверные cpu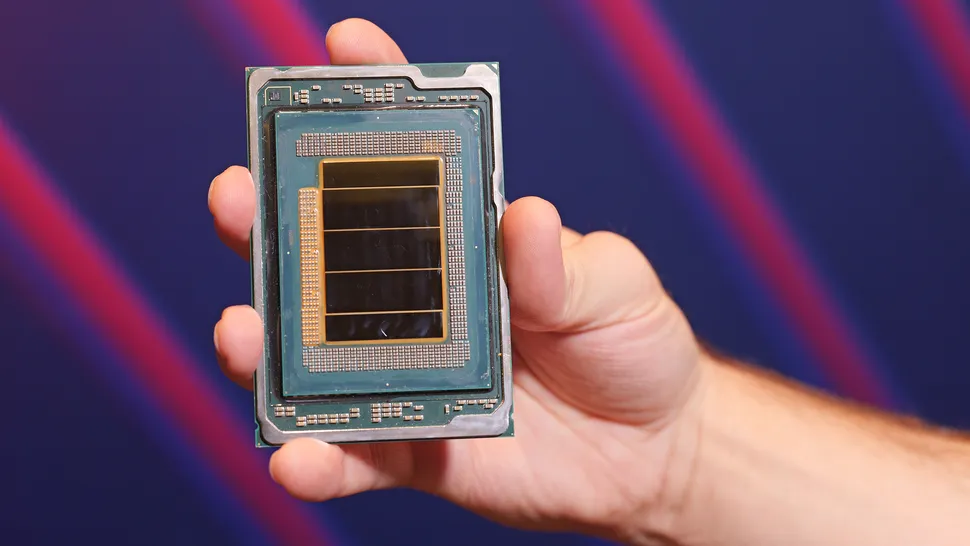
В марте 2026 года на конференции MWC компания Intel показалаЧитать полностью »
Тестируем NVIDIA HGX B300 — инференс-сервер с 8 GPU и 2,3 ТБ VRAM на DeepSeek, Qwen и MiniMax
2026-05-15 в 8:00, admin, рубрики: dgx, gpu, hgx b300, llm, Nvidia, selectel, инференс
Люди скупают Mac Mini M4, а SpaceX покупает Cursor за $60 млрд: ML-дайджест
2026-05-06 в 12:00, admin, рубрики: AI, ai-агенты, ElevenLabs, intel, mac mini, ml, Nvidia, SambaNova, selectel, spacex
Мы уткнулись в потолок. Почему видеокарты перестали быстро расти — и что с этим делать
2026-05-04 в 16:45, admin, рубрики: AI инфраструктура, blackwell, gpu, H100, HBM, llm, Nvidia, архитектура GPU, закон Мура, чиплетыО смерти закона Мура применительно к GPU, стене памяти, которую никто не хочет замечать, и архитектурах, которые пытаются с этим жить.
H100 стоит $30 000 и потребляет 700 Вт. RTX 5090 — $2 000 (де-факто больше) и 575 Вт. Прирост производительности между поколениями сжался с 80% до 15–20%. Это, на самом деле, структурная проблема. Давайте разберёмся, откуда она взялась и куда мы движемся.