В первой части я рассказал, как запустил Qwen на списанной FPGA-плате за $50 с открытым TPU (openTPU). Комментаторы справедливо заметили: это больше анонс, чем статья. Где сборка, где кристалл, где замеры, почему 133 МГц, где КЕДР?
Рубрика «инференс»
Нафиг NVIDIA! Часть 2. Запустил 8 нейросетей на FPGA за $50 — и упёрся в DDR3
2026-10-17 в 9:06, admin, рубрики: ai-ускорители, DDR, fpga, gpu, llm, open source, qwen, risc-v, инференс, памятьНафиг NVIDIA! Я запустил Qwen на FPGA за $50 — а свой TPU назвал бы «КЕДР». Часть 1
2026-10-09 в 15:30, admin, рубрики: ai-ускорители, fpga, llm, open source, qwen, risc-v, xilinx, Железо, инференсЯ хотел разработать собственный AI‑процессор, нашёл openTPU, взял FPGA за ~$50 с 4 ГБ оперативной памяти, подключил её к обычному мини‑ПК и запустил на ней большую языковую модель — и улетел в космос (в позитивном и дофаминовом смыслах).
Без NVIDIA. Без видеокарты. На открытой архитектуре, которая разработана при активном участии ИИ‑агентов.
openTPU — открытый AI‑ускоритель Felipe Sens Bonetto.
Мне стало интересно: а можно ли действительно взять такой проект с GitHub, загрузить его в физическую FPGA и запустить настоящий LLM‑инференс?
По замерам автора проекта на такой же плате:
Читать полностью »
Купил мини‑ПК с приставкой «AI» ради локальной LLM. Что может NPU на самом деле
2026-10-01 в 9:58, admin, рубрики: amd ryzen ai, fastflowlm, LiteLLM, npu, proxmox, qwen, self-hosted, xdna, инференс, локальные llm
TL;DR.Читать полностью »
Российский нейрочип от НТЦ «Модуль»
2026-09-26 в 5:12, admin, рубрики: gpu, llm, вычисления, вычисления в gpu, импортозамещение, инференс, инференс-чип, микроэлектроника, нейропроцессор, нейросетьДополнение к части 2 «Рынок вычислений в России, Казахстане и Беларуси» — то, что не вошло в основной текст
В части 2 про рынок вычислений есть фраза, которую я написал между делом: «…и нишевые нейропроцессоры НТЦ "Модуль"». Скобка, запятая — и дальше про память и электричество. Но я споткнулся о скобку: про эти процессоры я слышал давно, всерьёз не разбирался, а цифр перед глазами не держал. Проверил. Погрузился. И чем глубже капал, тем яснее было: этому процессору нужна отдельная статья.
История.Читать полностью »
«Друзья не дают друзьям пользоваться Ollama»
2026-09-22 в 8:44, admin, рубрики: DeepSeek R1, gguf, hugging face, llama.cpp, Modelfile, Ollama, open source, инференс, локальные llm, облачные llm
Ниже — перевод статьи «Friends Don’t Let Friends Use Ollama»Читать полностью »
Спекулятивное декодирование: от чего на самом деле зависит ускорение
2026-09-15 в 10:32, admin, рубрики: EAGLE-3, llm, qwen3, длина принятия, инференс, спекулятивное декодирование, ускорение инференсаЯзыковая модель пишет ответ по одному токену за шаг, и на каждом шаге прочитывает все свои веса от начала до конца. Спекулятивное декодирование пытается это обойти: маленькая черновая модель набрасывает несколько токенов вперёд, причём сразу деревом вариантов, а большая проверяет всё это дерево за один свой проход и принимает ту ветку, которая совпала с её собственным выбором. Текст на выходе получается тот же самый, быстрее становится только его получение. Так устроен метод из статьи EAGLE-3 с NeurIPS 2025, и авторы приводят для него ускорение до 6.5 раза.
Скидка в 97%: как устроен китайский мошеннический рынок ИИ-токенов
2026-08-19 в 13:01, admin, рубрики: llm, ruvds_перевод, инференс, токены llm, черный рынок, языковые модели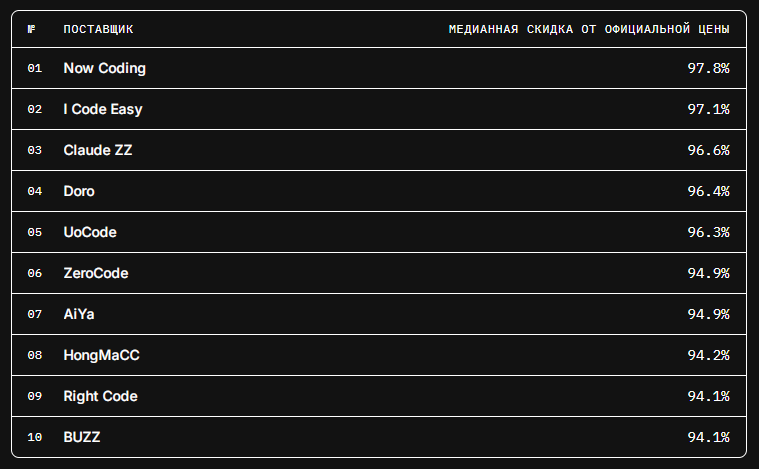
Моя история
Я долгое время размышлял о мошенничестве с токенами — проблеме, с которой впервые столкнулся, когда работал разработчиком ПО в ИИ-шлюзе.
Всё, что вы хотели знать о локальном ИИ, но стеснялись спросить
2026-08-11 в 17:16, admin, рубрики: Apple Silicon, gguf, llama.cpp, llm, meta, инференс, квантизация, локальные модели
Если вы когда-нибудь смотрели на HF и не понимали, что такое DFlash, квантизация и почему одна и та же модель лежит в десяти репозиториях от десяти разных людей — или давно собирались поднять LLM у себя, но всё не находили повода — выход Muse Glimmer 30B буквально лучший момент начать.
4.6-битные сети: от теории к практике. Причём здесь HardTanh?
2026-06-26 в 10:07, admin, рубрики: 4.6-битное квантование, edge ai, HardTanh, resnet, инференс, квантование, мобильный ии, нейронные сети, низкоразрядные вычисленияУже прошло два года с тех пор, как мы предложили схему 4.6-битного квантования и рассказали про нее, в том числе и на Хабре: раз и два. Вспомним, что при 4.6-битном квантовании веса и входы слоя принимают такие целые значения, что их попарные произведения помещаются в знаковый 8-битный тип данных. Такая схема позволила нам вычислять нейронные сети на процессорах мобильных устройств быстрее, чем в 8-битном формате, и точнее, чем в 4-битном, потому что уровней квантования больше.
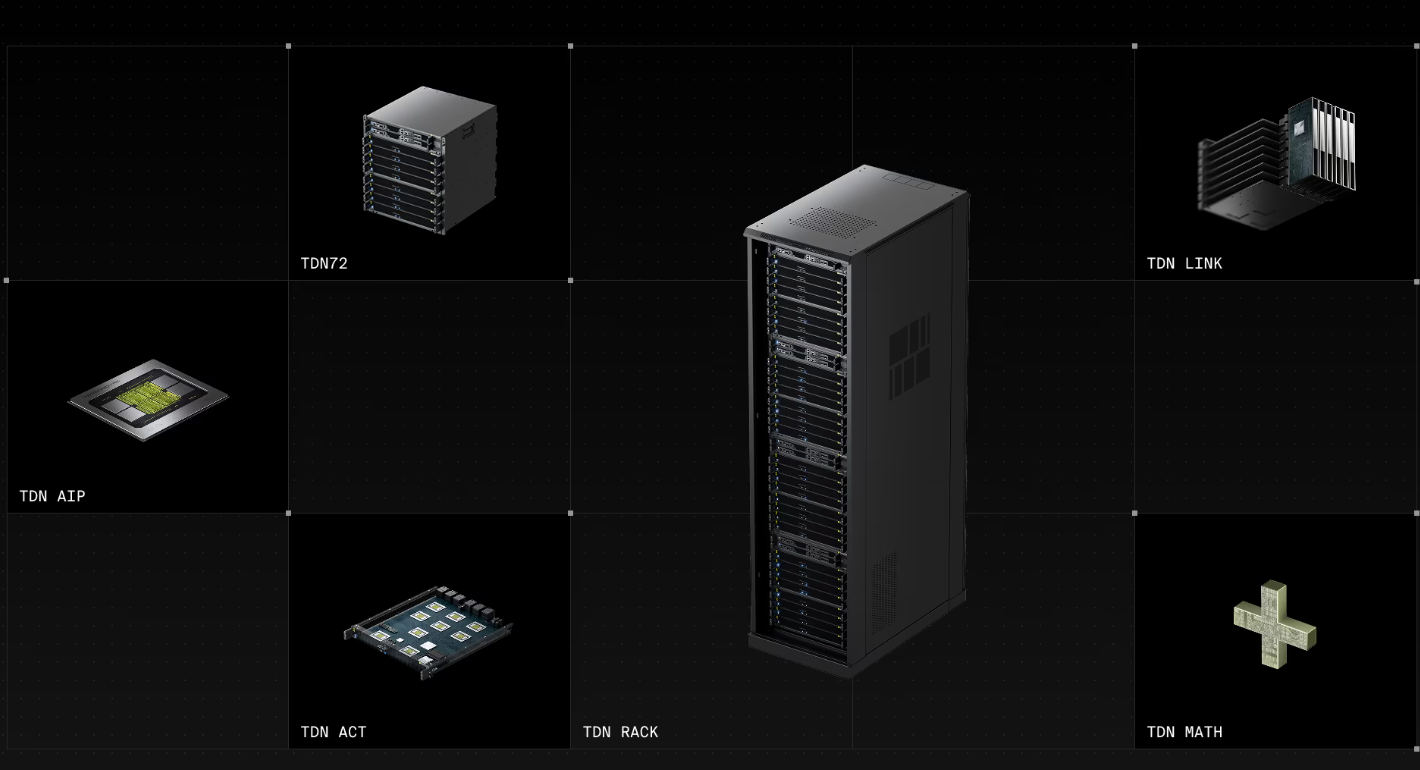
Tensordyne Napier — еще одно решение на замену традиционных GPU в инференсе
2026-06-23 в 8:01, admin, рубрики: gpu, selectel, sram, инференс