
По статистике, среди рядовых пользователей настольных компов самая распространенная видеокарта имеет 16 ГБ видеопамяти. По опросам GaugeDB, такие карты занимают 27,21% рынка. У меня как раз видеокарта NVIDIA GeForce RTX 4070 Ti SUPER с 16 ГБ видеопамяти GDDR6X, которая на текущий момент стоит 900$. До сего момента главной проблемой было то, что на видеокарте такого класса невозможно было запустить LLM-агента, который будет достаточно умным и достаточно быстрым. Если запускаешь умную модель типа Qwen 3.8 27B (Dense архитектура), то на выходе получаешь 10-20 токенов в секунду. А для комфортной работы кодинг-агента надо 100-150 токенов в секунду.
Рубрика «gpu»
125 токенов в секунду на RTX 4070 Ti SUPER: как я заставил локальную LLM работать полноценным кодинг-агентом
2026-10-27 в 9:20, admin, рубрики: gpu, llm, piНафиг NVIDIA! Часть 2. Запустил 8 нейросетей на FPGA за $50 — и упёрся в DDR3
2026-10-17 в 9:06, admin, рубрики: ai-ускорители, DDR, fpga, gpu, llm, open source, qwen, risc-v, инференс, памятьВ первой части я рассказал, как запустил Qwen на списанной FPGA-плате за $50 с открытым TPU (openTPU). Комментаторы справедливо заметили: это больше анонс, чем статья. Где сборка, где кристалл, где замеры, почему 133 МГц, где КЕДР?
Как мы запустили Qwen3.8–27B целиком на RTX 5060 8 GB и получили ~30 токенов-с
2026-10-07 в 11:34, admin, рубрики: AI, gpu, open source, искусственный интеллектРепозиторий проекта: https://github.com/ExVRAM/exvram‑lab
ExVRAM Lab — открытый исследовательский проект, посвящённый запуску больших локальных LLM на потребительских видеокартах с небольшим объёмом VRAM. Мы исследуем, насколько далеко можно зайти, если не писать собственный inference engine с нуля, а системно использовать существующие open‑source технологии: ultra‑low‑bit quantization, полное размещение весов на GPU, оптимизацию KV cache и современные CUDA‑backends.
PPU Zhenwu 810E от Alibaba: как китайский AI-ускоритель справляется с LLM
2026-10-06 в 8:00, admin, рубрики: AI, ai-ускорители, Alibaba Cloud, deepseek, gpu, ml, mlops, ppu, selectel
ROUGE‑V: как я транслировал CUDA-PTX в LLVM IR и запускал его без CUDA runtime
2026-10-01 в 12:40, admin, рубрики: AMDGPU, CUDA, gpgpu, gpu, LLVM, Nvidia, PTX, risc-v, Компиляторы, транспиляцияTL;DR: Проблема переносимости CUDA для меня оказалась не столько в самих арифметических операциях, сколько в огромном количестве инфраструктуры вокруг них. Поэтому вместо попытки повторять CUDA runtime я решил перехватить программу раньше — на уровне PTX. Я написал ROUGE‑V — открытый AOT‑компилятор, разработанный по принципу clean‑room: берёт PTX, сгенерированный официальным
nvcc13.4, транслирует его в LLVM IR, дальше собирает обычныйclang. Исполняется на x86-64 и на живой GeForce MX450 (побитово с хост‑эталоном); AMD и RISC‑V — пока только сборка, без вранья про «любое железо».Мой GitHub: Читать полностью »
Китайские GPU — две новинки, которые стоит рассмотреть в паре
2026-10-01 в 8:01, admin, рубрики: alibaba, amd, gpu, huawei, Nvidia, ppu, selectel, t-head, китайские gpu, ускорители ии
Российский нейрочип от НТЦ «Модуль»
2026-09-26 в 5:12, admin, рубрики: gpu, llm, вычисления, вычисления в gpu, импортозамещение, инференс, инференс-чип, микроэлектроника, нейропроцессор, нейросетьДополнение к части 2 «Рынок вычислений в России, Казахстане и Беларуси» — то, что не вошло в основной текст
В части 2 про рынок вычислений есть фраза, которую я написал между делом: «…и нишевые нейропроцессоры НТЦ "Модуль"». Скобка, запятая — и дальше про память и электричество. Но я споткнулся о скобку: про эти процессоры я слышал давно, всерьёз не разбирался, а цифр перед глазами не держал. Проверил. Погрузился. И чем глубже капал, тем яснее было: этому процессору нужна отдельная статья.
История.Читать полностью »
Может ли дата-центр вообще отказаться от воды?
2026-09-18 в 16:51, admin, рубрики: gpu, водопотребление, дата-центры, жидкостное охлаждение, искусственный интеллект, охлаждение дата-центров, охлаждение серверов, серверы, цод, энергоэффективностьНемного экспериментальный формат, который надеюсь, вам зайдет. Мне лично очень нравится изучать разные темы вне статистики, аналитики и прикладных к ним темам, поэтому иногда для того, чтобы лучше разобраться с какой-то темой лучше всего ее попробовать объяснить или описать самостоятельно.
В данном материале речь пойдет про ИИ, но немного с непривычного формата - попробуем разобраться, зачем охлаждают и чем сейчас охлаждаются дата-центрыЧитать полностью »
Кто остановит AGI: законы или мегаватты?
2026-09-17 в 15:53, admin, рубрики: AGI, gpu, апокалипсис, дата-центр, искусственный интеллект, ресурсыВ последние месяцы снова активизировались призывы притормозить развитие наиболее мощных AI-систем. Причём теперь они исходят уже не только от политиков и сторонних экспертов. Руководители крупнейших AI-компаний сами обсуждают необходимость замедлить гонку, ввести независимый контроль и договориться о правилах, которые позволили бы остановиться, если дальнейшее развитие станет слишком опасным.
Как найти остров по одной фотографии: геолокация через геометрию и CUDA
2026-08-21 в 7:23, admin, рубрики: CUDA, gpu, NDVI, OpenStreetMap, OSINT, python, sentinel-2, геолокация, геометрия, спутниковые снимки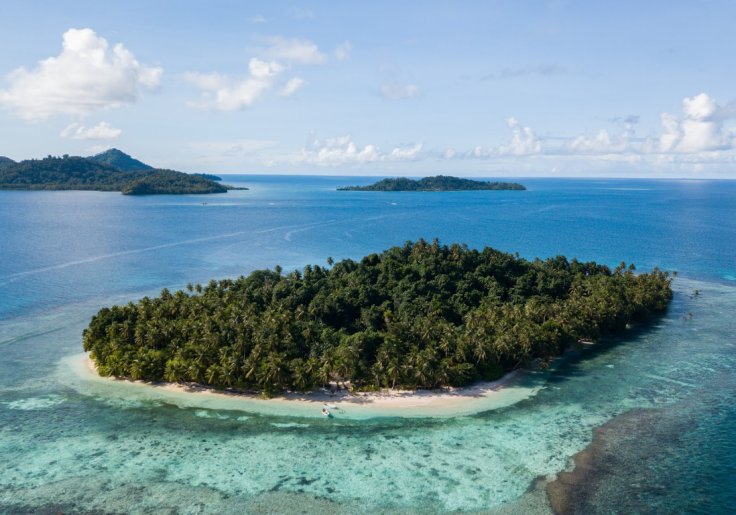
Перед вами фотография островного курорта.
-
Как называется курорт?
-
Какие координаты у острова?
-
В какую сторону света была направлена камера в момент съёмки?
На мой взгляд, пытаться ответить на эти вопросы через google lensЧитать полностью »