
Получилось так что я купил книжку на английском, в Австралии (автор оттуда и там она дешевле в 3 раза чем у Гугла), но прочитать не смог, очень богатый мир , много странных слов, начал терять контекст истории, читал по 2 страницы в день. Затем на ТГ канале Акимова попалась ссылка на прототип агента по переводу текста , со сслыками в итоге на научные работы и т.д., обрадовавшись полез на гитхаб искать форки и конечно готовую софтину , но почему то она не случилась. спустя два года появились платные сервисы, но не опенсорсная поделка, и я решил собрать хотя бы MVP чтобы проверить идею самостоятельно, потом написатьЧитать полностью »
Рубрика «CUDA» - 2
Переводим fb2 книжки, с нейронками, для себя
2025-09-14 в 18:15, admin, рубрики: CUDA, fb2, llm, llm-модели, llm-приложения, python, sci-fi, spacy, перевод, переводыШпаргалка по установке драйверов NVIDIA на ML сервер
2025-05-29 в 13:09, admin, рубрики: container, CUDA, docker, gpu, linux, Nvidia, nvidia-smi, Ubuntu, Драйвер, установка
Специалисты из сферы ИИ часто сталкиваются с задачей корректной настройки сервера с GPU. Лично я с этой задачей сталкиваюсь в последнее время даже слишком часто...
Обзор CUDA: сюрпризы с производительностью
2025-04-17 в 11:25, admin, рубрики: CUDA, графические процессоры, оптимизация, ПараллелизмНаверное, я очень опоздал с изучением CUDA. До недавнего времени даже не знал, что CUDA — это просто C++ с небольшими добавками. Если бы я знал, что изучение её пойдёт как по маслу, я бы столько не медлил. Но если у вас есть багаж привычек C++ , то код на CUDA у вас будет получаться низкокачественным. Поэтому расскажу вам о некоторых уроках, изученных на практике — возможно, мой опыт поможет вам ускорить код.
Слияние блоков памяти
Если у вас множество потоков, работающих над одним массивом в C++, то, вероятно, вы попробуете перебрать его таким образом:
Читать полностью »Ведущий разработчик ChatGPT и его новый проект — Безопасный Сверхинтеллект
2025-04-07 в 9:01, admin, рубрики: 10x engineer, alexnet, AlphaGo, chatgpt, CUDA, DNNResearch, few-shot learning, Google Brain, gpgpu, gpt, gpu, Ilya Sutskever, ImageNet, lenet, Nvidia GTX 580, OpenAI, ruvds_статьи, Safe Superintelligence, seq2seq, TensorFlow, word2vec, Алекс Крижевски, Джеффри Хинтон, илья суцкевер, Компьютерное зрение, машина Больцмана, неокогнитрон, сверхинтеллект, Томаш Миколов
Многие знают об Илье Суцкевере только то, что он выдающийся учёный и программист, родился в СССР, соосновал OpenAI и входит в число тех, кто в 2023 году изгнал из компании менеджера Сэма Альтмана. А когда того вернули, Суцкевер уволился по собственному желанию в новый стартап Safe Superintelligence («Безопасный Сверхинтеллект»).
Илья Суцкевер действительно организовал OpenAI вместе с Маском, Брокманом, Альтманом и другими единомышленниками, причём был главным техническим гением в компании. Ведущий учёный OpenAI сыграл ключевую роль в разработке ChatGPT и других продуктов. Сейчас Илье всего 38 лет — совсем немного для звезды мировой величины.Читать полностью »
Бэктестинг торговых стратегий на Python с помощью Numba. Когда перевод расчетов на GPU действительно оправдан?
2025-03-24 в 9:24, admin, рубрики: backtesting, CUDA, gpu, numba, python, производительностьВведение
Бэктестинг — ключевой процесс в алгоритмической торговле. Он позволяет проверить стратегию на исторических данных, прежде чем запускать её в реальной торговле. Однако, чем больше данных и сложнее логика стратегии, тем дольше времени занимают вычисления. Особенно если стратегия анализирует тиковые данные и требуется протестировать множество комбинаций гиперпараметров стратегии, время вычислений может расти экспоненциально.
В этой статье мы разберем, как реализовать бэктестинг на чистом Python, посмотрим сколько времени могут занимать вычисления, а также попробуем найти разные способы оптимизации.
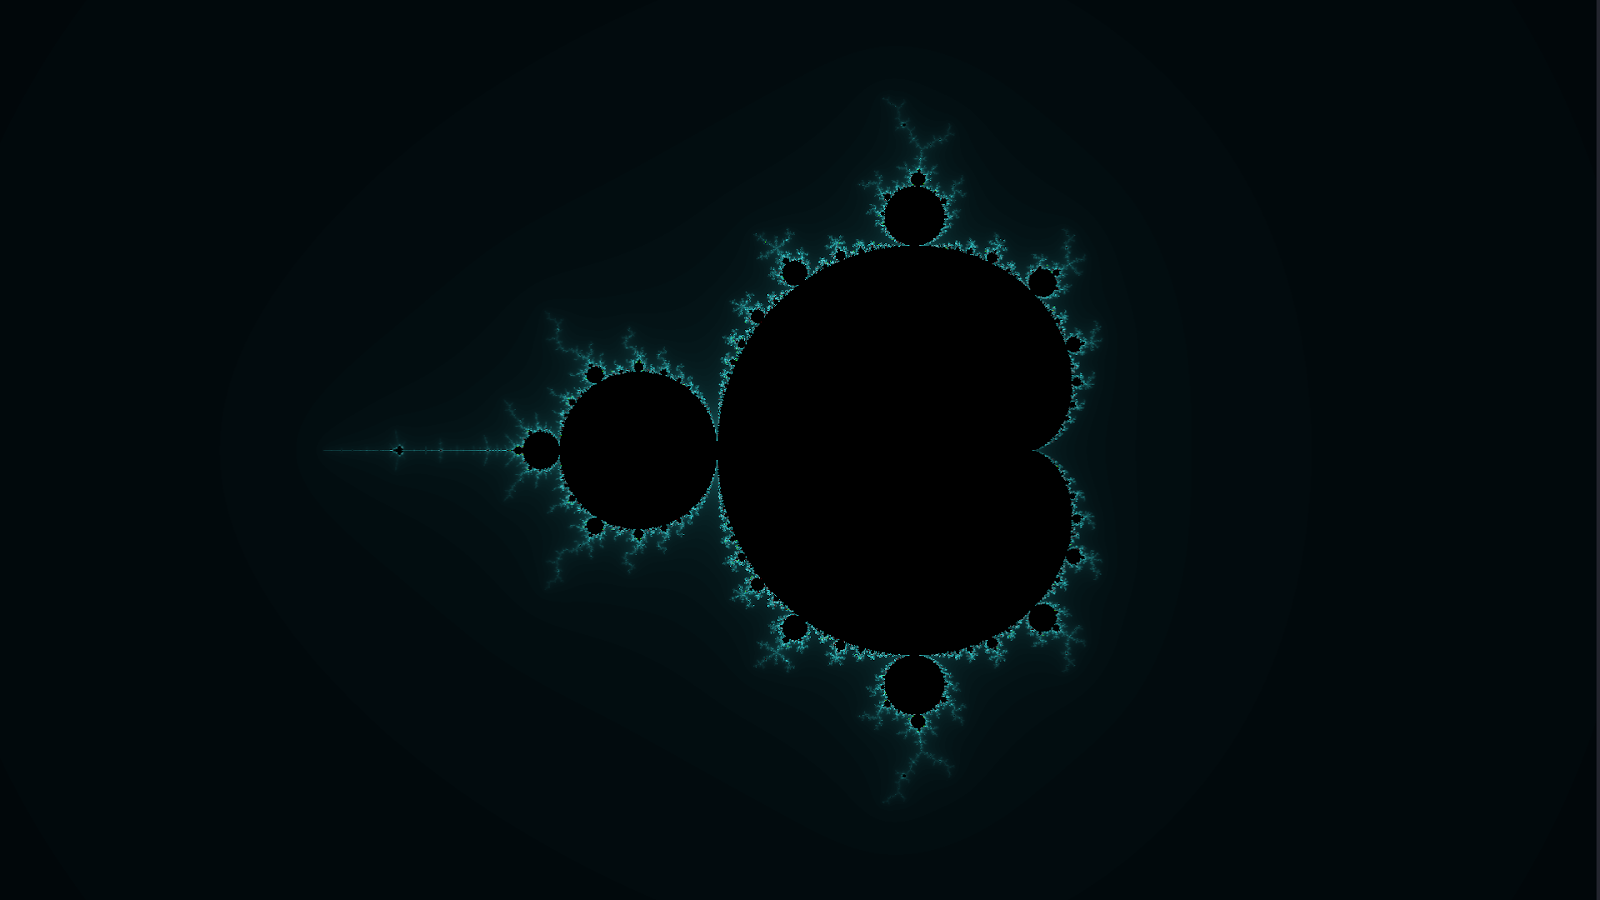
Разгон Мандельброта: SIMD с бубнами, OpenMP и CUDA
2025-03-22 в 10:16, admin, рубрики: c++, CUDA, openmp, simd, мандельброт, оптимизацияПостроение множества Мандельброта — классический пример чрезвычайно параллельной задачи (embarrassingly parallel problem).
Вначале мы разберем наивную реализацию, поиграемся с интринсиками (intrinsics) и, не теряя переносимости, заставим компилятор генерировать нам SIMD-инструкции. Далее добавим многопоточность и в заключение обесценим все наши старания несколькими строчками на CUDA.
Читать полностью »
Сортировка слиянием на CUDA
2025-03-19 в 13:01, admin, рубрики: CUDA, merge sort, Nvidia, ruvds_переводы, алгоритмы сортировки, сортировка слиянием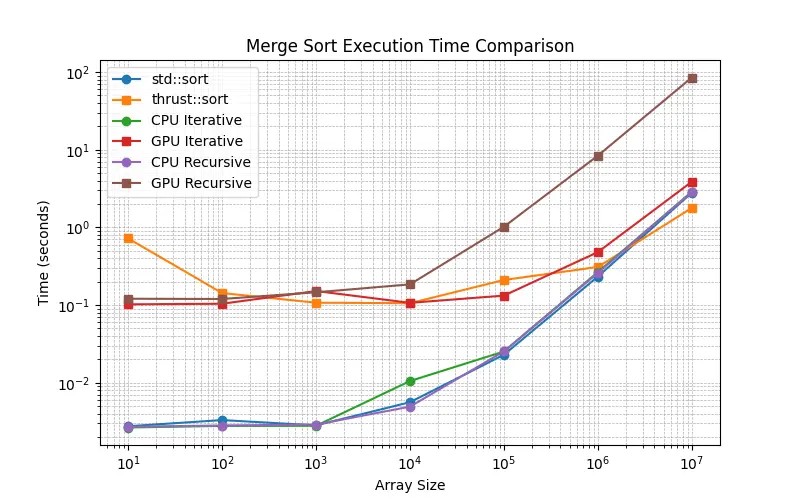
Я решил изучить, как повысится производительность алгоритмов сортировки при их реализации на CUDA. Моя цель — понять, как можно использовать мощь параллельных вычислений для ускорения алгоритмов сортировки.
В качестве тестового я возьму алгоритм сортировки слиянием (merge sort), потому что он удобно разбивает задачу на меньшие подзадачи с двумя равными половинами, что хорошо подходит для параллельных вычислений.Читать полностью »
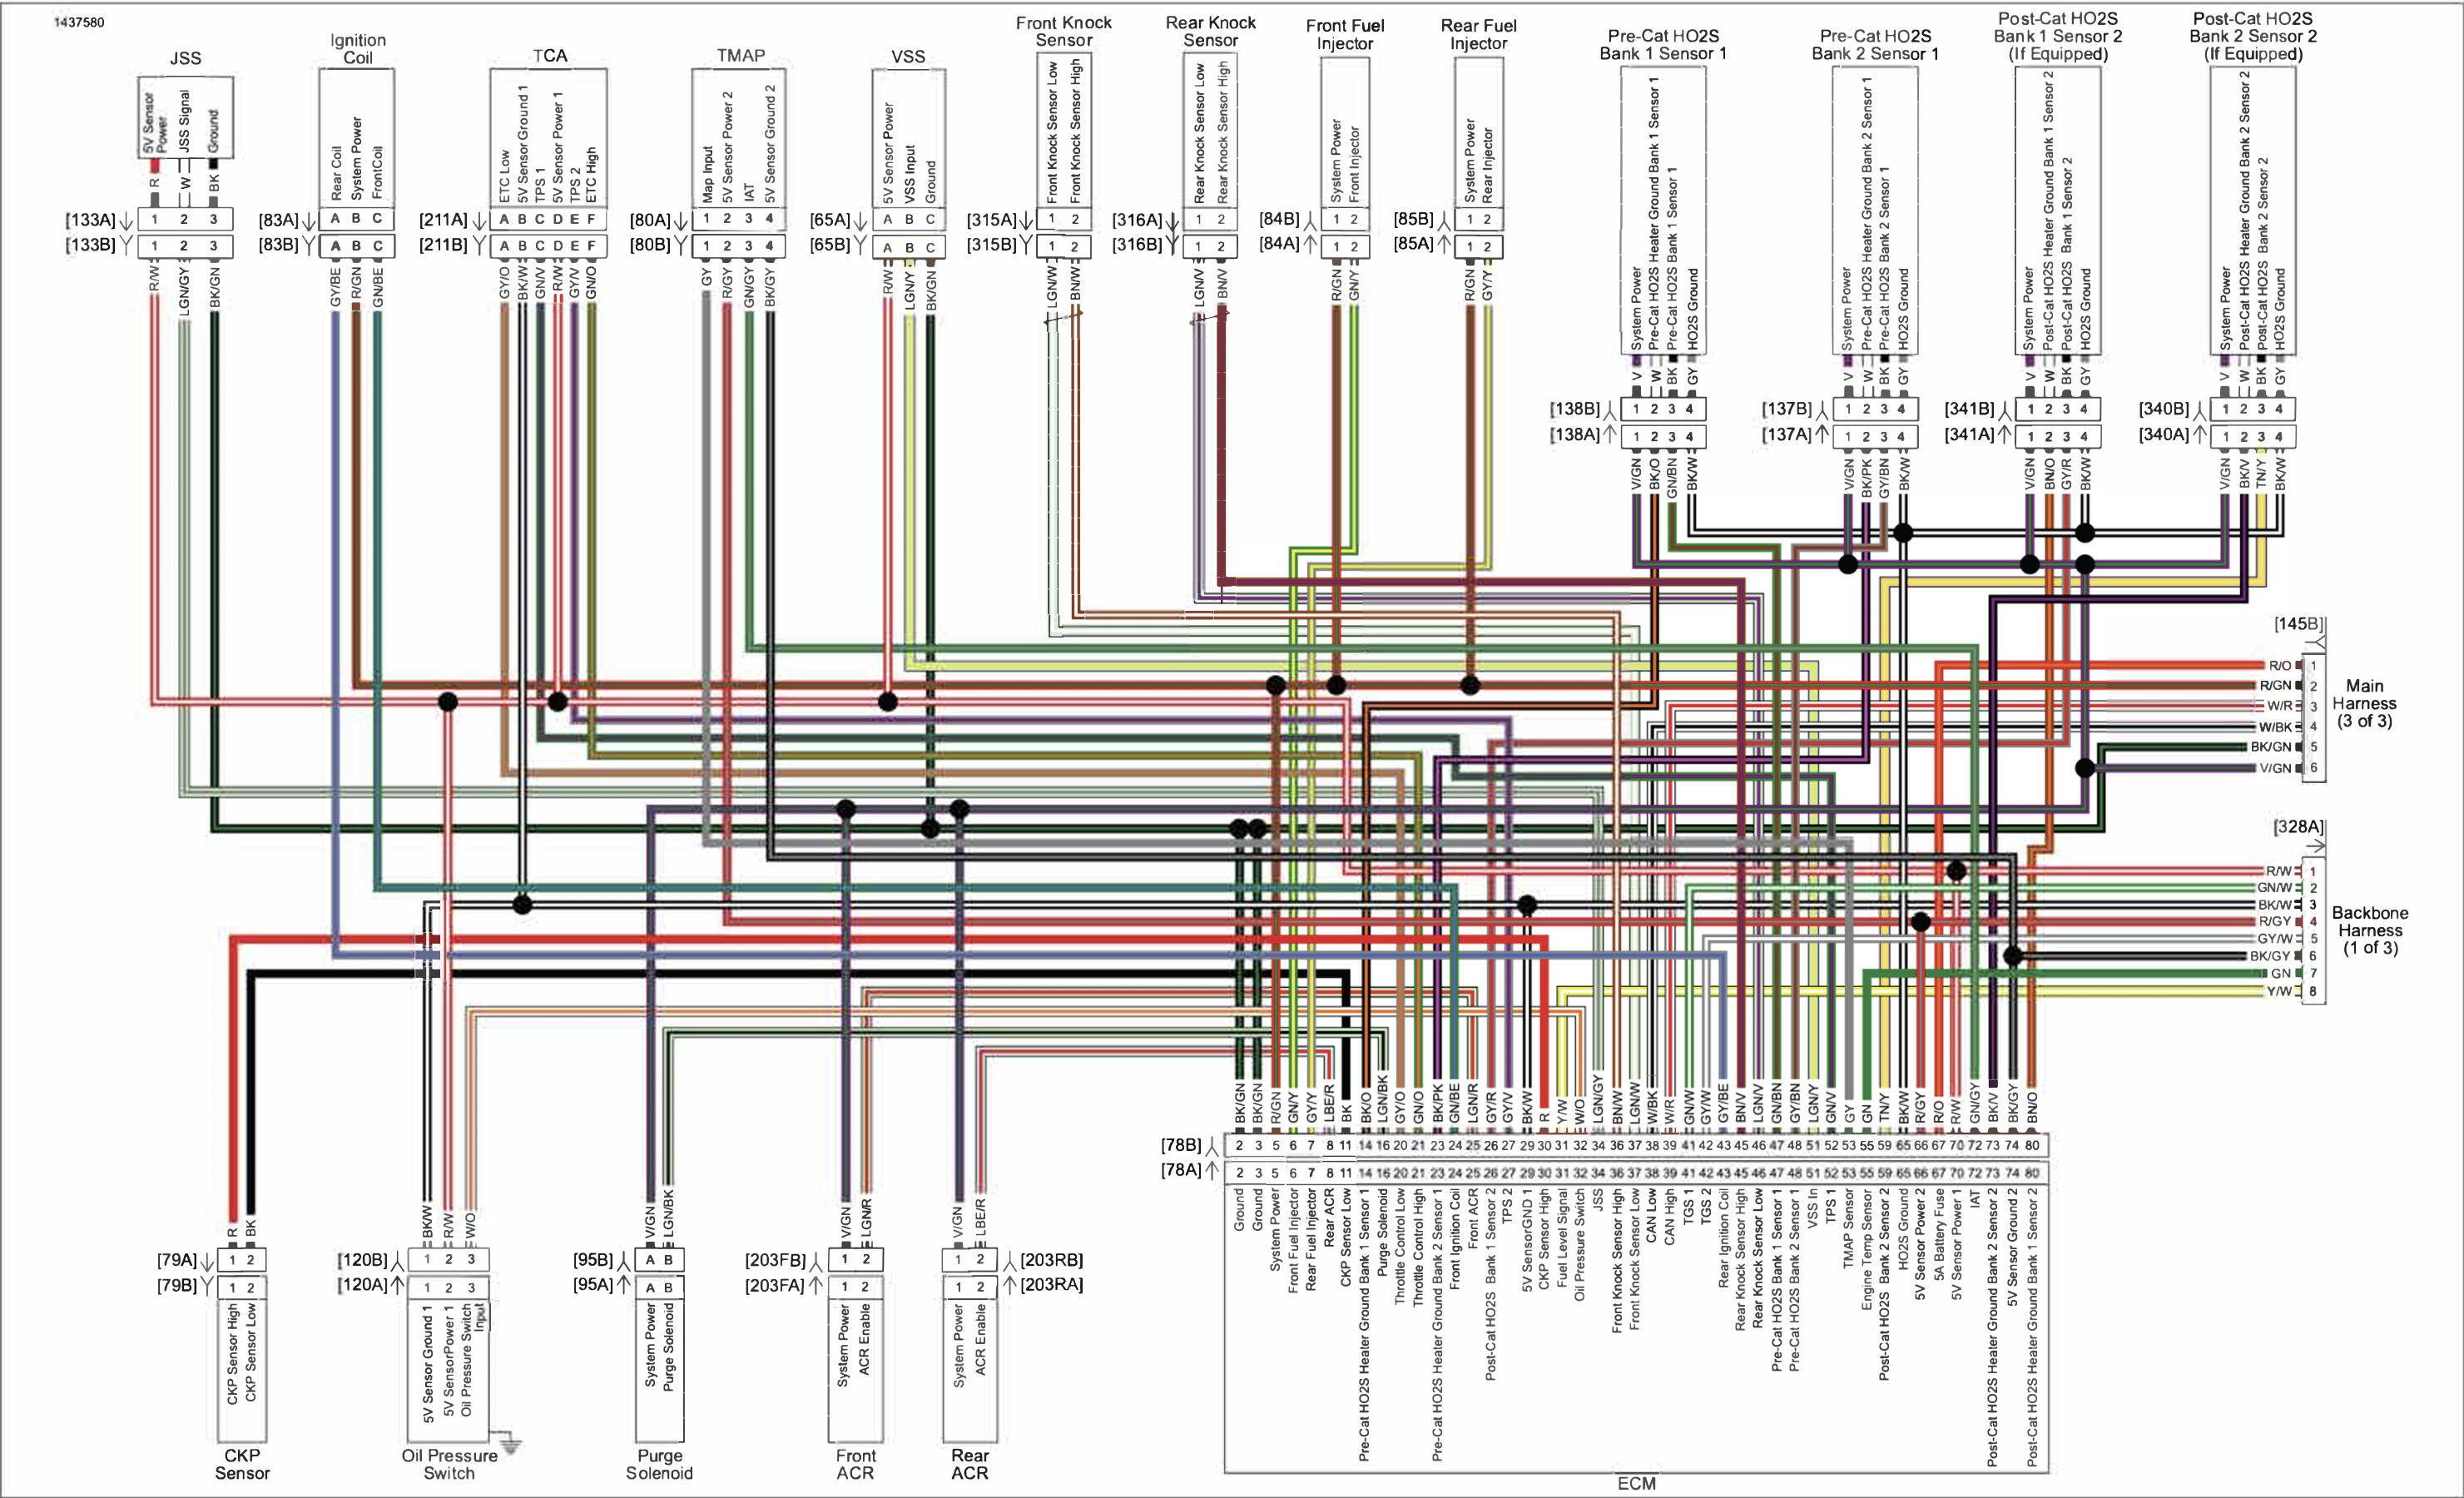
Как взломать Harley Davidson. Часть 2
2025-01-15 в 0:00, admin, рубрики: crc64, CUDA, exploit, Nvidia, obd2, udsВ прошлой части дизассемблировали код прошивки ECM последнего поколения мотоциклов в Ghidra, подправили его и запустили на тестовой плате Aurix TC275 Lite Kit, получили возможность обмениваться с ним сообщениями CAN и отлаживать его в winIDEA. Теперь настало время посмотреть, что же там интересного.
Глава 1. Цифровая шина мотоцикла
Intel oneAPI: обзор амбизициозной платформы для ИИ и научных вычислений от Intel для всех архитектур и производителей
2024-12-18 в 10:10, admin, рубрики: CUDA, GPU вычисления, intel, oneapi, oneapi toolkit, ruvds_статьи, гетерогенные вычисления, искусственный интеллект, платформа для разработчиков, портирование приложений
Представьте, что вы можете запустить одну и ту же программу на любом компьютере, будь то ваш домашний ПК, игровая консоль или даже суперкомпьютер. Звучит фантастично? Intel с 2020 года работает над тем, чтобы сделать это реальностью с помощью платформы oneAPI. Эта инновация обещает не только изменить то, как мы используем искусственный интеллект, но и упростить процесс разработки программного обеспечения. Вместо того чтобы адаптировать код под каждую платформу, разработчики смогут писать универсальные приложения, которые будут эффективно работать на самых различных устройствах, обеспечивая при этом высокую производительность. Более того, уже сейчас на платформу портируют код CUDA, вроде проектов как интерфейс Stable Diffusion 1111.
Но что это значит для обычного пользователя?Читать полностью »
Интеграция поддержки Nvidia в контейнерах
2024-12-10 в 10:30, admin, рубрики: cdi, container runtime, cri-o, CUDA, intel, kubernetes, Nvidia, runtimeclass, Видеокарты, контейнерыВидеокарты играют важную роль в современных компьютерах и используются не только для игр, но и других задач. Видеокарты в современном мире применяются как ускорители вычислений. В них одновременно выполняется множество вычислений, что делает их особенно эффективными для специфических задач, таких как нейронные сети. Поэтому видеокарты сейчас востребованы и активно применяются. В dBrain.cloud мы используем видеокарты Nvidia с платформой CUDA, которая позволяет писать код, исполняемый на графическом адаптере.