Рубрика «big data» - 136

Настройка маленького кластера Hadoop 2.2.0 с нуля

В данной статье будет по шагам разобран процесс создания небольшого кластера Hadoop для опытов.

Несмотря на то, что в интернете на иностранных ресурсах есть полно материала про настройку/развертывание Hadoop, большинство из них либо описывают настройку ранних версий (0.X.X и 1.X.X), либо описывают только настройку в режиме single mode/pseudo distributed mode и лишь частично fully distributed mode. На русском языке материала практически нет вовсе.

Когда мне самому понадобился Hadoop, то я далеко не с первого раза смог все настроить. Материал был неактуален, часто попадались конфиги, которые используют deprecated параметры, поэтому использовать их нежелательно. А даже когда все настроил, то задавался многими вопросами, на которые искал ответы. Также встречались похожие вопросы у других людей.

Всем кому интересно, прошу пожаловать по кат.
Читать полностью »

IBM PureData для Hadoop: чем эта система может мне помочь?Сегодня в компаниях информация выстраивается и хранится, как правило, несколькими способами и на нескольких платформах. Данные существуют в неструктурированном, неоптимизированном виде, что не позволяет извлекать из них информацию, необходимую для принятия стратегически важных решений. Роль Больших данных в этом сценарии заключается в возможности собирать такую информацию из различных входных данных, структурировать ее и выдавать данные для использования при анализе, при принятии решений и при работе со средствами предиктивной аналитики. Новейшая из систем IBM PureSystems объединяет в себе концепцию «Больших данных» и решение Apache Hadoop, исходя именно из таких задач.
Читать полностью »

Cassandra (далее C*) ограничивает WHERE запросы из-за своей внутренней структуры. Эта статья вам покажется сложной, запутанной, если вы не читали первую статью из цикла, где я рассказывал как устроена С*. Прочтите её, пожалуйста, прежде чем приступать к этой.

Цель этой статьи — выступать справочником для C* новичков.

Некоторые отличия CQL от SQL

В SELECT запросах Cassandra Query Language (CQL) отсутсвутют привычные нам SQL операции JOIN, GROUP BY. А операция WHERE сильно урезана. В SQL вы можете фильтровать по любой колонке, тогда как в CQL только по распределительным ключам (partition key), кластерным ключам (clustering columns) и вторичным индексам.

Заметка: В С* 2.0 можно создавать вторичные INDEX-ы у любой колонки наподобие SQL индексов. Фактически же, вторичные индексы Кассандры — это скрытая от вас дополнительная таблица, поэтому производительность WHERE запросов по ним хуже запросов по ключевым колонкам.

Читать полностью »

В предыдущей статье я доходчиво рассказал как Cassandra хранит данные. Настоятельно рекомендую хотя бы пробежаться глазами. В этой статье мы создадим простенькую БД, чтобы использовать её в следующей статье, которая будет полностью посвящена выборке/поиску данных.

Задача

Допустим у нас есть ad network, который откручивает рекламу. Люди кликают на баннеры, заказчик рекламы платит, мы (сеть), реселлеры (распространители) и хостеры рекламного места имеем на этом доход. Реселлеры рекламного места работают за 20%. Этот процент растёт из-за различных факторов, самое главное, что он не постоянен и новый процент может применяться, например, на клики месячной давности.

Нужно: быстро уметь считать доход каждого реселлера за любой промежуток дней, вести график кликов в режиме реального времени.
Читать полностью »

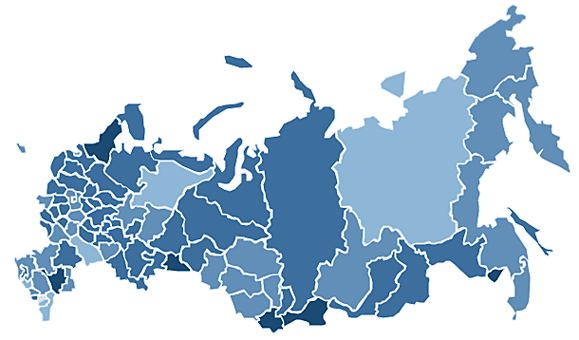
Бытует мнение, что в соцсетях сплошной негатив, что осень — депрессивное время года, что жители мегаполисов — озлобленные, а в регионах — и вовсе жизни интернета нет. Новое исследование наших партнёров опровергает сразу все досужие домыслы: за последние полгода позитивных эмоций в рунете стало больше! Расположение сообщений о любви и ненависти по регионам России под катом.
image
Читать полностью »

Статья предназначена для людей пытающихся создать свою первую «таблицу» в БД Cassandra.

За посление несколько релизов Кассандры разработчики взяли правильный вектор направленный на простоту использования этой базы данных. Учитывая её достоинства, такие как скорость работы и отказоустойчиваость, её было сложно как администрировать, так и писать под неё. Сейчас же количество танцев с бубном, которые надо провести прежде чем запустить и начать разрабатывать, свели к минимуму — несколько комманд в bash или один .msi в Windows.
Более того, сильно облегчил жизнь разработчикам недавно обновлённый CQL (язык запросов), вытеснив бинарный и довольно сложный язык Thrift.
Лично я столкнулся с проблемой наличия отсуствия русскоязычных руководств по Кассандре. Самую, на мой взгляд, сложную тему мне бы хотелось поднять в этой статье. Как же дизайнить базу данных то?

  • Статья НЕ предназначена для людей, которые впервые видят слово Cassandra.
  • Статья НЕ служит как рекламный материал той или иной технологии.
  • Статья НЕ стремится доказать что-либо кому-либо.
  • Если скорость записи/чтения не так важна, и если «100% uptime» не сильно нужен, и если у вас всего лишь несколько миллионов записей, то, вероятно, эта статья, да и вся Cassandra в целом, — не то, что вам нужно.

Ликбез

  • Cassandra (далее C*) — распределённая NoSQL БД, поэтому все решения «почему так, а не вот так» всегда принимаются с оглядкой на кластеризацию.
  • CQL — это SQL-подобный язык. Аббревиатура от Cassandra Query Language.
  • Node (нода) — инстанс C*, или java процесс в терминах операционных систем. На одной машине можно запустить несколько нод, например.
  • Основная единица хранения — строка. Строка целиком хранится на нодах, т.е. нет ситуаций когда полстроки — на одной ноде, полстроки — на другой. Строка может динамически раширяться до 2 миллиардов колонок. Это важно.
  • cqlsh — коммандная строка для CQL. Все примеры ниже выполняются именно в ней. Является частью дистрибутива C*.

Основное правило моделирования данных в C*

Кассандра создавалась как распределённая БД с упором на максимальную скорость записи и чтения. Моделировать «таблицы» нужно в зависимости от SELECT запросов вашего приложения.
В SQL мы привыкли накидать таблиц, связей между ними, и потом уже SELECT ... JOIN ... чего хотим и как хотим. Именно JOIN-ы основная проблема с произвоидтельностью в RDBMS. Их нет в CQL.

Первый пример.

У нас есть сотрудники какой-то компании. Создадим таблицу (которые на самом деле называются Column Family, но для простоты перехода с SQL на CQL используют слово table) на CQL и заполним данными:

CREATE TABLE employees (
    name text,
    age int,
    role text,
    PRIMARY KEY (name)
);
INSERT INTO employees (name, age, role) VALUES ('john', 37, 'dev');
INSERT INTO employees (name, age, role) VALUES ('eric', 38, 'ceo');

Таблицы в C* обязаны иметь PRIMARY KEY. Он используется для поиска ноды, в которой хранится искомая строка.

Прочитаем данные:

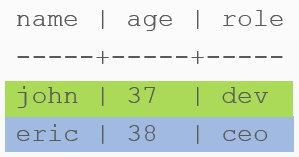
SELECT * FROM employees;

Эта картинка — руками разукрашенный вывод cqlsh.
Моделирование данных в БД Cassandra 2.0 на CQL3

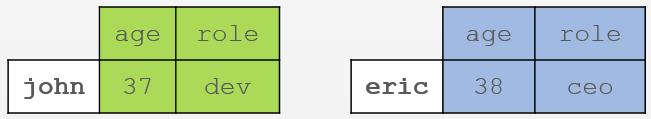
Выглядит как обычная таблица из реляционной БД. C* создаст две строки.
Моделирование данных в БД Cassandra 2.0 на CQL3
Внимание! Это две внутренние структуры строк, а не таблицы. Если чуть слукавить, то можно сказать, что каждая строка — это как маленькая таблица. Далее понятней.
Читать полностью »

9 декабря в Екатеринбурге пройдет первая в России конференция, посвященная NoSQL-хранилищу Cassandra. Мы уже сформировали программу CassandraConf.ru и приглашаем присоединиться как опытных разработчиков, так и тех, кто хочет познакомиться с Cassandra впервые!

Участие в конференции бесплатное — приезжайте!

Под катом — программа мероприятия и подробности
image

Читать полностью »

image

В предыдущей публикации мы подробно рассмотрели процесс развертывания кластера Hadoop на базе Cloudera. В этой статье мы хотели бы подробно рассказать о методах и инструментах для сбора данных в Hadoop. Загрузить данные в систему можно как с помощью простого копирования в HDFS, так и с помощью специальных инструментов.
Читать полностью »

image
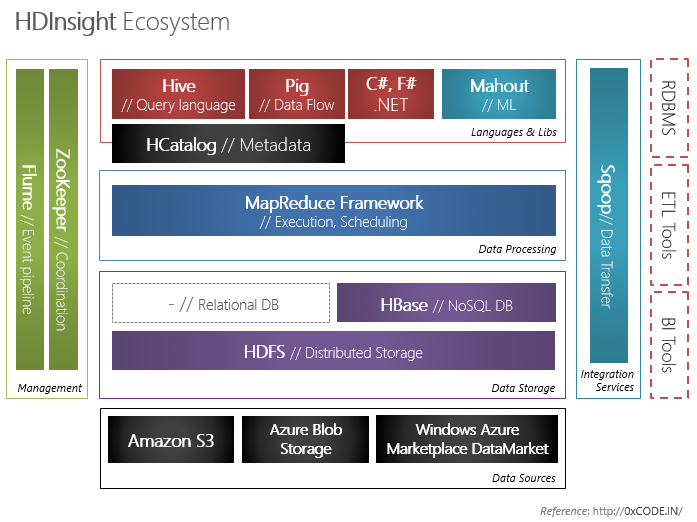
Некоторое время назад, в рамках конференции Strata + Hadoop World был анонсирован выход в коммерческой эксплуатацию Windows Azure HDInsight — облачного сервиса 100% совместимого с Apache Hadoop. Подробности о истории появления сервиса и его возможностях можно найти в этой статье на Хабре. Об анонсах конференции Strata + Hadoop World можно прочитать в другой свежей статье.

В этой статье речь пойдет о внутреннем устройстве кластеров HDInsight, старте работы с ними и первых задачах и запросах к Hive. В конце статьи приводятся реальные примеры использования Windows Azure HDInsight крупными международными организациями.

Windows Azure HDInsight предлагает следующие преимущества для своих пользователей:

  • Работа с большими данными с помощью знакомых инструментов: благодаря глубокой интеграции с инструментами бизнес-аналитики от Microsoft, такими как PowerPivot, Power View и Excel, сервис HDInsight позволяет вам легко анализировать ваши данные с помощью возможностей Hadoop. Прозрачно объединяйте данные из различных источников данных, включая HDInsight с помощью Power Query. Легко анализируйте и визуализируйте географические данные с помощью Power Map – новый картографический 3D-инструмент в Excel 2013;
  • Гибкость – HDInsight предлагает гибкость соответствующую изменениям потребностей вашей организации. С богатый набором скриптов PowerShell вы можете размещать и администрировать кластер Hadoop за считанные минуты вместо привычных часов или даже дней. Если вам нужен кластер большего размера, просто удалите существующий и создайте новый нужного размера в течении нескольких минут без потери каких либо данных;
  • Hadoop корпоративного уровня: HDInsight предлагает безопасность и управляемость корпоративного уровня. Благодаря выделенному узлу Secure Node, сервис HDInsight помогает обезопасить ваш кластер Hadoop. В дополнение, мы упростили управление вашим кластером Hadoop с помощью внушительного набора скриптов PowerShell;
  • Богатые возможности для разработчиков: сервис HDInsight предлагает мощные возможности для разработки приложений с богатым выбором языков, включая .NET, Java и другие. Разработчики на платформе .NET могут воспользоваться мощью запросов LINQ to Hive.

Читать полностью »

За последние пол месяца произошло 3 ИТ-события, лежащие в плоскости Big Data, Cloud Computing и на их симбиозе. По странному стечению обстоятельств эти события остались без должного внимания как со стороны хабросообщества, так и со стороны немногочисленных профессиональными сообществ в LinkedIn и Facebook.

Эти событий — конференция Strata + Hadoop World, релиз стабильной версии Hadoop 2.2.0 и облачного сервиса Windows Azure HDInsight. О косвенной и прямой связи этих событий речь и пойдет ниже.

Также ниже я приведу ссылки на ресурсы, которые будут более полезными, чем любой вольных пересказ содержимого этих ресурсов.

HDInsight Ecosystem
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js