
Рубрика «cache» - 8

Вышла новая версия Caché 2013.1 Что нового?

Развитие функционала

  • дальнейшее развитие EXtreme Event Persistence;
  • поддержка WebSocket;
  • расширенная поддержка JSON;
  • новый редактор панелей в BI DeepSee.

Повышение скорости разработки

  • multiсompile классов;
  • новая команда COS return;
  • args по ссылке;
  • %Find для Caché SQL.

Улучшение производительности

  • производительность обработки XML +50%;
  • улучшение производительности de-journaling;
  • повышение производительности ROLLBACK до 20%;
  • увеличение лимита глобального буфера до 16 ТБ;
  • увеличение лимита разделяемой памяти до 1 ТБ;
  • построение индексов класса с минимальным временем простоя — %Library.IndexBuilder;
  • эскалация блокировок;
  • увеличение производительности конкурентных обновлений — до 30%.

Полная версия документа на английском языке.
Обо всем по порядку и о других изменениях версии под катом.
Читать полностью »
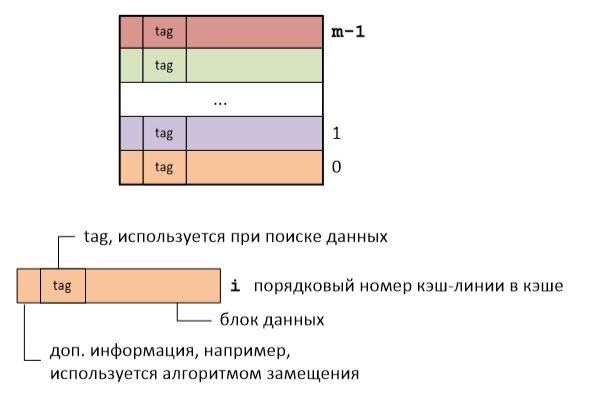
На днях решил систематизировать знания, касающиеся принципов отображения оперативной памяти на кэш память процессора. В результате чего и родилась данная статья.

Кэш память процессора используется для уменьшения времени простоя процессора при обращении к RAM.

Основная идея кэширования опирается на свойство локальности данных и инструкций: если происходит обращение по некоторому адресу, то велика вероятность, что в ближайшее время произойдет обращение к памяти по тому же адресу либо по соседним адресам.

Логически кэш-память представляет собой набор кэш-линий. Каждая кэш-линия хранит блок данных определенного размера и дополнительную информацию. Под размером кэш-линии понимают обычно размер блока данных, который в ней хранится. Для архитектуры x86 размер кэш линии составляет 64 байта.

Логическая организация кэш памяти процессора

Так вот суть кэширования состоит в разбиении RAM на кэш-линии и отображении их на кэш-линии кэш-памяти. Возможно несколько вариантов такого отображения.
Читать полностью »

Данная тема важна при разработке любого приложения, взаимодействующего с сетью. Здесь грамотное использование возможностей системы может значительно улучшить взаимодействие пользователя с программой.

NSURLCache — это комплексное решение для кеширования сетевых запросов в оперативной памяти или на диске. В соответствии с документацией Apple, любой запрос с использованием NSURLConnection будет «пропущен» через NSURLCache.

Кеширование уменьшает количество необходимых обращений к сети, улучшает впечатление от работы с программой во время полного отсутствия интернета или проблем с сетевым соединением.
Читать полностью »

Начало см. часть 1, часть 2.

Вторичные индексы

В реляционных базах данных вторичные индексы задаются как правило при определении таблиц, или после с помощью ALTER TABLE. Если индекс определён, то он автоматически создаётся, а потом поддерживается и пересчитывается базой данных при изменении данных.

В MUMPS индексы обслуживаются явно программистом, например, в функции обновления таблицы.
Читать полностью »

image
С 7 по 11 апреля в г. Орландо, Флорида состоялся очередной InterSystems Global Summit 2013. Это ежегодное событие собирает сотни разработчиков и партнеров компании InterSystems со всего мира. В рамках саммита топ-менеджмент InterSystems объявляет об итогах работы компании за год, проводятся лекции и семинары с hands-out по новинкам и лучшим практикам в работе с технологиями InterSystems. Под катом небольшой фоторепортаж с InterSystems Global Summit 2013.
Читать полностью »

В стандартных хранимых классах Caché при модификации записи прежние значения свойств исчезают безвозвратно. Но бывают случаи, когда это нежелательно, когда «все ходы должны быть записаны». В первую очередь, конечно, такое требование возникает при разработке приложений для материально ответственных лиц, для которых критична возможность, например, отменить ошибочное действие и восстановить состояние документа на заданное время, или, что ещё важнее, провести расследование инцидента с попыткой злоумышленника «замести следы» в базе.
В этой статье демонстрируется, как реализовать хранение и восстановление версий для объектов Caché.
Читать полностью »

Начало см. часть 1.

Глава 2. SQL/реляционные БД против MUMPS

В этой главе будут изложены основные различия между обычными SQL реляционными базами данных и БД на основе MUMPS.

Прочитайте главу 1, если вам нужно лучше понять что такое глобалы и как делаются манипуляции с ними.
Читать полностью »

Примечание от переводчика.

Есть интересная технология в мире БД — MUMPS. Этот язык программирования и доступа к данным известен уже несколько десятилетий, отлажен и является взрослой проверенной технологией.

Приведу аналогию: если SQL можно сравнить с Бейсиком, то MUMPS больше похож на Си — даёт высочайшую производительность и гибкость.

Перед вами перевод первой части статьи «Extreme Database programming with MUMPS Globals». Если сообществу он покажется интересным, то последует перевод второй части.

Читать полностью »

Предположим, что у вас есть таблица с большим количеством записей и в неё нужно добавить один или несколько индексов со следующими условиями:

  1. их генерация должна быть максимально быстрой
  2. чтобы генерацию можно было производить порциями.
    К примеру, если есть таблица на 300М записей и работы с ней можно производить только в нерабочее время, то чтобы можно было разбить весь процесс на три ночи по 100М записей
  3. появление новых индексов и сам процесс их генерации не должны мешать текущей работе с классом/таблицей

Для этого можно было бы воспользоваться уже известным методом %BuildIndices(), но в таком случае это не будет удовлетворять нашим условиям.

Каков же выход?
Читать полностью »

У современных процессоров архитектуры Core i7 существует очевидный, документированный, но отчего-то не очень известный даже среди многих специалистов сценарий priority inversion. Его я опишу в этом посте. В нем есть код на С, три диаграммы, и некоторые подробности работы кэшей в процессорах архитектуры Core i7. Никаких покровов не срывается, вся информация давно общедоступна.

Priority inversion – ситуация, когда низкоприоритетный процесс может блокировать или замедлять высокоприоритетный. Обычно имеется в виду очередность доступа к исполнению на ядре для высокоприоритетного кода относительно низкоприоритетного. С этим должно неплохо справляться ядро ОС. Однако помимо вычислительных ядер, которые несложно распределять посредством affinity и MSI-X, в процессоре есть ресурсы, общие для всех задач – контроллер памяти, QPI, общий кэш третьего уровня, PCIe устройства. В вопросы PCIe я углубляться не буду, т.к. не являюсь экспертом в данной теме. Priority inversion на почве доступа к памяти и QPI я давно не наблюдал – пропускной способности современного многоканального контроллера как правило хватает и высокоприоритетным, и низкоприоритетным задачам. Остановлюсь на кэшах.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js