
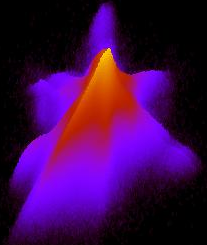
Данная статья повествует о пользе низкоуровневых вычислений
на примере атласа звездных объектов 2MASS.
2MASS — это ~471 млн. объектов, для которых приведены координаты,
а также сопутствующая информация, всего 60 атрибутов.
Физически — это 50Гб исходных гзипнутых текстовых файлов.
Можно ли работать с такой базой, не прибегая к «тяжелой артиллерии»?
Давайте попробуем.
Читать полностью »
Рубрика «data mining» - 89
Gnuplot супротив 2MASS
2013-12-03 в 4:53, admin, рубрики: data mining, diy или сделай сам, Геоинформационные сервисы, жесть, метки: жестьПромежуточные итоги биржевого стартапа
2013-11-28 в 10:21, admin, рубрики: bitcoin, data mining, ECN, ECN/STP, алготрейдинг, арбитраж, биржа, Криптовалюты, Финансы для всех, метки: ECN, ECN/STP, алготрейдинг, арбитраж, биржа, КриптовалютыБиржа, как стартап. Звучит довольно необычно. Сразу в голову лезет огромное количество юридических моментов, регуляторских замутов и т.д. Казалось бы, просто так не начать.
Но, как многим известно, существуют удачные попытки противостоять бюрократии финансового мира. История этого противостояния носит, конечно же, во многом виртуальную составляющую — электронные платежные системы. А как мы хорошо знаем, мир софта, пусть и виртуальный, при должном умении и упорстве вполне реально монетизируется.
Историю развития такого противостояния/дополнения можно долго расписывать. Но мы остановимся на одном из крайних событий этого фронта: криптовалюты. И даже еще сузим повествование: криптовалютные биржи.
Сразу скажу, чтобы полностью понять материал, пусть и написанный старательно общедоступным языком, все же придется потрудиться и ознакомиться с ликбезом.
Почему Excel опасен как инструмент для бизнес-анализа (business intelligence)?
2013-11-22 в 15:15, admin, рубрики: Business Intelligence, data mining, Excel, бизнес аналитика  Уверен, что с заголовком многие не согласятся, но все же оставлю как есть, потому что абсолютно в этом уверен:Читать полностью »
Уменьшение размерности задачи линейной бинарной классификации(e.g. SVM)
2013-11-21 в 2:03, admin, рубрики: data mining, SVM, Алгоритмы, математика, машинное обучение, метки: SVM, машинное обучениеТребуемые знания: знакомство с методами линейной бинарной классификации(e.g. SVM(см. SVM Tutorial)), линейная алгебра, линейное программирование
Рассмотрим линейную задачу бинарной классификации(если задача линейно неразделима, её можно свести к таковой с помощью симметричного интегрального L-2 ядра(см. SVM)).  При решении такой задачи классифицируемые элементы(далее образцы) представляются в виде элементов векторного пространства размерности n. На практике в таких задачах n может быть чрезвычайно большим, например для задачи классификации генов оно может исчисляться десятками тысяч. Большая размерность влечёт, по-мимо высокого времени вычисления, потенциально высокую погрешность численных рассчётов. Кроме того использование большой размерности может требовать больших финансовых затрат(на проведение опытов). Постановка вопроса такова: можно ли и как уменьшить n отбрасыванием незначимых компонент образцов так, чтобы образцы разделялись «не хуже» в новом пространстве(эмпирическая ошибка не возросла или, что тоже самое, в новом пространстве образцы оставались линейно разделимы) или «не сильно хуже».
В своей статье я хочу для начала провести краткий обзор метода из этой статьи Gene_Selection_for_Cancer_Classification_using, после чего предложить свой метод.
Читать полностью »
Автоматическая проверка орфографии, модель Noisy Channel
2013-11-20 в 15:27, admin, рубрики: data mining, алгоритм, Алгоритмы, вероятность, искусственный интеллект, орфография, расстояние дамерау-левенштейна, расстояние Левенштейна, метки: алгоритм, вероятность, орфография, расстояние дамерау-левенштейна, расстояние Левенштейна  Доброго времени суток. На днях у меня возникла задача по реализации алгоритма пост-обработки результатов оптического распознавания текста. Для решения этой проблемы не плохо подошла одна из моделей для проверки орфографии в тексте, хотя конечно слегка модифицированная под контекст задачи. Этот пост будет посвящен модели Noisy Channel, которая позволяет осуществлять автоматическую проверку орфографии, мы изучим математическую модель, напишем на c# немного кода, обучим модель на базе Питера Норвига, и под конец протестируем то что у нас получится.
Процессинг текстовых объектов в ERP-системах
2013-11-20 в 14:13, admin, рубрики: data mining, ERP-системы, nlp, Алгоритмы, обработка текстов, метки: nlp, обработка текстовНеобходимость сложной обработки текстовых данных, хранящихся в ERP-системах (и не только) возникает достаточно часто. В качестве вводных примеров можно привести следующие:
- Унификация наименований товарной номенклатуры
- Автоматическая расстановка формализованных атрибутов товаров на основании их наименований или описаний
- Преобразование почтовых адресов как с целью унификации так и для формального структурирования
- Определение пола человека по его имени
- Извлечение информации из примечаний к документам (например, для автоматического связывания записи из выписки с отгрузочными документами)
- и т.д. (фантазировать можно еще долго)
Основы анализа данных на python с использованием pandas+sklearn
2013-11-14 в 6:59, admin, рубрики: data mining, pandas, python, метки: data mining, pandas, python Добрый день уважаемые читатели. В сегодняшней посте я продолжу свой цикл статей посвященный анализу данных на python c помощью модуля Pandas и расскажу один из вариантов использования данного модуля в связке с модулем для машинного обучения scikit-learn. Работа данной связки будет показана на примере задачи про спасенных с "Титаника". Данное задание имеет большую популярность среди людей, только начинающих заниматься анализом данных и машинным обучением.
Читать полностью »
С 1 ноября по 6 декабря Викимарт проводит интернет-олимпиаду
2013-11-12 в 12:40, admin, рубрики: data mining, монетизация знаний, олимпиада, электронная коммерция, метки: монетизация знаний, олимпиадаПопробуйте решить интересные, сложные задачи, с которыми работает команда Викимарта, и получите вознаграждение при условии демонстрации лучшего результата.
Цель конкурса — предоставить всем желающим возможность исследования пользовательского поведения с коммерческим интентом и научиться предсказывать наличие определенного действия пользователя в сессии. Например, предсказать, откажется ли пользователь от созданного им заказа, станет сам оформлять заказ через сайт или позвонит в call-центр.
За каждую задачу участник может получить от 0 до 25 баллов в зависимости от места в рейтинге. Рейтинг по каждой задаче формируется по убыванию качества результата, мерой которого служит мера AUC (Area Under Curve). Суммарный рейтинг — это сумма баллов по всем задачам. Побеждает тот, кто наберет наибольшую сумму баллов. Предоставленные на конкурс результаты организатором не возвращаются.
ПРИЗЫ
1 место — 65 000 руб
2 место — 25 000 руб
3 место — планшет iPad mini 16Gb Wi-Fi+Cellular
Я параноик или Почему Большой Брат уже следит за нами
2013-11-12 в 8:14, admin, рубрики: big brother, data mining, Privacy, Блог компании «Maxifier Development», информационная безопасность, слежка, теория заговора, метки: big brother, Privacy, слежка, теория заговораНачал писать комментарий к собственному переводу статьи о приватности пользовательских данных и неожиданно понял, что он выливается в нечто большее.
Дело в том, что я занимаюсь технологиями data mining и text mining последние лет пятнадцать. И поэтому все недавние скандалы, связанные с делом Сноудена и PRISM, XKeyScore, Muscular, СОРМ, чтением почты Гуглом, передачей конфиденциальных и гео данных с мобильников, и множество прочих оставили меня абсолютно равнодушным.
По очень простой причине – я уже знаю, что Большой Брат давно существует.
Если точнее, я абсолютно в этом уверен – так же, как не могу знать, что Солнце завтра взойдет, но весьма и весьма в этом убежден. И все новые доказательства существования Большого Брата полезны, но уже не обязательны.
А объяснение уверенности очень простое: при наличии необходимых ресурсов я сам мог бы его построить.
Читать полностью »
Поведенческая реклама ≠ правительственная слежка. Пора внести ясность
2013-11-08 в 8:01, admin, рубрики: data mining, Блог компании «Maxifier Development», защита данных, информационная безопасность, персональные данные 
Комментарий переводчика:
В последнее время вопросы приватности данных и вторжения государства в частную жизнь не сходят со страниц газет и блогов. Поскольку для нас этот вопрос являлся ключевым с точки зрения бизнеса, регулярно как в профессиональных встречах, так и в личных беседах приходилось рассказывать и доказывать, чем же аккуратное использование данных для конкретных бизнес-целей отличается от слежки за пользователями Интернета. Поэтому статья, перевод которой приведен ниже, показалась мне очень актуальной.
Когда мы начинали разрабатывать алгоритмы для оптимизации интернет-рекламы в Maxifier, то вопрос доступности и конфиденциальности данных был одним из первых, от которых зависели и потенциальные возможности нашего продукта, и общее позиционирование компании. Для себя мы однозначно решили, что не будем использовать персонифицированные данные о пользователе, а работать только с усредненными статистическими данными. Да, это несколько обедняет алгоритмы. Да, результат для каждого конкретного человека будет чуть менее точным — т.к. мы будем использовать автоматически реконструированные шаблоны поведения, но не знания о поведении в сети этого конкретного пользователя. Создали самообучающуюся систему; со временем она становится все более «умной» — статистические знания о пользователях накапливаются, шаблоны уточняются. Такое решение позволило нам избежать всех проблем с последовавшими законами о конфиденциальности данных в Европе, например, из-за которых потом сильно пострадали все системы behavior targeting'a. А то, что мы изначально строили алгоритмы, предполагая высокий уровень шума и загрубленность данных, в дальнейшем нам даже позволило сделать это дополнительным конкурентным преимуществом — т.к. наш продукт работает в случаях недостатка информации или отсутствия доступа к ней из-за политики сайтов и рекламных сетей – в ситуациях, когда решения конкурентов- обладателей баз данных не справлялись по показателям качества.
Читать полностью »