
Всем привет, меня зовут Алена, я являюсь ML-специалистом в SimbirSoft. В этой статье я хочу рассказать о галлюцинациях больших языковых моделей, а именно о том, как их оценить и минимизировать.
Содержание
Всем привет, меня зовут Алена, я являюсь ML-специалистом в SimbirSoft. В этой статье я хочу рассказать о галлюцинациях больших языковых моделей, а именно о том, как их оценить и минимизировать.
Содержание
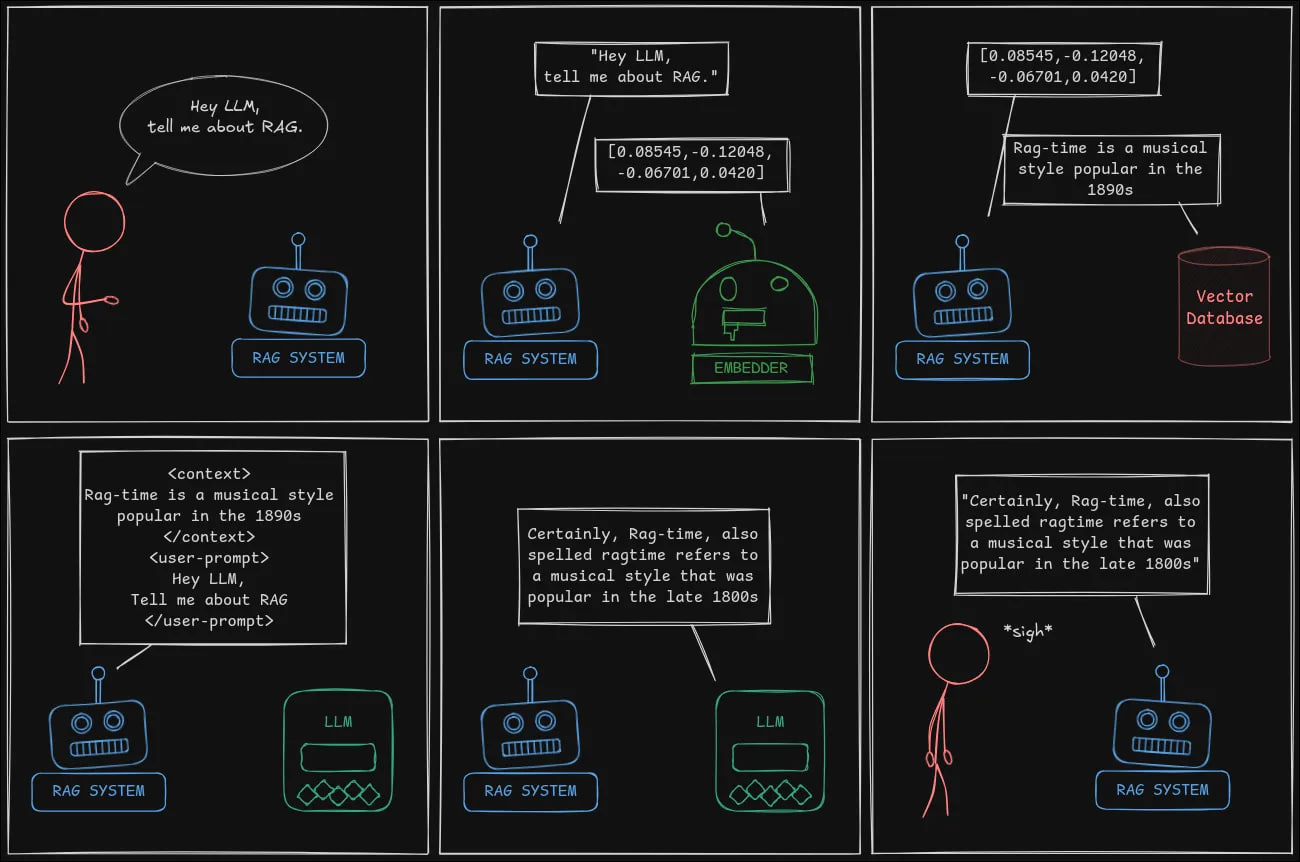
В этом посте я расскажу про подход, благодаря которому я занял первое место в обеих призовых номинациях и в общем SotA рейтинге.
RAG - это инструмент, расширяющий возможности LLM через “подключение” к ней базы знаний любого размера.
Появилась свободное время, и я решил сделать RAG (Retrieval Augmented Generation) для нашей компании. Компания небольшая, но документации технической и бизнес накопилось очень много, в основном на wiki.
Цель - подключить бота в slack, который быстро может выдать инфу по нужной теме.
Источник знаний:
Wiki
JIRA
Slack
Сегодня покроем только создание RAG из Wiki + создание бота. Писалось все за 2 дня, поэтому жутко не оптимально, но бот уже работает и выполняет свою функцию, дальше будет улучшать.
Для начал чуть-чуть теории. Из чего сделана любая RAG?
Парсинг данных из источника в текст (например в json)
В последние пару лет RAG (retrieval-augmented generation) стал одной из самых обсуждаемых технологий в области обработки текстов и поисковых систем. Его идея проста: объединить поиск (retrieval) и генерацию (generation), чтобы быстрее находить нужную информацию и создавать более точные тексты.
Процесс Retrieval-Augmented Generation (RAG) представляет собой довольно сложную систему, состоящую из множества компонентов. Вопрос о том, как определить существующие методы RAG и их оптимальные комбинации для выявления лучших практик, в настоящий момент остается наиболее актуальным. В этой статье я хочу поделиться своим опытом относительно реализации подходов и практик в области RAG систем, который реализует систематический подход к решению этой проблемы.
Типовые задачи процессов RAG систем
Классификация запросов,
Деление на фрагменты
Векторизация данных
Поиск,
Переранжирование,
Языковая модель DeepSeek R1 наделала много шума в начале этого года. Сначала в AI-сообществе с восхищением обсуждали, как китайцам удалось получить качество генерации текста на уровне передовых западных моделей при меньших затратах на обучение. Затем восторг сменился жёсткой критикой о политической предвзятости, копировании моделей OpenAI и доступности истории запросовЧитать полностью »
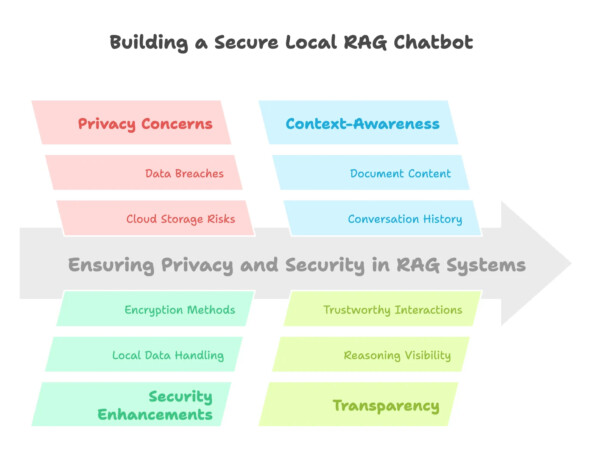
В 2024 году популярными словами и постоянной темой для обсуждения в IT были большие языковые модели (LLM), обработка естественного языка (NLP), искусственный интеллект и создание ценностей. Однако вкатиться в эту экосистему без подготовки может быть довольно сложно. Давайте начнём с того, что рассмотрим понятие генерации с дополненной выборкой (Retrieval Augmented Generation, RAG), чтобы лучше понять эту технологию и возможность её использования в наших цифровых продуктах.