Рубрика «big data» - 50

Всем привет!

В рамках нашего курса Data Scientist мы провели открытый урок на тему «Наивный баейсовский классификатор». Занятие вёл преподаватель курса Максим Кретов — ведущий исследователь в лаборатории нейронных сетей и глубокого обучения (МФТИ). Предлагаем ознакомиться с видео и кратким изложением.

Заранее спасибо.

Читать полностью »

image

Сегодня в Лондоне стартовала одна из главных Data Science конференций года, постараюсь оперативно рассказывать о том, что интересного удалось услышать.
Читать полностью »

Бизнес просит право на персональные данные пользователей - 1

Представители бизнеса, IT-компании, банки и операторы связи предложили поправки в закон «О персональных данных». В случае их принятия компании получат больше контроля над данными пользователей. Об этом пишут «Ведомости», которые ознакомились с текстом поправок.
Читать полностью »

Добрый день! Меня зовут Данил Липовой, наша команда в Сбертехе начала использовать HBase в качестве хранилища оперативных данных. В ходе его изучения накопился опыт, который захотелось систематизировать и описать (надеемся, что многим будет полезно). Все приведенные ниже эксперименты проводились с версиями HBase 1.2.0-cdh5.14.2 и 2.0.0-cdh6.0.0-beta1.

  1. Общая архитектура
  2. Запись данных в HBASE
  3. Чтение данных из HBASE
  4. Кэширование данных
  5. Пакетная обработка данных MultiGet/MultiPut
  6. Стратегия разбивки таблиц на регионы (спилитинг)
  7. Отказоустойчивость, компактификация и локальность данных
  8. Настройки и производительность
  9. Нагрузочное тестирование
  10. Выводы

Читать полностью »

Все организации, которые имеют хоть какое-то отношение к данным, рано или поздно сталкиваются с вопросом хранения реляционных и неструктурированных баз. Непросто найти одновременно удобный, эффективный и недорогой подход к этой проблеме. А еще сделать так, чтобы на данных смогли успешно работать дата-сайентисты с моделями машинного обучения. У нас получилось – и хотя пришлось повозиться, итоговый профит оказался даже больше ожидаемого. Обо всех подробностях расскажем ниже.

Из нагруженной MPP СУБД — бодрый Data Lake с аналитическими инструментами: делимся подробностями создания - 1
Читать полностью »

Мы собираем более двух миллиардов аналитических событий в сутки. Благодаря этому можем узнать кучу необходимых вещей: нажимают ли на сердечки больше, чем на звёздочки, в какие часы пишут более развёрнутые описания, в каких регионах чаще промахиваются по зелёным кнопкам.

Систему сбора и анализа событий можно обобщённо назвать кликстримом. Расскажу о технической стороне кликстрима в Авито: устройство событий, их отправка и доставка, аналитика, отчёты. Почему хочется своё, если есть Google Analytics и Яндекс.Метрика, кому портят жизнь разработчики кликстримов и почему go-кодеры не могут забыть php.

Ни GA, ни ЯМ. Как мы сделали собственный кликстрим - 1

Читать полностью »

Возможно, кто-то уже слышал о нас, но пока мы не повсеместно известные и хотим рассказать о себе. ONETRAK — это первый российский производитель умных браслетов. Мы появились в 2014 году, тогда же выпустили в продажу свои первые умные браслеты (ONETRAK Life и ONETRAK Sport).

С тех пор мы росли, делали новые гаджеты, а сейчас создаем экосистему устройств для мониторинга главных показателей здоровья (активности, питания, сна, артериального давления, пульса и т.д.) и сопутствующее программное обеспечение — приложения для Android, iOS и веба.
image
Читать полностью »

Время пополнять копилку хороших русскоязычных докладов по Machine Learning! Копилка сама не пополнится!

В этот раз мы познакомимся с увлекательным рассказом Андрея Боярова про распознавание сцен. Андрей — программист-исследователь, занимающийся машинным зрением в компании Mail.Ru Group.

Распознавание сцен — одна из активно применяемых областей машинного зрения. Задача эта посложнее, чем изученное распознавание объектов: сцена — более комплексное и менее формализованное понятие, выделить признаки труднее. Из распознавания сцен вытекает задача распознавания достопримечательностей: нужно выделить известные места на фото, обеспечив низкий уровень ложных срабатываний.

Это 30 минут видео с конференции Smart Data 2017. Видео удобно смотреть дома и в дороге. Для тех же, кто не готов столько сидеть у экрана, или кому удобней воспринимать информацию в текстовом виде, мы прикладываем полную текстовую расшифровку, оформленную в виде хабростатьи.

Читать полностью »

image

1 сентября Mail.Ru Group и сообщество Open Data Science проведут крупнейший митап Moscow Data Science.

Откроем новый учебный и рабочий год целым днём секций и нетворкинга!
Читать полностью »

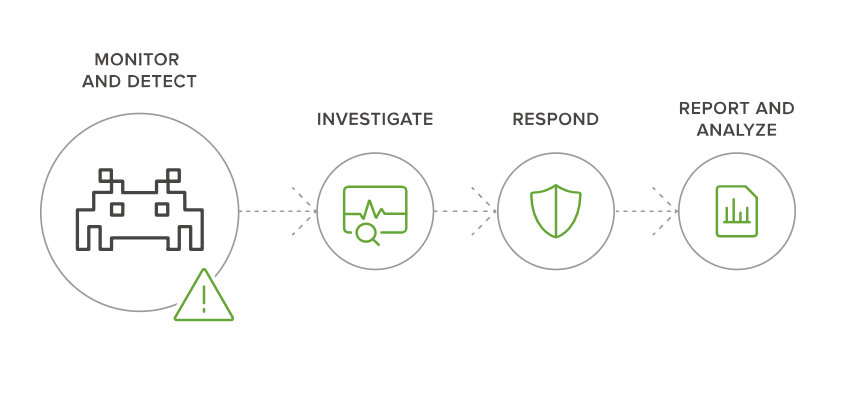
Зачем вам нужен Splunk? Аналитика событий безопасности - 1

Было ли нарушение информационной безопасности предприятия? Какие внутренние угрозы есть у организации? Как и насколько быстро мы можем обнаружить, заблокировать или остановить атаку? В этой статье мы расскажем, как вам может помочь Splunk в поиске ответов на эти вопросы.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js