
Привет! 2-3 марта на Мансарде наших партнёров, компании Rambler&Co, прошел уже традиционный Data Science Weekend, на котором было множество выступлений специалистов в области работы с данными. В рамках этой статьи расскажем вам о самых интересных моментах первого дня нашей конференции, когда все внимание было уделено практике использования алгоритмов машинного обучения, управлению коллективами и проведению соревнований в области Data Science.
Рубрика «big data» - 60
Обзор первого дня Data Science Weekend 2018. Практика машинного обучения, новый подход к соревнованиям и многое другое
2018-03-20 в 10:23, admin, рубрики: big data, data mining, python, анализ данных, Блог компании New Professions Lab, Компьютерное зрение, машинное обучение, нейронные сети
Можно ли научить искусственный интеллект шутить?
2018-03-19 в 7:12, admin, рубрики: big data, cnn, computer vision, deep learning, funcorp, machine learning, Алгоритмы, Блог компании FunCorp, глубокое обучение, машинное обучение, нейронные сети, обработка изображений В последнее время машины одержали ряд убедительных побед над людьми: они уже лучше играют в го, шахматы и даже в Dota 2. Алгоритмы сочиняют музыку и пишут стихи. Учёные и предприниматели всего мира дают прогнозы по поводу будущего, в котором искусственный интеллект сильно превзойдёт человека. С большой вероятностью через несколько десятков лет мы будем жить в мире, в котором роботы не только водят автомобили и работают на заводах, но и развлекают нас. Одна из важных составляющих нашей жизни — юмор. Принято считать, что только человек может придумывать шутки. Несмотря на это, многие ученые, инженеры и даже простые обыватели задаются вопросом: можно ли научить компьютер шутить?
Компания Gentleminds, разработчик систем машинного обучения и компьютерного зрения, совместно с FunCorp попробовали создать генератор весёлых подписей к картинкам, используя базу мемов iFunny. Поскольку приложение англоязычное и используется преимущественно в США, подписи будут на английском. Подробности под катом.
Читать полностью »
Как создать приложение c 3D аналитикой для iPhone за пару часов?
2018-03-19 в 3:00, admin, рубрики: big data, unity3d, анализ данных, аналитика, Большие данные, визуализация данных, геймификация, мобильные приложения, открытые данные, Работа с 3D-графикой
Существует множество трендов и направлений в анализе данных, и все мы знакомы с популярными словами Business Intelligence, Big Data, Machine Learning и т.д. Эти слова знакомы сейчас даже тем, кто не знает как написать SQL-запрос, не знаком с правилами визуализации и отображения информации, и тем более не сможет написать Python-скрипт. Но всегда в нас остаётся незыблемое желание, воплощение мечты любого руководителя и/или даже аналитика данных: «нажимаешь на клавишу» и через миллисекунды нам уже приходит ответ на вопрос «Что делать?», а желательно пусть сразу «Прибыль компании увеличена».
Релиз Apache Ignite 2.4 — Distributed Database and Caching Platform
2018-03-16 в 9:00, admin, рубрики: .net, .net core, Apache Ignite, big data, database, distributed systems, fast data, gridgain, in-memory computing, java, Mono, mpp, sql, Блог компании GridGain, Программирование12 марта 2018 г., спустя 4 месяца после прошлой версии, вышел Apache Ignite 2.4. Этот релиз примечателен целым рядом нововведений: поддержка Java 9, множественные оптимизации и улучшения SQL, поддержка платформой нейронных сетей, новый подход к построению топологии при работе с диском и многое другое.
Apache Ignite Database and Caching Platform — это платформа для распределенного хранения данных (оптимизированная под активное использование RAM), а также для распределенных вычислений в близком к реальному времени.
Ignite применяется там, где нужно очень быстро обрабатывать большие потоки данных, которые не по зубам централизованным системам.
Примеры использования: быстрый распределенный кеш; слой, агрегирующий данные из разрозненных сервисов (например, для Customer 360 View); основное горизонтально масштабируемое хранилище (NoSQL или SQL) оперативных данных; платформа для вычислений и т.д.
Далее рассмотрим основные новшества Ignite 2.4.
Читать полностью »
Собственная игровая аналитика за $300 в месяц
2018-03-14 в 16:01, admin, рубрики: big data, data mining, Анализ и проектирование систем, аналитика, аналитика игр, архитектура приложений, облачные технологии, Программирование, разработка игр
На рынке много продуктов, подходящих для игровой аналитики: Mixpanel, Localytics, Flurry, devtodev, deltaDNA, GameAnalytics. Но все же многие игровые студии строят свое решение.
Я работал и работаю со многими игровыми компаниями. Я заметил, что по мере роста проектов, в студиях появляется необходимость в продвинутых сценариях аналитики. После того, как несколько игровых компаний заинтересовались данным подходом, было решено задокументировать его в серии из двух статей.
Ответы на вопросы "Почему?", "Как это сделать?" и "Сколько это стоит?" вы найдете под катом.
CSS ScaleFlux, или как ускорить базы данных в два-три раза простой заменой NVMe
2018-03-14 в 14:30, admin, рубрики: big data, ScaleFlux, Блог компании GlobalDots, высокая производительность, данные, машинное обучение, производительностьБазы данных, сети дистрибуции контента, big data, искусственный интеллект, машинное обучение — все эти data-driven сценарии требуют высокой производительности всей ИТ-инфраструктуры. Для подсистемы хранения все решается просто — установка скоростных NVMe и SSD вместо SAS и SATA. С вычислительной частью все сложнее — центральные процессоры не успевают за множеством операций, очень чувствительных ко времени. Для устранения этого «бутылочного горлышка» компания ScaleFlux разработала новые типы носителей. Внутри них бок о бок с 3D NAND памятью работают FPGA-компоненты, которые берут на себя множество типовых операций с данными. В этом посте мы подробно расскажем о решении ScaleFlux.

Наташа — библиотека для извлечения структурированной информации из текстов на русском языке
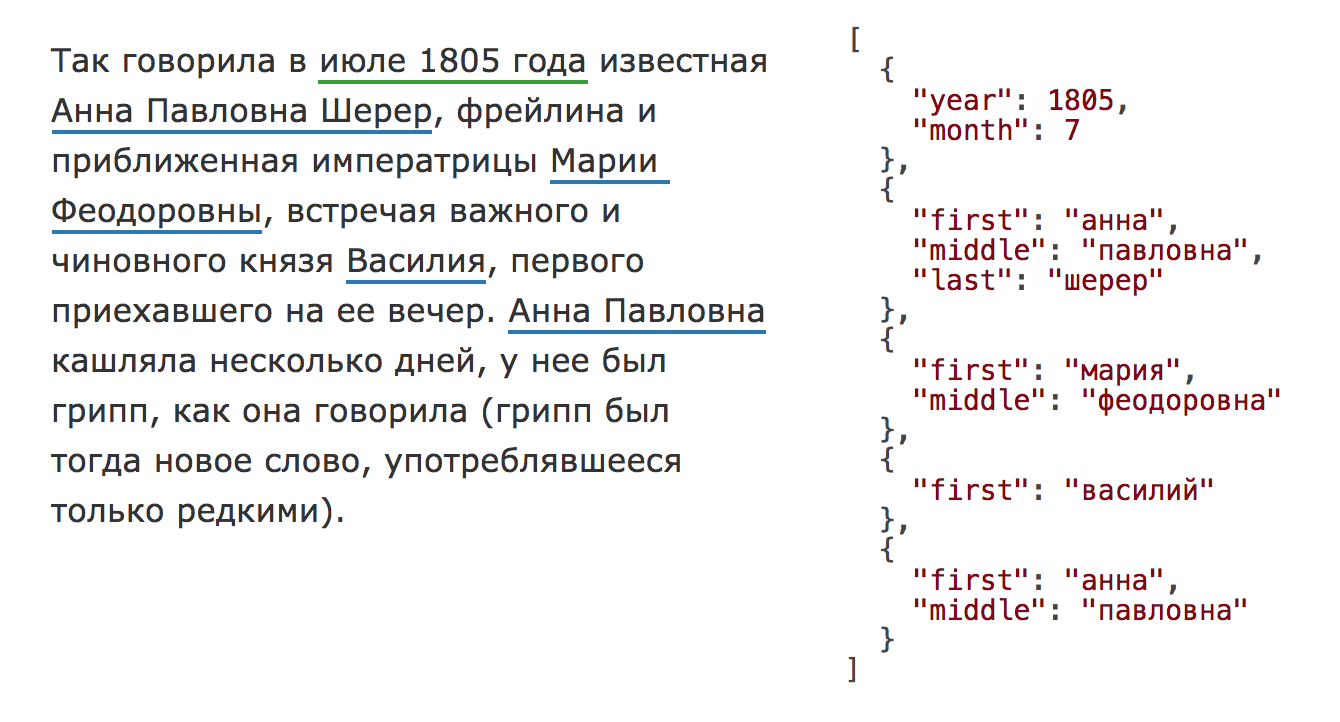
2018-03-14 в 13:12, admin, рубрики: big data, data mining, ner, nlp, python, yargy, машинное обучение, наташаЕсть стандартная задача извлечения именованных сущностей из текста (NER). На входе текст, на выходе структурированные, нормализованные объекты, например, с именами, адресами, датами:
Задача старая и хорошо изученная, для английского языка существует масса коммерческих и открытых решений: Spacy, Stanford NER, OpenNLP, NLTK, MITIE, Google Natural Language API, ParallelDots, Aylien, Rosette, TextRazor. Для русского тоже есть хорошие решения, но они в основном закрытые: DaData, Pullenti, Abbyy Infoextractor, Dictum, Eureka, Promt, RCO, AOT, Ahunter. Из открытого мне известен только Томита-парсер и свежий Deepmipt NER.
Я занимаюсь анализом данных, задача обработки текстов одна из самых частых. На практике оказывается, что, например, извлечь имена из русского текста совсем непросто. Есть готовое решение в Томита-парсере, но там неудобная интеграция с Питоном. Недавно появилось решение от ребят из iPavlov, но там имена не приводятся к нормальной форме. Для извлечения, например, адресов («ул. 8 Марта, д.4», «Ленинский проезд, 15») открытых решений мне не известно, есть pypostal, но он чтобы парсить адреса, а не искать их в тексте. C нестандартными задачами типа извлечения ссылок на нормативные акты («ст. 11 ГК РФ», «п. 1 ст. 6 Закона № 122-ФЗ») вообще непонятно, что делать.
Год назад Дима Веселов начал проект Наташа. С тех пор код был значительно доработан. Наташа была использована в нескольких крупных проектах. Сейчас мы готовы рассказать о ней пользователям Хабра.
Наташа — это аналог Томита-парсера для Питона (Yargy-парсер) плюс набор готовых правил для извлечения имён, адресов, дат, сумм денег и других сущностей.
В статье показано, как использовать готовые правила Наташи и, самое главное, как добавлять свои с помощью Yargy-парсера.
Читать полностью »
Как быстро написать и выкатить в продакшн алгоритм машинного обучения
2018-03-13 в 10:06, admin, рубрики: big data, data mining, data science, kaggle, machine learning, python, машинное обучениеСейчас анализ данных все шире используется в самых разных, зачастую далеких от ИТ, областях и задачи, стоящие перед специалистом на ранних этапах проекта радикально отличаются от тех, с которыми сталкиваются крупные компании с развитыми отделами аналитики. В этой статье я расскажу о том, как быстро сделать полезный прототип и подготовить простой API для его использования прикладным программистом.
Для примера рассмотрим задачу предсказания цены на трубы размещенную на платформе для соревнований Kaggle. Описание и данные можно найти здесь. На самом деле на практике очень часто встречаются задачи в которых надо быстро сделать прототип имея очень небольшое количество данных, а то и вообще не имея реальных данных до момента первого внедрения. В этих случаях приходится подходить к задаче творчески, начинать с несложных эвристик и ценить каждый запрос или размеченный объект. Но в нашей модельной ситуации таких проблем, к счастью, нет и поэтому мы можем сразу начать с обзора данных, определения задачи и попыток применения алгоритмов.
Читать полностью »
Оповещение на почту в режиме реального времени. Реально? Или как сделать Alert на Splunk
2018-03-13 в 5:53, admin, рубрики: alerting, big data, email, splunk, Блог компании TS Solution, информационная безопасность, машинные данные, Серверное администрирование, системное администрированиеСколько времени проходит с момента возникновения какого-то важного события до реакционных действий? Зачастую очень много! Одним их факторов влияющих на время реакции служит несвоевременное информирование персонала, отвечающего за принятие решений.
Сегодня мы расскажем вам о том, как получать уведомления о возникновении важных инцидентов безопасности, критическом состоянии IT систем, существенных отклонениях от нормы различных показателей или о других интересных для вас событиях в режиме реального времени и в удобном формате, в частности по электронной почте.
Реализовывать алерты, или иначе говоря оповещения, будем в Splunk, продукте, специализирующемся на анализе машинных данных, о котором мы писали ранее.
Читать полностью »
Предвыборная гонка глазами поисковых роботов
2018-03-12 в 23:22, admin, рубрики: big data, data mining, statoperator, выборы, Исследования и прогнозы в IT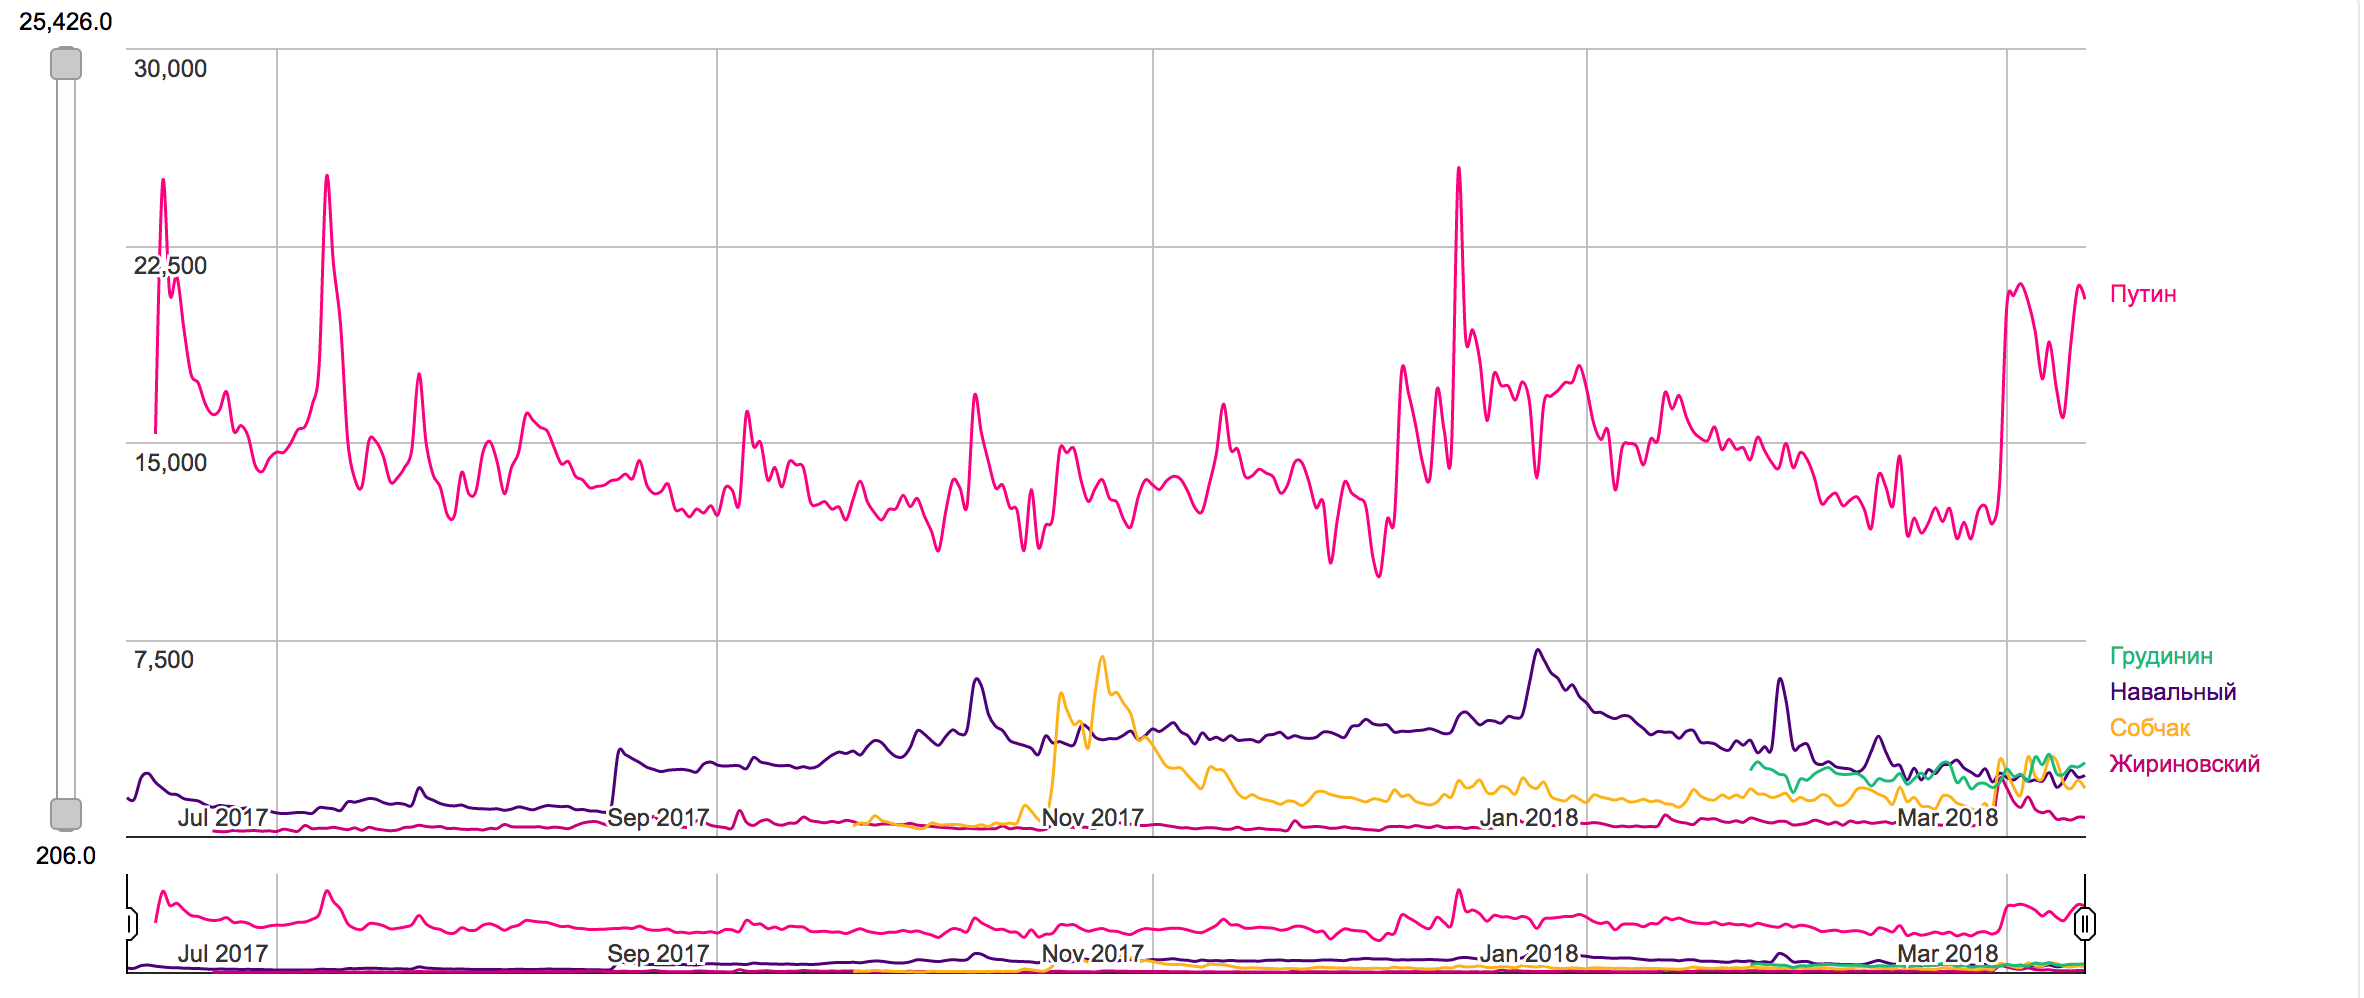
Мы ежедневно выполняем срез документов, расположенных на главных страницах миллиона самых посещаемых сайтов мира. Сегодня рассмотрим, как количество упоминаний кандидатов в президенты РФ коррелирует с происходящими оффлайн событиями.
Читать полностью »