Рубрика «big data» - 59

Сбербанк вместе с системным интегратором «Ай-теко» создает облачную платформу SberCloud, которая будет предоставлять услуги как самому банку, так и внешним заказчикам, рассказали «Ведомостям» представитель Сбербанка и президент «Ай-теко» Шамиль Шакиров.

Известно, Читать полностью »

Машинное обучение и анализ данных: разбор программы обучения и основные проблемы - 1
Машинное обучение и анализ данных — обзор Специализации от Яндекcа & МФТИ (5 курсов + финальный проект), предложенной на образовательной платформе Coursera. Статья представляет собой исключительно мнение автора как выпускника, не является рекламой и/или умышленной критикой, а скорей служит вводным инструктажем для тех, кто начинает обучение по данной тематике.

Вам может быть полезна данная статья если:

  • Вы хотите “попробовать на вкус” программирование на Python и понять для себя основные принципы работы моделей машинного обучения, использующихся для работы с данными
  • Вы рассматриваете для себя возможность пройти какой-либо обучающий курс по данной тематике и вам интересно оценить, насколько Специализация от Яндекса & МФТИ подходит для этого

Читать полностью »

Сегодня замечательный день (if you know what I mean), чтобы анонсировать нашу новую программу — Специалист по разметке данных.

На текущий момент в сфере искусственного интеллекта сложилась такая ситуация, при которой для обучения сильной нейронной сети нужны несколько компонентов: железо, софт и, непосредственно, данные. Много данных.

Железо, в общем-то, доступно каждому через облака. Да, оно может быть недешевым, но GPU-инстансы на EC2 вполне по карману большинству исследователей. Софт опенсорсный, большинство фреймворков можно скачать себе куда-то и работать с ними. Некоторые сложнее, некоторые проще. Но порог для входа вполне приемлемый. Остается только последний компонент — это данные. И вот здесь и возникает загвоздка.

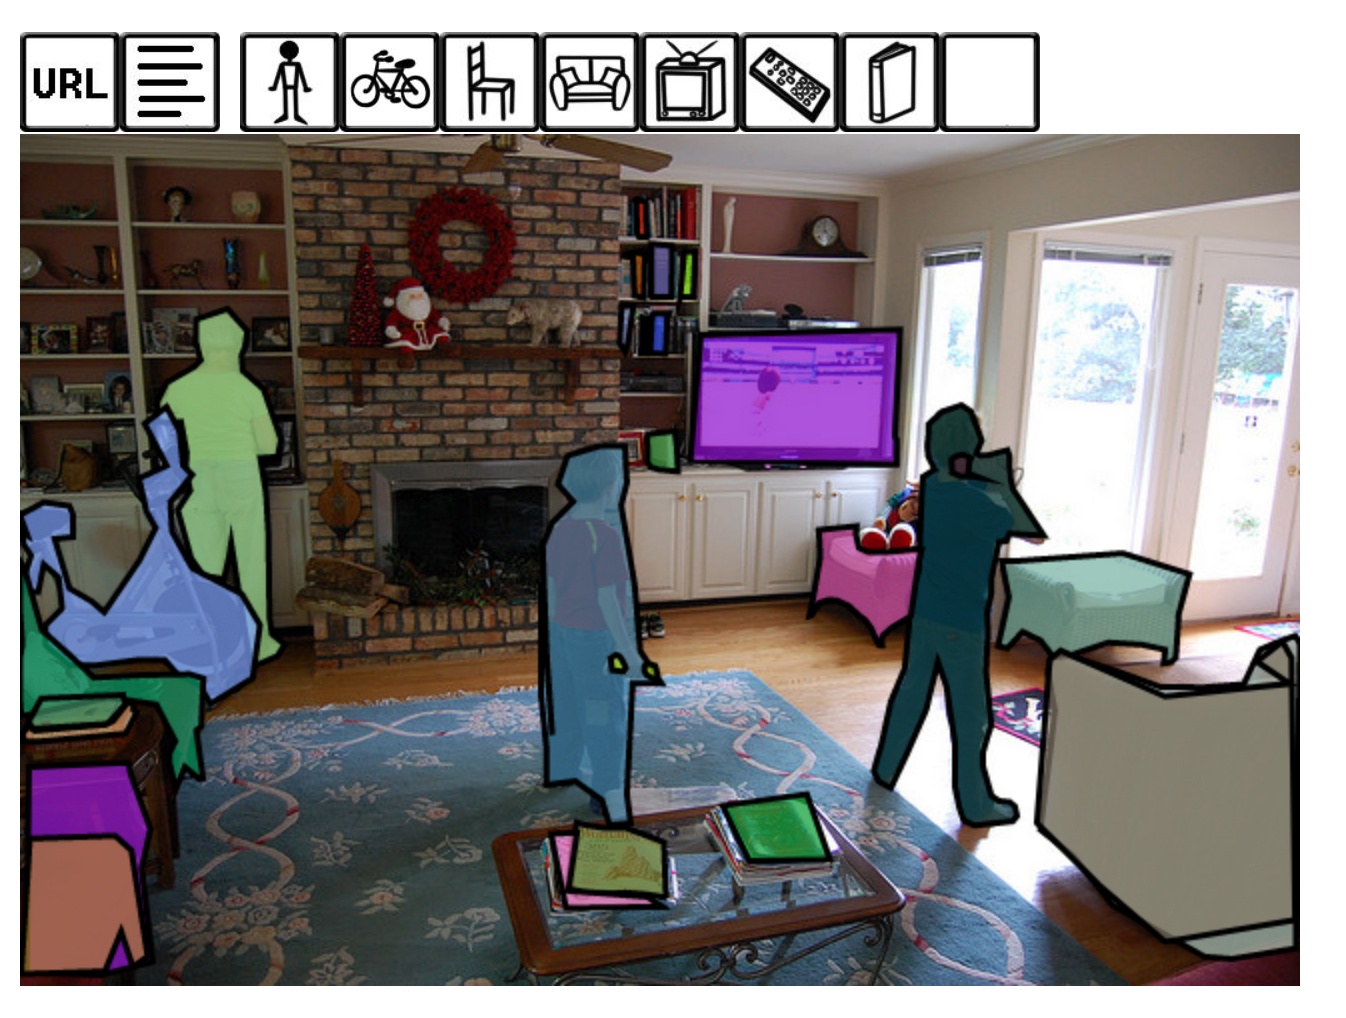
Deep learning требует действительно больших данных: сотни тысяч–миллионы объектов. Если вы хотите заниматься, например, задачей классификации изображений, то вам, помимо самих данных, нужно передать нейронке информацию, к какому классу относится тот или иной объект. Если у вас задача связана еще и с сегментацией изображения, то получение хорошего датасета — это уже фантастически сложно. Представьте, что вам нужно на каждом изображении выделить границы каждого объекта.

Специалист по разметке данных - 1

В этом посте хочется сделать обзор тех инструментов (коммерческих и бесплатных), которые пытаются облегчить жизнь этих прекрасных людей — разметчиков данных.
Читать полностью »

logo

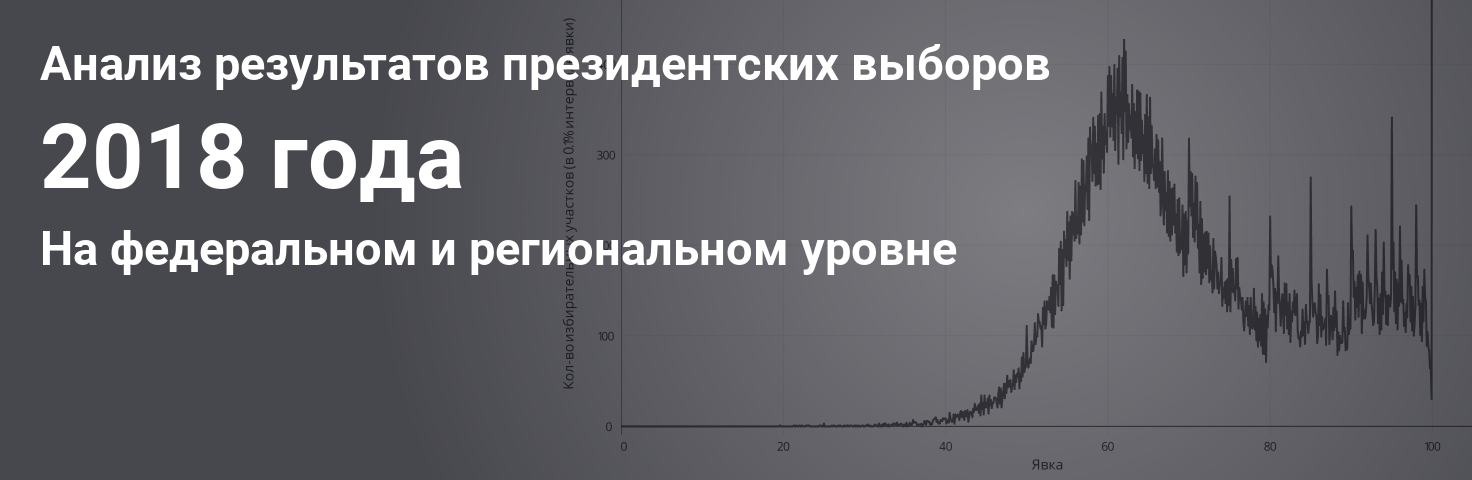
Особенностью российских президентских выборов 2018 года стало то, что главным показателем теперь стал не процент за основного кандидата, а величина явки. Другим важным показателем стало рекордно высокое количество наблюдателей по всей стране. Наблюдатели были отправлены, в том числе, в республики Северного Кавказа, где традиционно результаты попросту рисовались.

Президентские выборы, даже без учёта масштабной кампании по повышению явки с помощью конкурсов, местных референдумов, и административного давления, привлекают значительно выше внимания, чем парламентские выборы. Однако, проведя анализ результатов, можно продолжать замечать аномалии в результатах, хоть уже и менее выраженными на федеральном уровне.

Я провел анализ результатов как на федеральном, так и (что интереснее) региональных уровнях, а также расскажу о том, как создавал сервис для анализа выборов.Читать полностью »

Пойди туда, не знаю куда: по следам конференции SmartData - 1

Конференций, связанных с AI / ML / data science в последнее время и у нас стало довольно много. Организаторы до сих пор ищут форматы, концепции конференций меняются, но состав спикеров повторяется процентов на 50.

Задача поиска формата стояла и перед программным комитетом SmartData. Задача эта довольно размытая. Кто тот человек, который занимается анализом и / или обработкой данных, что ему интересно? От участников конференции мы получили частичные ответы на эти вопросы, но данных хочется больше. В связи с этим хочу поделиться тем представлением об идеальном мире, которое сложилось на данный момент, и пригласить читателей к дискуссии в комментариях. Помогите сделать такую конференцию, на которую вам потом самим захочется сходить.

Кроме вопросов о ваших интересах и задачах, за кликом вас ждут две ранее не публиковавшиеся видеозаписи выступлений с первой конференции, технический приём написания текстов на Хабр и один забавный факт о беспилотных автомобилях.
Читать полностью »

Apache Ignite: распределенные вычисления в оперативной памяти - 1

Привет!

Мы продолжаем интересоваться новыми решениями от компании Apache. Рассчитываем выпустить в мае книгу «High Performance Spark» Холдена Карау (книга в верстке), а в августе — книгу «Kafka: The Definitive Guide» Нии Нархид (еще в переводе). Сегодня же хотим предложить краткую ознакомительную статью об Apache Ignite и оценить масштаб интереса к теме.

Приятного чтения!
Читать полностью »

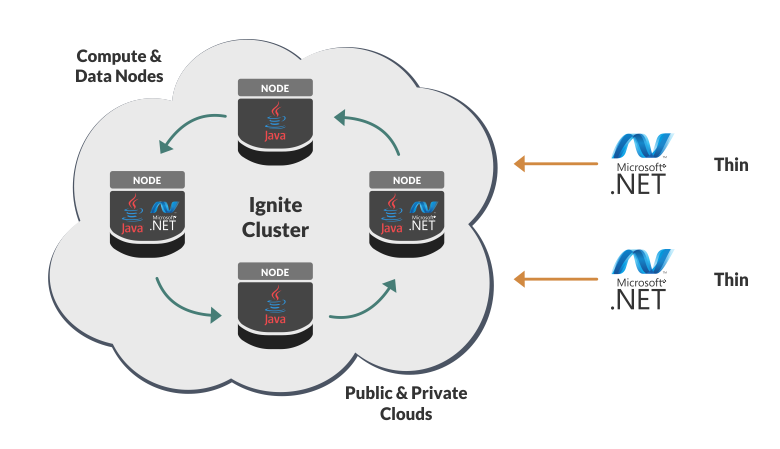
Недавно вышла новая версия распределённой SQL базы данных Apache Ignite, предлагаю взглянуть на новые фичи с позиции .NET.

Ignite Cluster

Читать полностью »

Несколько дней назад мы публиковали обзор первого дня Data Science Weekend 2018, который прошел 2-3 марта на Мансарде Rambler&Co. Изучив практику использования алгоритмов машинного обучения, теперь перейдем к обзору второго дня конференции, в течении которого спикеры рассказывали об использовании различных инструментов дата инженера для нужд дата-платформ, ETL, сервисах подсказок при поиске и многом другом.

Обзор второго дня Data Science Weekend 2018. Data Engineering, ETL, поисковые сервисы и многое другое - 1
Читать полностью »

ClickHouse, Druid и Pinot — три открытых хранилища данных, которые позволяют выполнять аналитические запросы на больших объемах данных с интерактивными задержками. Эта статья — перевод подробного сравнения, выполненного Романом Левентовым.

Спойлер

ClickHouse Druid или Pinot
В организации есть эксперты по C++ В организации есть эксперты по Java
Малый кластер Большой кластер
Немного таблиц Много таблиц
Один набор данных Несколько несвязанных наборов данных
Таблицы и данные находятся в кластере перманентно Таблицы и наборы данных периодически появляются в кластере и удаляются из него
Размер таблиц (и интенсивность запросов к ним) остается стабильным во времени Таблицы значительно растут и сжимаются
Однородные запросы (их тип, размер, распределение по времени суток и т.д.) Разнородные запросы
В данных есть измерение, по которому оно может быть сегментировано, и почти не выполняется запросов, которые затрагивают данные, расположенные в нескольких сегментах Подобного измерения нет, и запросы часто затрагивают данные, расположенные во всем кластере
Облако не используется, кластер должен быть развернут на специфическую конфигурацию физических серверов Кластер развернут в облаке
Нет существующих кластеров Hadoop или Spark Кластеры Hadoop или Spark уже существуют и могут быть использованы

А под катом — подробный рассказ о том, как Роман к этому пришёл.Читать полностью »

Всем привет!

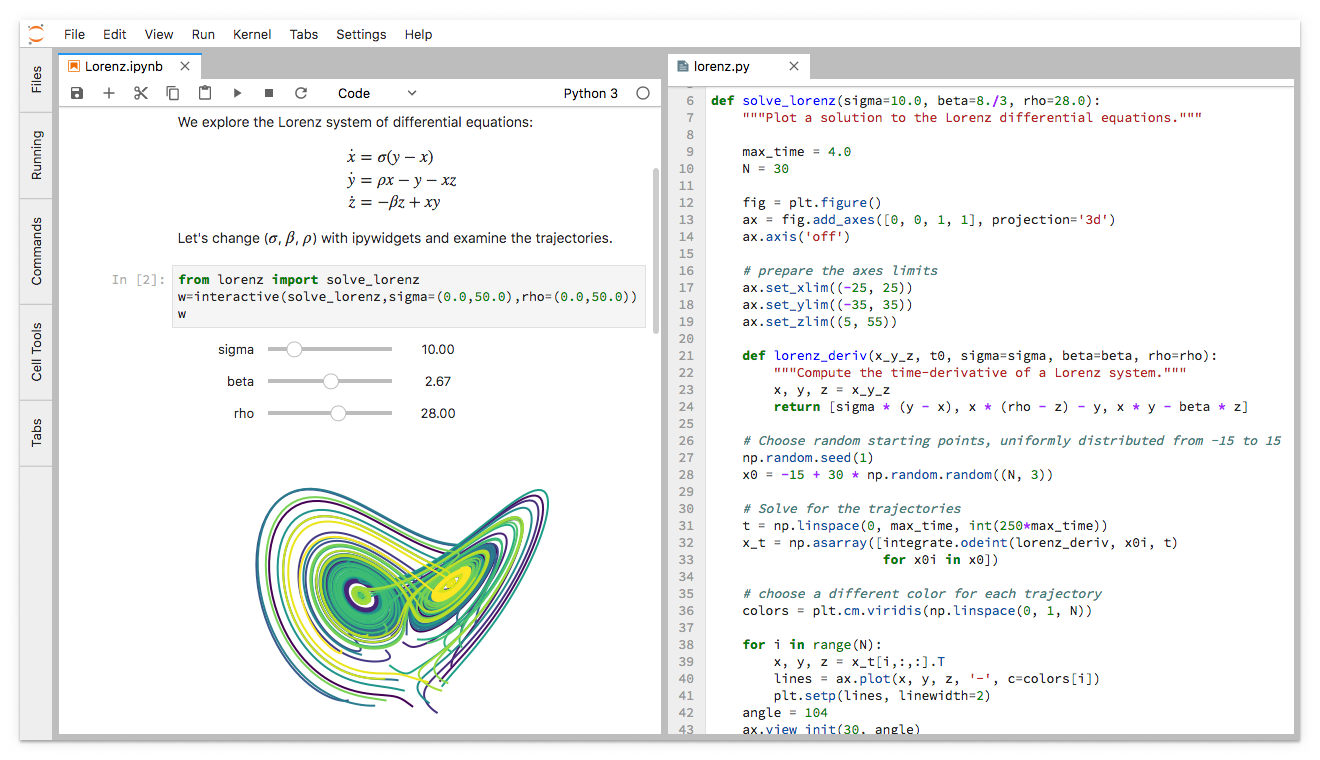
Одним из основных инструментов на нашем курсе «Разработчик BigData» является Jupyter. Глянем, что его разработчики приготовили в новой итерации и что уже доступно в бета-версии.

Поехали.

Вкратце: JupyterLab готов к ежедневному использованию (установка, документация, экскурс через Binder)

JupyterLab — это интерактивная среда разработки для работы с блокнотами, кодом и данными.

Что есть в новом JupyterLab для пользователей? - 1
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js