Рубрика «big data» - 58

image

Друзья, приглашаем вас на пятый московский Data Fest, который состоится 28 апреля на территории дизайн-завода FLACON. Data Fest — крупнейшая бесплатная конференция для исследователей, инженеров и разработчиков, связанных с анализом и обработкой данных, машинным обучением, а также тем, что пресса любит называть AI.

Вы узнаете про AI в продуктах Mail.Ru Group и «умные» ответы в Почте Mail.Ru, как работают рекомендации и компьютерное зрение во ВКонтакте и Одноклассниках, а также машинный перевод в Alibaba и что такое Quantum Machine Learning, а также многое-многое другое!
Читать полностью »

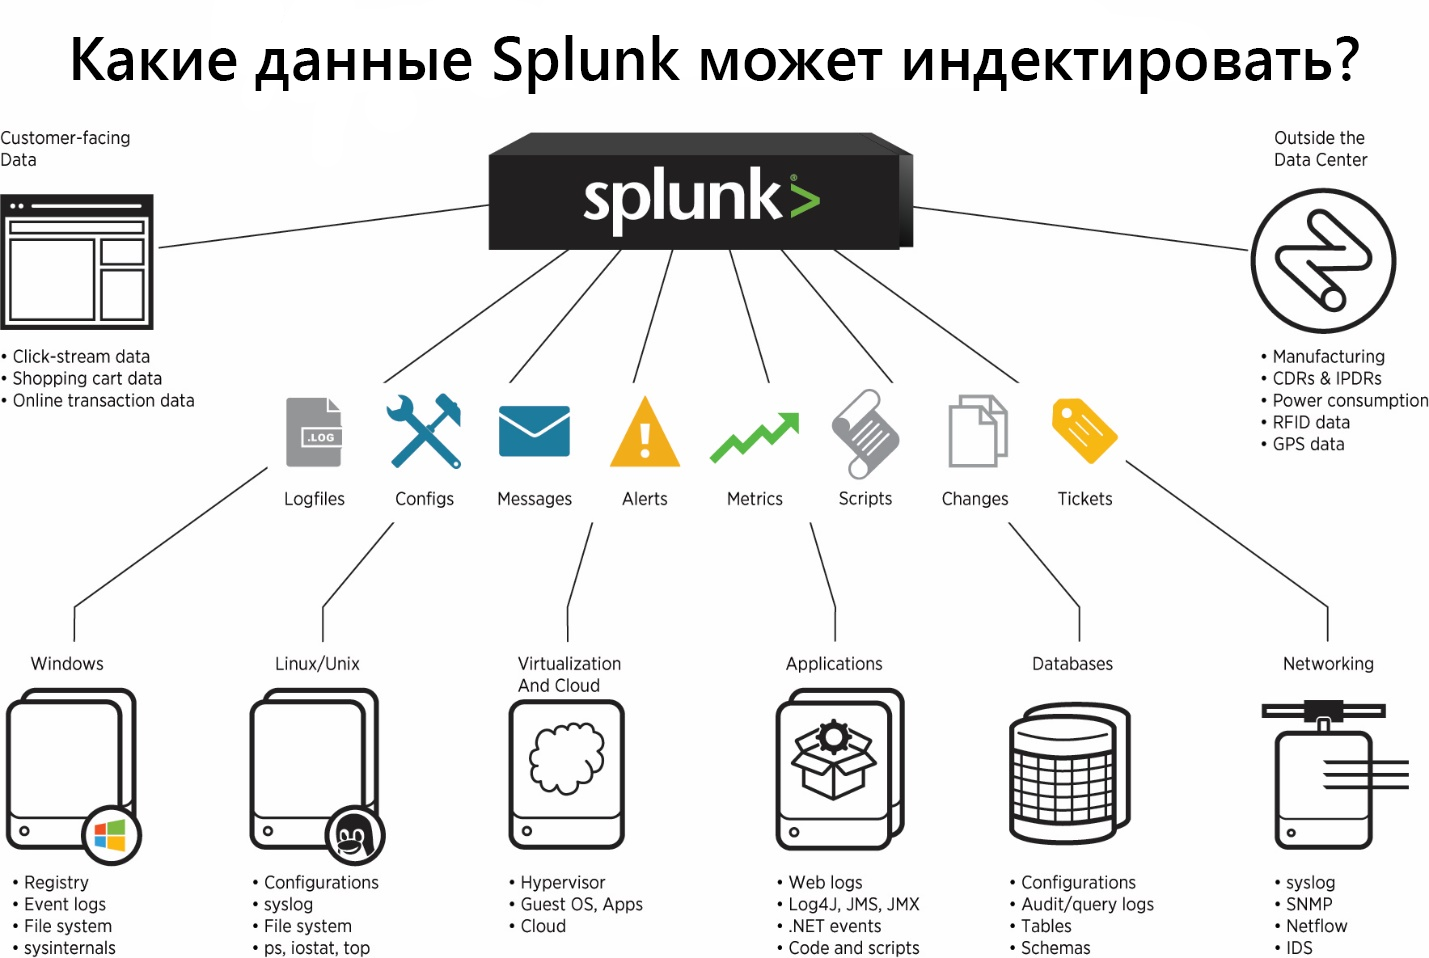
Много ли мы генерируем данных, используя информационные системы каждый день? Огромное количество! Но знаем ли мы все возможности по работе с такими данными? Определенно, нет! В рамках этой статьи мы расскажем какие типы данных мы можем загружать для дальнейшего операционного анализа в Splunk, а также покажем как подключить загрузку логов Fortinet и логов нестандартной структуры, которые необходимо разделять на поля вручную.

Как загрузить нестандартный лог в Splunk + логи Fortinet - 1
Читать полностью »

Меня зовут Иван Серов, я работаю в департаменте Data Science финтех-компании ID Finance. Data scientist –довольно молодая, но очень востребованная профессия, которая обросла множеством мифов. В этом посте я расскажу о нескольких заблуждениях, с которыми сталкиваются начинающие дата-саентисты (DS).

Пять мифов о Data Science - 1
Читать полностью »

* Michael G. Noll — активный контрибьютор в Open Source проекты, в том числе в Apache Kafka и Apache Storm.

Статья будет полезна в первую очередь тем, кто только знакомится с Apache Kafka и/или потоковой обработкой [Stream Processing].

В этой статье, возможно, в первой из мини-серии, я хочу объяснить концепции Стримов [Streams] и Таблиц [Tables] в потоковой обработке и, в частности, в Apache Kafka. Надеюсь, у вас появится лучшее теоретическое представление и идеи, которые помогут вам решать ваши текущие и будущие задачи лучше и/или быстрее.

Содержание:

* Мотивация
* Стримы и Таблицы простым языком
* Иллюстрированные примеры
* Стримы и Таблицы в Kafka простым языком
* Пристальный взгляд на Kafka Streams, KSQL и аналоги в Scala
* Таблицы стоят на плечах гигантов (на стримах)
* Turning the Database Inside-Out
* Заключение
Читать полностью »

Предисловие

Недавно прочитал очередную статью из серии: "мы лучше двухфазного коммита". Здесь я не буду анализировать содержания этой статьи (хотя, подумываю о том, чтобы дать развернутый анализ). Задача моего опуса — предложить самый эффективный вариант распределенного коммита с точки зрения временных задержек. Конечно, такой коммит дается высокой ценой. Однако цель — дать оценку и показать, что двухфазный коммит не является тормозным, как многие считают.

Стоит также отметить, что здесь не будет натурных экспериментов и фейковых сравнений. Будут просто даны алгоритмы и теоретический анализ. При желании, можно самостоятельно реализовать и проверить на практике. Конечно, было бы куда лучше, чтобы это было описано в текущей статье, но все упирается в свободное время и мотивацию. На мой взгляд, описать алгоритмы более важно, чем привести графики, т.к. графики по алгоритмам может нарисовать почти каждый, обратное же не верно.

Читать полностью »

В этой статье я бы хотел обсудить базовые принципы построения практического проекта по (т. н. «интеллектуальному») анализу данных, а также зафиксировать необходимую терминологию, в том числе русскоязычную.

Согласно википедии,

Анализ данных — это область математики и информатики, занимающаяся построением и исследованием наиболее общих математических методов и вычислительных алгоритмов извлечения знаний из экспериментальных (в широком смысле) данных; процесс исследования, фильтрации, преобразования и моделирования данных с целью извлечения полезной информации и принятия решений.

Говоря чуть более простым языком, я бы предложил понимать под анализом данных совокупность методов и приложений, связанных с алгоритмами обработки данных и не имеющих четко зафиксированного ответа на каждый входящий объект. Это будет отличать их от классических алгоритмов, например реализующих сортировку или словарь. Читать полностью »

Кейсы практического применения Больших данных
в компаниях финансового сектора

Обзор кейсов интересных внедрений Big Data в компаниях финансового сектора - 1Зачем эта статья?

В данном обзоре рассматриваются случаи внедрения и применения Больших данных в реальной жизни на примере «живых» проектов. По некоторым, особенно интересным, во всех смыслах, кейсам осмелюсь дать свои комментарии.

Диапазон рассмотренных кейсов ограничивается примерами, представленными в открытом доступе на сайте компании Cloudera.

Что такое «Большие данные»

Обзор кейсов интересных внедрений Big Data в компаниях финансового сектора - 2Есть в технических кругах шутках, что «Большие данные» это данные, для обработки которых недостаточно Excel 2010 на мощном ноутбуке. То есть если для решения задачи вам надо оперировать 1 миллионом строк на листе и более или 16 тысяч столбцов и более, то поздравляем, ваша данные относятся к разряду «Больших».

Среди множества более строгих определений приведем, например следующее: «Большие данные» — наборы данных, которые настолько объемны и сложны, что использование традиционных средств обработки невозможно. Термин обычно характеризует данные, над которыми применяются методы предиктивной аналитики или иные методы извлечения ценности из данных и редко соотносится только с объемом данных.
Читать полностью »

Привет!

Сегодня мы предлагаем вам сравнительно краткую, но при этом толковую и информативную статью об устройстве и вариантах применения Apache Kafka. Рассчитываем перевести и выпустить книгу Нии Нархид (Neha Narkhede) et. al до конца лета.

Apache Kafka: обзор - 1

Приятного чтения!
Читать полностью »

Неважно, кто вы — зарекомендовавшая себя компания, или же только собираетесь запустить свой первый сервис — вы всегда можете использовать текстовые данные для того, чтобы проверить ваш продукт, усовершенствовать его и расширить его функциональность.

Обработкой естественного языка (NLP) называется активно развивающаяся научная дисциплина, занимающаяся поиском смысла и обучением на основании текстовых данных.

Как вам может помочь эта статья

За прошедший год команда Insight приняла участие в работе над несколькими сотнями проектов, объединив знания и опыт ведущих компаний в США. Результаты этой работы они обобщили в статье, перевод которой сейчас перед вами, и вывели подходы к решению наиболее распространенных прикладных задач машинного обучения.

Мы начнем с самого простого метода, который может сработать — и постепенно перейдем к более тонким подходам, таким как feature engineering, векторам слов и глубокому обучению.

После прочтения статьи, вы будете знать, как:

  • осуществлять сбор, подготовку, и инспектирование данных;
  • строить простые модели, и осуществлять при необходимости переход к глубокому обучению;
  • интерпретировать и понимать ваши модели, чтобы убедиться, что вы интерпретируете информацию, а не шум.

Пост написан в формате пошагового руководства; также его можно рассматривать в качестве обзора высокоэффективных стандартных подходов.
Читать полностью »

image

Всем привет! Новый год, новый Spark, новый Moscow Spark! Мы стартуем новый сезон нашего замечательного мероприятия 19 апреля на Мансарде Rambler&Co. Фреймворк не стоит на месте и мы тоже, в этот раз представим новый сайт сообщества и опробуем формат со звездой из-за рубежа.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js