Рубрика «big data» - 57

1. Постановка задачи

Наборы числовых упорядоченных данных можно разделить на две группы: гауссовы и странные (негауссовы). Если к гауссовым данным можно применять количественное сравнение, то к странным данным такой подход неприменим ввиду их относительности и отсутствия стандарта, что оставляет возможным лишь качественный анализ, который во многих случаях является неоднозначным и трудоемким. При этом такие данные широко распространены, а задача их анализа является актуальной для многих областей науки.

Далее будет представлен вычислительный метод, преобразующий исходные негауссовы данные в гауссовы, что позволяет в дальнейшем сравнивать количественно структурные характеристики больших наборов данных.
Читать полностью »

Валентина Евтюхина, автор канала Digital Eva, и специалисты проектной компании и R&D лаборатории Neurodata Lab специально для блога Нетологии подготовили статью о том, как развиваются технологии в сфере распознавания эмоций.

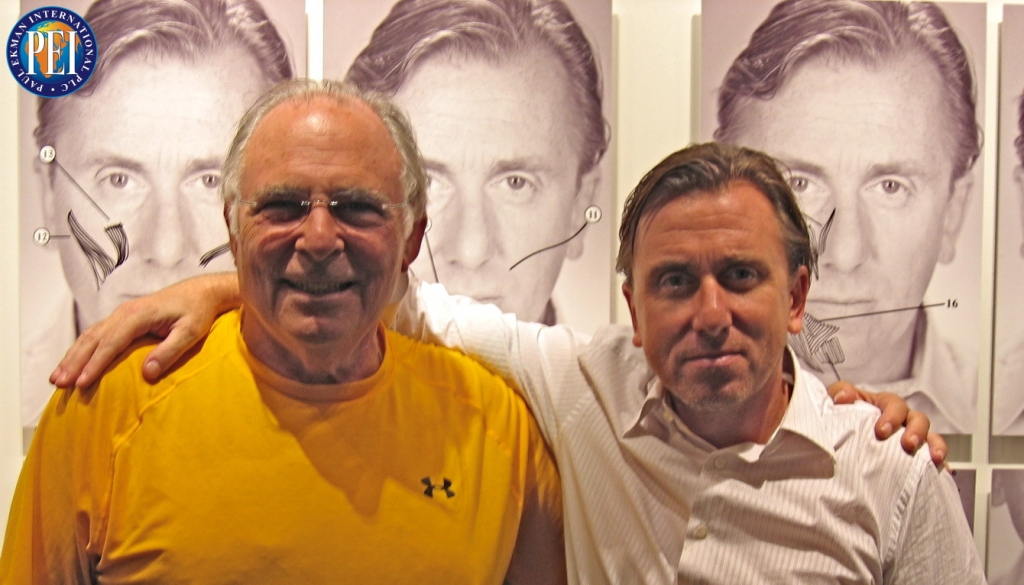
Наука об эмоциях стала популярной не так давно, и в основном благодаря Полу Экману — американскому психологу, автору книги «Психология лжи» и консультанту популярного сериала «Обмани меня», который основан на материалах книги.

Наука эмоций: как умные технологии учатся понимать людей - 1
Пол Экман и Тим Рот — исполнитель главной роли в сериале «Обмани меня», чей персонаж списан с самого Экмана

Сериал стартовал в 2009 году, и в то же время значительно вырос публичный интерес к теме распознавания эмоций. Бум в стартап-среде случился в 2015-2016 годах, когда сразу два технологических гиганта — корпорации Microsoft и Google — доступными для обычных пользователей свои пилотные проекты для работы с наукой эмоций. Читать полностью »

Глава совета директоров Джулиан Уитленд объявил сотрудникам о закрытии бизнеса Cambridge Analytica и её собственника SCL Group, основатель SCL Найджел Оукс подтвердил WSJ уход знаменитого игрока с рынков Big Data и политической рекламы. Технологии CA, как считается, помогли с блеском провести избирательную компанию президенту США Трампу и референдум о выходе Британии из Евросоюза. Технологиями Cambridge Analytica,Читать полностью »

image

Друзья, до самого долгожданного события года в сфере data science остался 1 день! 28 апреля состоится пятый московский Data Fest. Под катом наш рассказ о докладах и активностях Mail.Ru Group на конференции.
Читать полностью »

Привет! Меня зовут Михаил Голованов, в Сбертехе я занимаюсь технической архитектурой и перспективными разработками. У нас, как и у любого современного банка, есть множество систем, которые поддерживают разные стороны работы банка: вклады, счета, зачисление денег, кредитование, финансовые рынки, акции и т.д. Всякий раз, когда появляется какая-то новая система, мы начинаем следующий уровень увлекательной игры под названием «Интеграция». И каждый следующий уровень сложнее предыдущего — ведь систем нужно охватывать все больше и больше. Этот пост — то, что в геймерских кругах именуется walkthrough: сначала мы пробежимся по локальным сетям и затем через очереди сообщений перейдем к масштабному этапу потоковых вычислений посредством Apache Kafka в широко распределенных сетях.  

Дао интеграции Сбербанка: от локальных сетей к Kafka и потоковой разработке - 1
Читать полностью »

Многие время от времени задумываются — насколько точны прогнозы погоды? Чей прогноз погоды точнее? В какую сторону чаще всего ошибаются прогнозы для моего города?

Время математических приключений!

Чей прогноз погоды точнее? - 1

Читать полностью »

В онлайн-кинотеатре ivi десятки тысяч единиц контента и задача «выбрать, что посмотреть» становится нетривиальной.

Персональные рекомендации в ivi: Hydra - 1

О рекомендательной системе в ivi, которая занимается подбором контента на основе пользовательских интересов (внутреннее название — Hydra) мы писали тут и тут. Прошло уже много времени и код проекта значительно изменился: оффлайн часть переехала на Spark, онлайн часть адаптировалась к высоким нагрузкам, Hydra начала использовать другую рекомендательную модель — все эти изменения будут освещены в статье.
Читать полностью »

Привет! Сегодня делимся интервью с директором по цифровым технологиям компании РТС-Тендер, которая занимается организацией электронных торгов с использованием блокчейна, машинного обучения и анализа больших данных. Расспросим про все аспекты бизнеса, а главное — о технической части. Присоединяйтесь. Ну а под катом — текстовая версия.

Читать полностью »

Решаем загадку круглых чисел на графике выборов 2018 - 1

Данная статья является ответом на вот эту статью (Анализ результатов президентских выборов 2018 года. На федеральном и региональном уровне).

В той статье меня удивила фраза автора:

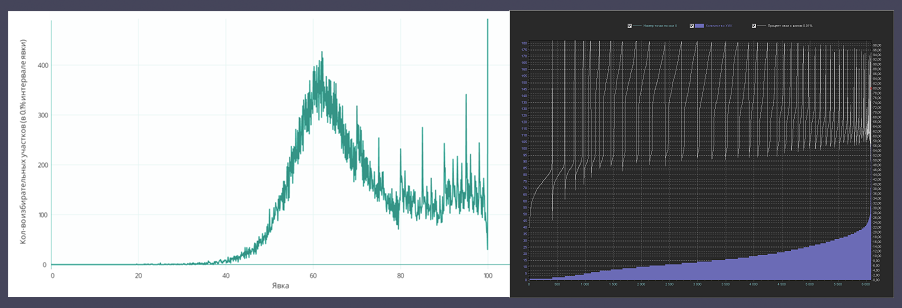
Вместо нормального или логнормального распределения мы видим интересную кривую, с очень странными пиками на круглых значениях (70%, 75%, 80% и т.д.), возрастающую на около-100% явке и уходящей далеко вверх на 100%.

Сразу возникают вопросы:
Почему автор считает, что вместо «странных» пиков должно быть нормальное или логнормальное распределение?
Почему вообще пики считаются «странными»?
Откуда могут появиться «естественные» пики на круглых значениях?

Та статья сильно политизирована и комментарии в ней соответствующие. В этой статье мы будем обсуждать только математику, поэтому политические взгляды попрошу держать при себе.

А в качестве бонуса, в конце статьи будет выложен ключ к решению загадки «круглых чисел» на графике выборов 2018.

Читать полностью »

Ранее мы писали, как можно загрузить логи в Splunk из каталога или с помощью syslog, рассказывали как забирать стандартные виндовые и линуксовые события, но что если нам необходимо получать более гранулярную информацию о работе наших систем?
В таком случае на помощь приходят скрипты!

Splunk Scripted Input. Или как использовать скрипты для получения данных о работе систем и анализировать их в Splunk - 1

Когда, какие и как можно использовать скрипты в Splunk для получения данных — вы можете узнать под катом.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js