
Мне 38 лет, я сварщик из Санкт‑Петербурга. Профильного IT‑образования у меня нет. В июне 2026 года я купил ноутбук, поставил Linux и начал разбираться, как всё устроено изнутри. В октябре с этого же ноутбука я открыл страницу на смартфоне по обычному Wi‑Fi. Страницу отдавала операционная система, которую я собрал сам.
Рубрика «spark»
Микроядро seL4, Ada-SPARK и 185 модулей: разбор проекта
2026-10-16 в 12:09, admin, рубрики: sel4, spark, TCB, x86_64, микроядро, отладка, формальная верификацияVolga: движок обработки real-time данных для AI-ML — аналог Spark и Flink на Rust (Arrow + DataFusion)
2026-04-09 в 9:26, admin, рубрики: AI, Flink, kubernetes, ml, mlops, python, Rust, spark, sql, streaming
Iceberg 1.8 + AWS Glue + Spark 3.5: как мы почти утонули в delete-файлах и что нас спасло
2026-02-03 в 9:15, admin, рубрики: Compaction, Iceeberg, spark
Всем привет!
Хочу поделиться нашим опытом использования Apache Iceberg 1.8+ с каталогом AWS Glue и Spark 3.5.
Расскажу:
-
С какими проблемами мы столкнулись;
-
Почему compaction внезапно перестал помогать;
-
Как мы чинили compaction.
Open Table Formats — Iceberg vs Paimon — практика использования
2026-01-23 в 12:49, admin, рубрики: Flink, iceberg, Open Table Format, Paimon, spark, тесты производительностиПривет. Меня зовут Василий Мельник, я product owner решения для потоковой обработки данных Data Ocean SDIЧитать полностью »
Секреты Spark в Arenadata Hadoop: как мы ускорили построение витрин для задач ML
2025-04-24 в 12:42, admin, рубрики: AI, arenadata, DataLake, Hadoop, livy, spark, витрина данных, ПлатформаПривет! Я Дмитрий Жихарев, CPO Платформы искусственного интеллекта RAISA в Лаборатории ИИ РСХБ-Интех. В этой статье я и архитектор нашей платформы Александр Рындин @aryndin9999расскажем о том, как мы построили взаимодействие Платформы ИИ и Озера данных для работы с витринами данных моделей машинного обучения с использованием Spark.
Sandbox DB: универсальная песочница для погружения в Big Data, аналитику и визуализацию
2025-03-31 в 10:52, admin, рубрики: clickhouse, postgres, python, spark, superset, анализ данных, базы данных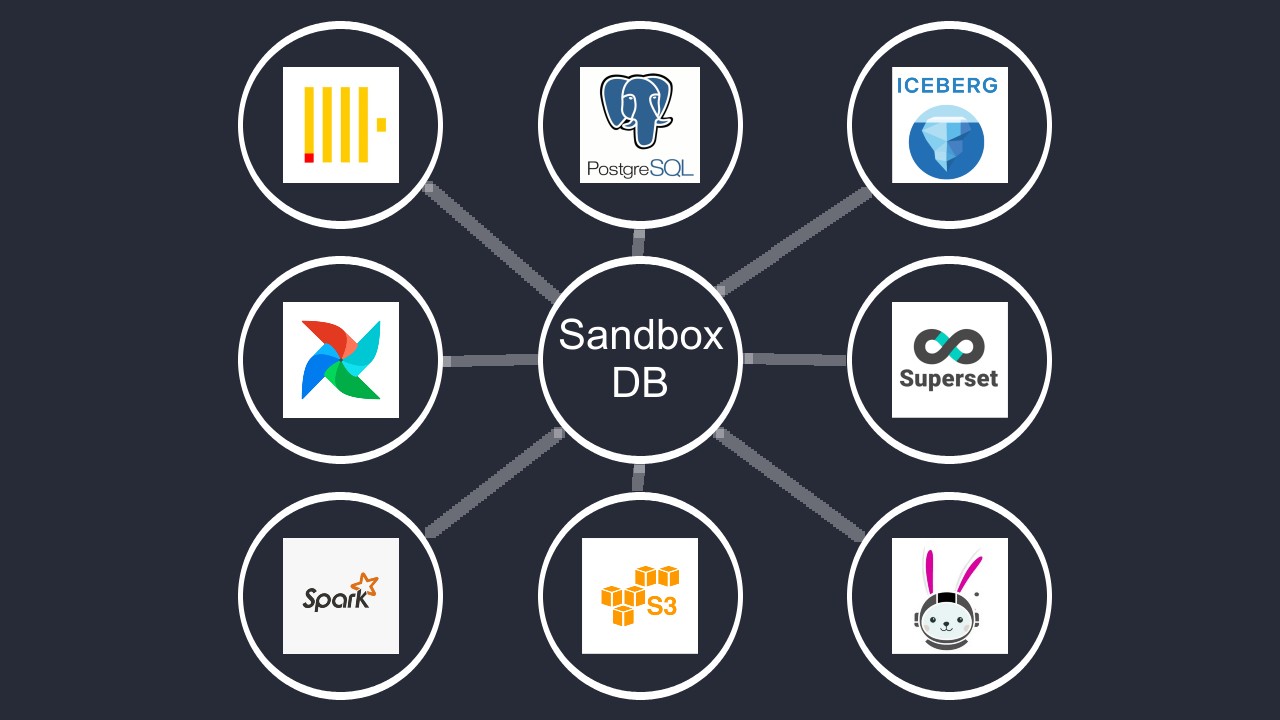
Приветствую всех читателей! Сегодня я хочу рассказать вам о своем мини‑проекте под названием «Песочница Sandbox DB».
Если вам лень читать статью, вот ссылка на проект: Sandbox DB на GitFlic.
Я работаю DWH‑разработчиком уже 6 лет, и все эти годы мне приходится постоянно учиться и осваивать новые инструменты.
Практика создания кастомных сборок Spark Kubernetes Executor
2025-03-24 в 10:16, admin, рубрики: cassandra, docker, dockerfile, executor, kubernetes, pyspark, sparkПоделюсь с коллегами практикой создания Docker-сборок на базе Spark разных версий, которые могут запускаться как Spark Kubernetes Executors для параллельного выполнения Spark-задач в кластере.
В нашем конкретном случае сборки включают Pyspark и Cassandra Connector, однако вы можете использовать этот материал как набор практических примеров, чтобы сконструировать собственные Docker-сборки для Spark на другом стеке или с другими приложениями.
Бутстрап в PySpark
2024-10-09 в 9:49, admin, рубрики: big data, Bootstrap, data engineering, pyspark, python, spark, АБ-тесты, бутстрап, Статистика в ITВсем привет! Меня зовут Илья Черников, я аналитик больших данных в X5 Tech, сейчас занимаюсь аналитикой и оценкой активностей CVM маркетинга экспресс-доставки “Пятёрочки”.
В статье я расскажу о том, как мы решали вопрос автоматизации оценки эффективности большого количества маркетинговых кампаний с помощью бутстрапа в PySpark. Я опишу различные подходы к реализации бутстрапа с их плюсами и минусами, а также расскажу об итоговом варианте, который мы выбрали для себя.
Небольшой сэмпл данных и тетрадки с примерами запусков описанных ниже вариантов реализации можно увидеть в Читать полностью »
2003–2023: Краткая история Big Data
2022-12-04 в 10:00, admin, рубрики: Apache, AWS, big data, data engineering, GCP, Hadoop, Microsoft Azure, ruvds_перевод, spark, sql, Блог компании RUVDS.com, Большие данные, хранилища данных
Большие данные (Big Data) и, в частности, экосистема Hadoop появились немногим более 15 лет назад и развились к сегодняшнему дню так, как мало кто мог тогда предположить.
Ещё только появившись, опенсорсный Hadoop сразу стал популярным инструментом для хранения и управления петабайтами данных. Вокруг него сформировалась обширная и яркая экосистема с сотнями проектов, и он до сих пор используется многими крупными компаниями, даже на фоне современных облачных платформ. В текущей статье я опишу все эти 15 лет1 эволюции экосистемы Hadoop, расскажу о её росте в течение последнего десятилетия, а также о последних шагах в развитии сферы больших данных за последние годы.
Так что пристегнитесь и настройтесь на путешествие во времени вглубь 20 последних лет, поскольку наша история начинается в 2003 году в маленьком городке к югу от Сан-Франциско…
Дисклеймер: изначально я планировал оформить статью логотипами упоминаемых в ней компаний и программ, но на TDS запрещено обширное использование логотипов, поэтому я решил украсить содержание случайными изображениями и справочной информацией. Весело вспоминать, где мы в те времена находились и чем занимались.
Microsoft ML Spark: расширение Spark, делающее SparkML человечнее, и LightGBM как бонус
2019-06-24 в 14:03, admin, рубрики: big data, machine learning, Raiffeisenbank, raiffeisenIT, scala, spark, Блог компании Райффайзенбанк, машинное обучениеМногие, кто работал с Spark ML, знают, что некоторые вещи там сделаны "не совсем удачно"
или не сделаны вообще. Позиция разработчиков Spark в том, что SparkML — это базовая платформа, а все расширения должны быть отдельными пакетами. Но это не всегда удобно, ведь Data Scientist и аналитики хотят работать с привычными инструментами (Jupter, Zeppelin), где есть большая часть того, что нужно. Они не хотят собирать при помощи maven-assembly JAR-файлы на 500 мегабайт (для чего необходимо еще и минимальное знание JVM-программирования). Просить же DevOps-ов и администраторов кластера ставить кучу пакетов на вычислительные ноды — явно плохая идея. Тот, кто писал расширения для SparkML самостоятельно, знает, сколько там скрытых трудностей с важными классами и методами (которые почему-то private[ml]), ограничениями на типы сохраняемых параметров и т.д.
И кажется, что теперь, с библиотекой MMLSpark, жизнь станет немного проще, а порог вхождения в масштабируемое машинное обучение со SparkML и Scala чуть ниже.