

Мечтаете запустить нейросеть на компьютере и анализировать целые книги или сложные документы? Тогда объём VRAM и поддержка длинных контекстов — ваши главные приоритеты.
Мечтаете запустить нейросеть на компьютере и анализировать целые книги или сложные документы? Тогда объём VRAM и поддержка длинных контекстов — ваши главные приоритеты.
После сборки домашнего сервера для работы с LLM DeepSeek-R1 подробно о нём можно прочитать в статье Локальный DeepSeek-R1-0528. Когда скорость улитки – не приговор, а точка старта возникла потребность сравнить разные квантизации для оптимизации скорости/качества работы. Запуская работу с разными моделями, я заметил что квантизация зачастую приводит к ускорению генерации токенов.
Читать полностью »
У меня возникло желание запустить локальную версию DeepSeek R1 и V3. Это связано с необходимостью избежать рисков связанных с блокировками доступа и утечкой данных. Ещё добавилось желание протестировать разнообразные настройки LLM. До этого момента я пробовал запускать разные небольшие модели исключительно на cpu. А вот опыта с большими моделями не было.
В последнее время большие языковые модели (LLM) становятся все более популярными, но для их эффективного запуска требуется значительная вычислительная мощность. Один из способов запуска LLM локально - использование библиотеки Llama.cpp. В этой статье мы рассмотрим, как тестировать производительность видеокарт для LLM с использованием инструмента llama-bench, входящего в состав Llama.cpp.
Некоторые люди предпочитают пользоваться не только облачными сервисами, но и запускать LLM у себя дома. Например, так можно запустить дообученные модели без цензуры, или не посылать в облако свои личные документы. А то и запускать бесчеловечные эксперименты над LLM так, чтобы superintelligence/skynet потом это не припомнил.

Есть много моделей, оптимизированых для быстрой работы на устройствах с небольшой памятью. Но к сожалению, веса самых продвинутых моделей, которые играют в одной лиге с лучшими онлайн моделями, занимают сотни гигабайт. Например, 8-битные веса Deepseek R1-671B занимают 700 гигабайт, квантованые q4 — 350 гигов. Можно квантовать и в 1 бит, размер тогда будет около 90 гигов, но такая модель почти бесполезна. Еще есть много качественных finetunes на основе Mistral-Large-instruct-130B, Qwen2.5-72B, llama3.3-70B, веса которых также не помещаются в память старших моделей видеокарт.

Многие онлайн-сервисы предлагают доступ к проприетарным LLM. Однако по различным причинам может возникнуть необходимость использовать эти модели на своем оборудовании. Аренда серверов, особенно с GPU, может быть дорогой и зависит от требований к RAM/VRAM. Квантование моделей помогает снизить эти требования.
Итак, в этой статье мы:
Расскажем о квантовании и как оно помогает в выборе оборудованияЧитать полностью »
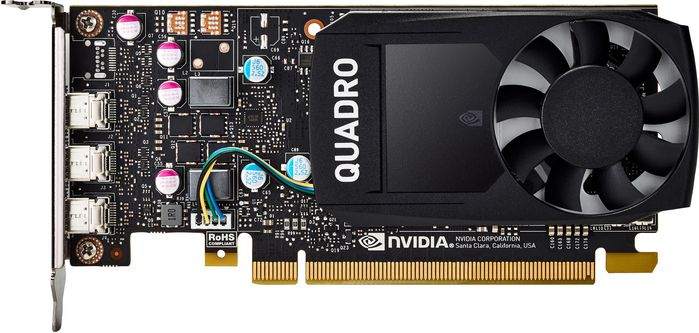
Сразу упомянем, что на серверах RUVDS установлены видеокарты NVIDIA Quadro P4000 (на фото). Карты довольно слабенькие, так что подойдут скорее для проектов в образовательных целях и т. д. Тем более что под VPS выделяется максимум 1 ГБ видеопамяти. Но даже в таких спартанских условиях можно запустить LLM.
Кстати, о VPS с видеокартой. Несколько лет назад мы уже писали о сферах их применения и даже проводили тесты. Всё это можно найти здесь.Читать полностью »