
В посте речь пойдет о написании утилиты для нагрузочного тестирования HTTP сервисов на Node.js, а также описание самого инструмента и области его использования.
Читать полностью »
Рубрика «параллельное программирование» - 27
Пишем свой нагрузочный тестер на Node.js
2015-01-31 в 21:30, admin, рубрики: highload, node.js, параллельное программирование, Программирование, Тестирование веб-сервисовPosix threads
2015-01-23 в 10:14, admin, рубрики: параллельное программирование, потоки, потокобезопасность 
Рано или поздно любой программист в своей жизни встречается с многопоточностью.
Многопоточность – это свойство алгоритма распаралеливатся, т.е. выполнять операции некими вычислителями независимо друг от друга.
Самый простой пример — это программирование GUI. GUI всегда должен быть отрисован, вне зависимости от того, что делается в программе. Например, loading screen – он всего лишь показывает прогресс, по мере загрузки ресурсов. И выглядит это примерно так:

Для решения подобных задач используются потоки (threads). Почти каждый язык программирования содержит свой wrapper над потоками ОС, или реализует свои потоки (привет, велосипед). На Хабре есть довольно много статей про потоки, например, «Что такое нити (threads)?» или «Многопоточность в Java». В общем, поиск в помощь. Но эта статья будет отличатся тем, что здесь будут рассмотрены нативные потоки ОС – POSIX threads.
Читать полностью »
Ещё раз (надеюсь, последний) про double-checked locking
2015-01-16 в 10:09, admin, рубрики: dcl, double checked lock, java, singleton, инициализация, параллельное программированиеСтатей про double-checked locking на Хабре было столько, что казалось бы ещё одна — и Хабр лопнет. Вот только по Java неплохие публикации: Реализация Singleton в JAVA, Правильный Singleton в Java, А как же всё-таки работает многопоточность? Часть II: memory ordering или вот замечательный пост от TheShade (слава web-archive!). В наши дни, наверно, каждый Java-разработчик слышал, что если используешь DCL, будь добр объявить переменную volatile. Найти сегодня в коде известных опенсорсных проектов DCL без volatile довольно трудно, но оказалось, что проблемы ещё не полностью решены. Поэтому я добавлю небольшую заметку по теме с примерами из реальных проектов.
Иногда складывается ощущение, что программисты не включают мозги и не пытаются понять, как что работает, а просто следуют простым и понятным правилам вроде «объяви переменную volatile, используй DCL, и всё будет хорошо». К сожалению, такой подход в программировании не всегда работает.
Читать полностью »
Параллельное программирование с CUDA. Часть 2: Аппаратное обеспечение GPU и шаблоны параллельной коммуникации
2014-12-10 в 15:15, admin, рубрики: CUDA, gpgpu, Udacity, Блог компании EPAM Systems, параллельное программированиеСодержание
Часть 1: Введение.
Часть 2: Аппаратное обеспечение GPU и шаблоны параллельной коммуникации.
Часть 3: Фундаментальные алгоритмы GPU: свертка (reduce), сканирование (scan) и гистограмма (histogram).
Часть 4: Фундаментальные алгоритмы GPU: уплотнение (compact), сегментированное сканирование (segmented scan), сортировка. Практическое применение некоторых алгоритмов.
Часть 5: Оптимизация GPU программ.
Часть 6: Примеры параллелизации последовательных алгоритмов.
Часть 7: Дополнительные темы параллельного программирования, динамический параллелизм.
Читать полностью »
Параллельное программирование с CUDA. Часть 1: Введение
2014-12-10 в 12:22, admin, рубрики: CUDA, gpgpu, Udacity, Блог компании EPAM Systems, параллельное программированиеЕще одна статья о CUDA — зачем?
На Хабре было уже немало хороших статей по CUDA — раз, два и другие. Однако, поиск комбинации «CUDA scan» выдал всего 2 статьи никак не связанные с, собственно, алгоритмом scan на GPU — а это один из самых базовых алгоритмов. Поэтому, вдохновившись только что просмотренным курсом на Udacity — Intro to Parallel Programming, я и решился написать более полную серию статей о CUDA. Сразу скажу, что серия будет основываться именно на этом курсе, и если у вас есть время — намного полезнее будет пройти его.
Читать полностью »
Lock-free структуры данных. Диссекция очереди
2014-12-09 в 7:00, admin, рубрики: c++, lock-free, queue, параллельное программирование, Программирование 
Со времени предыдущего поста из жизни lock-free контейнеров прошло немало времени. Я рассчитывал быстро написать продолжение трактата об очередях, но вышла заминка: о чем писать, я знал, но реализации на C++ этих подходов у меня не было. «Не годится писать о том, что сам не попробовал», — подумал я, и в результате я попытался реализовать в libcds новые алгоритмы очередей.
Сейчас настал момент, когда я могу аргументированно продолжить свой цикл. В данной статье закончим с очередями.
Кратко напомню, на чем я остановился. Были рассмотрены несколько интересных алгоритмов lock-free очередей, а под занавес приведены результаты их работы на некоторых синтетических тестах. Главный вывод — всё плохо! Надежды на то, что lock-free подход на магическом compare-and-swap (CAS) даст нам пусть не линейный, но хотя бы какой-то рост производительности с увеличением числа потоков, не оправдались. Очереди не масштабируются. В чем причина?..
Читать полностью »
Атомарные и неатомарные операции
2014-12-03 в 9:31, admin, рубрики: c++, c++11, std::atomic, многопоточное программирование, параллельное программирование, перевод 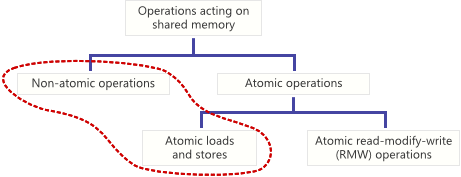
В Сети уже очень много написано об атомарных операциях, но в основном авторы рассматривают операции чтения-модификации-записи. Однако, существуют и другие атомарные операции, например, атомарные операции загрузки (load) и сохранения (store), которые не менее важны. В этой статье я сравню атомарные загрузки и сохранения с их неатомарными аналогами на уровне процессора и компилятора C/C++. По ходу статьи мы также разберемся с концепцией «состояния гонок» с точки зрения стандарта C++11.
Читать полностью »
Процессоры, ядра и потоки. Топология систем
2014-11-25 в 6:07, admin, рубрики: apic, apicid, cpu topology, cpuid, logical processor, multicore, multithreading, Блог компании Intel, параллельное программирование, системное программированиеВ этой статье я попытаюсь описать терминологию, используемую для описания систем, способных исполнять несколько программ параллельно, то есть многоядерных, многопроцессорных, многопоточных. Разные виды параллелизма в ЦПУ IA-32 появлялись в разное время и в несколько непоследовательном порядке. Во всём этом довольно легко запутаться, особенно учитывая, что операционные системы заботливо прячут детали от не слишком искушённых прикладных программ.

Используемая далее терминология используется в документации процессорам Intel. Другие архитектуры могут иметь другие названия для похожих понятий. Там, где они мне известны, я буду их упоминать.
Цель статьи — показать, что при всём многообразии возможных конфигураций многопроцессорных, многоядерных и многопоточных систем для программ, исполняющихся на них, создаются возможности как для абстракции (игнорирования различий), так и для учёта специфики (возможность программно узнать конфигурацию).
Читать полностью »
Семафоры, или как разруливать доступ к ресурсам в DBMS Caché
2014-11-17 в 8:05, admin, рубрики: cache, cache object script, dbms, dbms cache, intersystems cache, Блог компании InterSystems, доступ к объектам, общий доступ, параллельное программирование, Программирование, семафоры Часто при многопользовательском или параллельном доступе к данным возникает ситуация, когда необходимо заблокировать/дать доступ к переменной или участку памяти одновременно нескольким процессам. Решается данная задача с помощью мьютексов, семафоров, мониторов и т. д. В данном посте рассмотрим как же реализован один из методов предоставления совместного доступа к данным — семафор — в СУБД Intersystems Caché.


Читать полностью »