Рубрика «параллельное программирование» - 26

Lock-free структуры данных. Concurrent maps: деревья - 1 Это последняя, на сегодняшний день, статья из цикла про внутреннее устройство конкурентных ассоциативных контейнеров. В предыдущих статьях рассматривались hash map, был построен алгоритм lock-free ordered list и контейнеры на его основе. За бортом остался один важный тип структур данных — деревья. Пришло время немного рассказать и о них.

Исследования, посвященные алгоритмам конкурентных деревьев, не требующих внешней синхронизации доступа к ним, начались довольно давно — в 70-х годах прошлого века, — и были инициированы развитием СУБД, поэтому касались в основном оптимизации страничных деревьев (B-tree и его модификации).

Развитие lock-free подхода в начале 2000-х не прошло мимо алгоритмов деревьев, но лишь недавно, в 2010-х годах, появилось множество действительно интересных работ по конкурентным деревьям. Алгоритмы деревьев довольно сложны, поэтому исследователям потребовалось время — порядка 10 лет — на их lock-free/non-blocking адаптацию. В данной статье мы рассмотрим самый простой случай — обычное бинарное дерево, даже не самобалансирующееся.
Читать полностью »
Обмен данными с использованием MPI. Работа с библиотекой MPI на примере Intel® MPI Library - 1

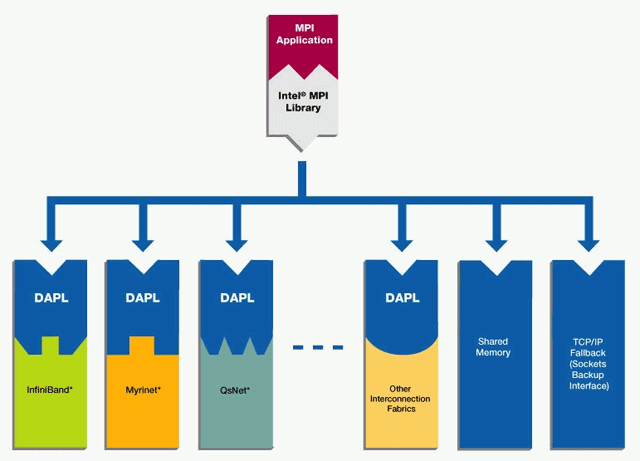
В этом посте мы расскажем об организации обмена данными с помощью MPI на примере библиотеки Intel® MPI Library. Думаем, что эта информация будет интересна любому, кто хочет познакомиться с областью параллельных высокопроизводительных вычислений на практике.

Мы приведем краткое описание того, как организован обмен данными в параллельных приложениях на основе MPI, а также ссылки на внешние источники с более подробным описанием. В практической части вы найдете описание всех этапов разработки демонстрационного MPI-приложения «Hello World», начиная с настройки необходимого окружения и заканчивая запуском самой программы.
Читать полностью »

Lock-free структуры данных. Concurrent maps: skip list - 1
В предыдущих статьях (раз, два) мы рассматривали классический hash map с хеш-таблицей и списком коллизий. Был построен lock-free ordered list, который послужил нам основой для lock-free hash map.
К сожалению, списки характеризуются линейной сложностью поиска O(N), где N — число элементов в списке, так что наш алгоритм lock-free ordered list сам по себе представляет небольшой интерес при больших N.
Или все же представляет?..
Читать полностью »

Я хочу поделиться со всеми читателями интересной темой, с которой столкнулся совсем недавно, и мне она понравилась. Развитие этой темы доставило мне удовольствие и добавило немного опыта в копилку. Вероятно, многие, а может и нет, сталкивались с пулом соединений БД. После ознакомления с этой интересной опцией мне захотелось написать статью и поделиться ею с вами. Возможно, статья получится немного длинной, но я думаю, что данный пост кому-то все же будет интересно почитать, и его заинтересует данная тема. Может быть наработки с этой статьи кто-то использует в своем проекте, в любом случае, мне будет интересно ее писать и рассказывать ее вам.

Читать полностью »

Lock-free структуры данных. Concurrent maps: rehash, no rebuild - 1
Пройдем по следам C++ 2015 Russia далее.
В предыдущей статье мы рассмотрели алгоритм для lock-free ordered list и на его основе сделали простейший lock-free hash map. У этого hash map есть недостаток: размер хеш-таблицы постоянен и не может быть изменен в процессе роста числа элементов в контейнере. Это не представляет проблемы, если мы заранее примерно представляем требуемый объем контейнера. А если нет?
Читать полностью »

Lock-free структуры данных. Concurrent map: разминка - 1
Мне оказали честь — пригласили выступить на первой конференции C++ 2015 Russia 27-28 февраля. Я был насколько наглым, что запросил 2 часа на выступление вместо положенного одного и заявил тему, наиболее меня интересующую — конкурентные ассоциативные контейнеры. Это hash set/map и деревья. Организатор sermp пошел навстречу, за что ему большое спасибо.
Как подготовиться ко столь ответственному испытанию выступлению? Первое — нарисовать презентацию, то есть кучу картинок, желательно близко к теме. Но надо ещё и два часа озвучивать картинки, — как все это запомнить? Как избежать глубокомысленных «ээээмммм», «здесь мы видим», «на этом слайде показано», несвязных прыжков повествования и прочих вещей, характеризующих выступающего c не очень хорошей стороны в части владения родным языком (это я про русский, с C++ я разобрался быстро — никакого кода в презентации, только картинки)?
Конечно, надо записать свои мысли, глядя на слайды. А если что-то написано, то не худо бы и опубликовать. А если публиковать, — то на хабре.
Итак, по следам C++ 2015 Russia! Авторское изложение, надеюсь, без авторского косноязычия, без купюр и с отступлениями по теме, написанное до наступления события, в нескольких частях.
Читать полностью »

Intel® Graphics Technology: «выгружаем» вычисления на графику - 1

Продолжаем начатый разговор о Intel® Graphics Technology, а именно о том, что у нас есть в распоряжении с точки зрения написания кода: прагмы offload и offload_attribute для оффлоадинга, атрибуты target(gfx) и target(gfx_kernel), макросы __GFX__ и __INTEL_OFFLOAD, интринсики и набор API функций для асинхронного оффлоада. Это всё, что нужно нам для счастья. Чуть было не забыл: конечно, нам нужен компилятор от Intel и магическая опция /Qoffload.
Но обо всё по порядку. Одна из основных идей – это относительно легкая модификация существующего кода, выполняемого на CPU для его выполнения на интегрированной в процессор графике.
Читать полностью »

Всем привет!

У нас большая удача! Нам удалось договориться с Дмитрием Леневым, уникальным специалистом, разработчиком MySQL Server с 11-летним стажем, о выступлении на CodeFreeze. Москвичи, обязательно приходите!

Итак, в четверг, 19 февраля, в 20:00 в московском офисе Mail.Ru состоится встреча CodeFreeze с Дмитрием Леневым, разработчиком MySQL Server в компании Oracle. Доклад будет посвящен обзору менеджеров блокировок данных в MySQL (включая блокировки метаданных, таблиц и блокировок InnoDB). Будут обсуждаться предназначение каждого из видов и архитектура этих менеджеров.

[Москва, 19.02.2015] Дмитрий Ленев — Менеджеры блокировок в MySQL - 1

Читать полностью »

Анализ OpenMP регионов с Intel® VTune™ Amplifier XE - 1
OpenMP* — довольно популярная модель параллельного программирования, особенно для высокопроизводительных вычислений. Но чтобы этой высокой производительности достичь, OpenMP конструкции частенько приходится «настраивать». И здесь не обойтись без хорошего профилировщика. Большинство профилировщиков выдают данные о производительности, ассоциированные с функциями или циклами, но не дают картины по конкретным OpenMP регионам. В результате программист теряет контекст. А без OpenMP-контекста диагностика дисбалансов или накладных расходов становится весьма затруднительной.
Intel® VTune™ Amplifier XE умеет профилировать OpenMP регионы. Свежая версия 2015 Update 2 делает анализ гораздо более простым и понятным, благодаря представлению данных в «OpenMP терминах». Инструмент показывает время параллельных и последовательных регионов, разницу между фактическим и идеализированным временем исполнения региона, разбивку по параллельным циклам и загрузку ЦПУ по каждому региону в отдельности.
Пользователь может легче понять, куда вкладывать усилия в первую очередь, благодаря метрике «potential gain». Классификация накладных расходов помогает определить причину неэффективности – например, ожидание из-за дисбаланса нагрузки или на «замке» из-за синхронизации.
Статья описывает некоторые типы OpenMP проблем, определяемых VTune Amplifier, как их нужно понимать и устранять.
Читать полностью »

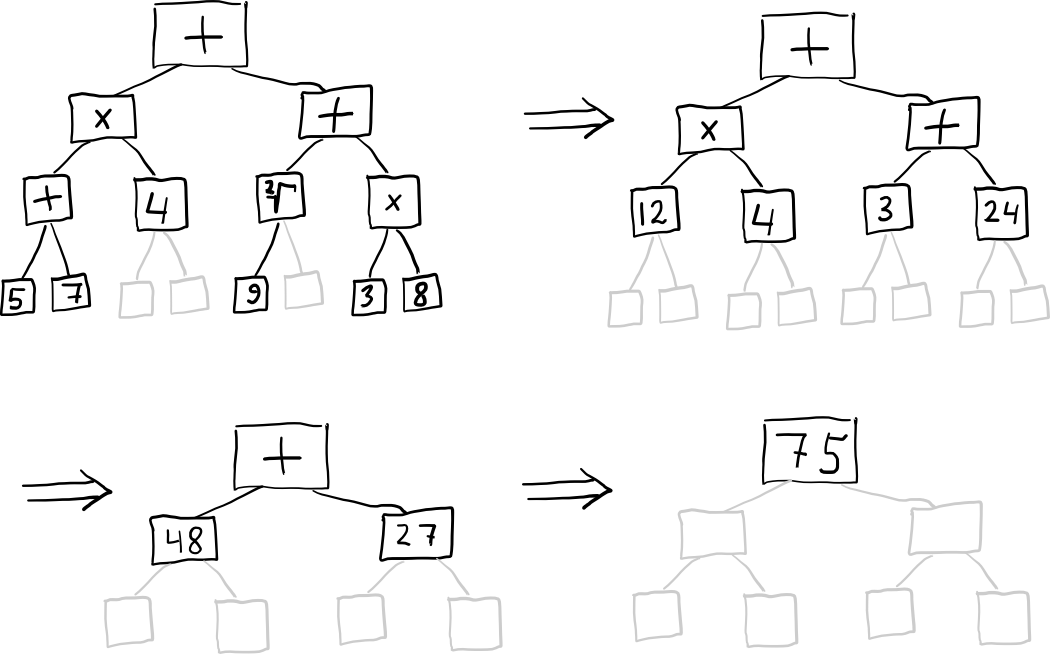
Здравствуйте. В этой статье я расскажу про свой хобби-проект не-фон неймановского компьютера. Архитектура соответствует функциональной парадигме: программа есть дерево применений элементарных функций друг к другу. Железо — однородная статическая сеть примитивных узлов, на которую динамическое дерево программы спроецировано, и по которой программа «ползает» вычисляясь. Не-фон неймановский компьютер на базе комбинаторной логики - 1
Примерно так работает дерево, только здесь для наглядности вычисляются арифметическое выражение, а не комбинаторное; шаг на рисунке — один такт машины.

Сейчас готов ранний прототип, существующий как в виде потактового программного симулятора, так и в виде реализации на ПЛИС.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js