Рубрика «параллельное программирование» - 25

Введение

Данная статья кратко описывает распараллеливание расчетов на вычислительных мощностях CPU и GPU. Перед тем как перейти к описанию самих алгоритмов, ознакомлю вас с поставленной задачей.

Необходимо смоделировать систему решения задач методом конечных разностей. С математической точки зрения это выглядит следующим образом. Дана некоторая конечная сетка:

Распараллеливание расчетов на CPU и GPU - 1

Неизвестные значения сетки находятся по следующей формуле методом конечных разностей:

Распараллеливание расчетов на CPU и GPU - 2
Читать полностью »

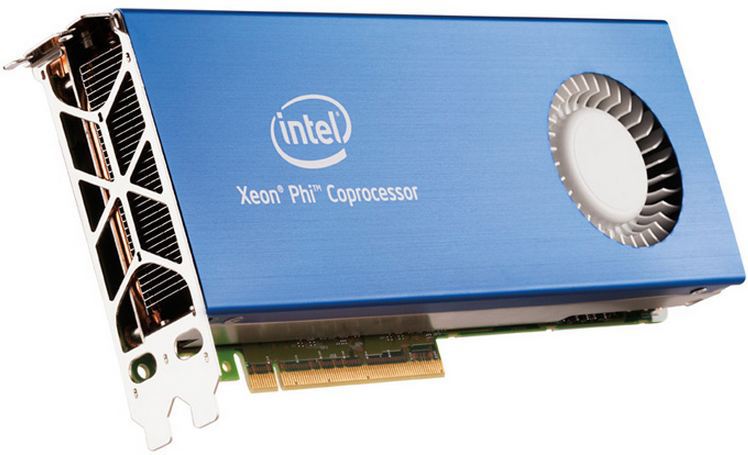
Сопроцессоры Intel Xeon Phi(TM) представляют собой PCI Express устройство и имеют x86 архитектуру, обеспечивая высокую пиковую производительности — до 1,2 терафлопс (триллион операций с плавающей запятой в секунду) двойной точности на сопроцессор. Xeon Phi(TM) может обеспечивать одновременную работу до 244 потоков, и это нужно учитывать при программировании для достижения максимальной эффективности.

Недавно мы вместе с компанией Intel проводили небольшое исследование эффективности реализации алгоритма Штрассена для сопроцессора Intel Xeon Phi(TM). Кому интересны тонкости работы с этим устройством и просто любящих параллельное программирование, прошу под кат.

Распараллеливание алгоритма Штрассена на Intel® Xeon Phi(TM) - 1

Читать полностью »

Решил тут я подтянуть свой английский язык. В частности, захотелось значительно расширить словарный запас. Я знаю, что существует масса программ, которые в игровой форме помогают это сделать. Загвоздка в том, что я не люблю геймфикацию. Предпочитаю по старинке. Листочек бумаги где таблица со словами, транскрипцией и переводом. И учим его учим. И проверяем свои знания, например, закрывая столбец с переводом. В общем, как я учил это в университете.

Прослышал я про то, что существует 3000 наиболее часто используемых слов, подобранных на OxfordDictionary сайте. Вот тут этот список слов: www.oxfordlearnersdictionaries.com/wordlist/english/oxford3000/Oxford3000_A-B Ну а перевод на русский я решил брать отсюда: www.translate.ru/dictionary/en-ru Одна только проблема, все находиться на этих сайтах ну совсем не в том формате, который можно распечатать и учить. В итоге родилась идея это все запрограммировать. Но сделать это не как последовательный алгоритм, а все распаралелить. Что бы выкачивание и парсинг всех слов занял не (3000 слов * 2 сайта) / 60 секунд = 100 минут. Это если давать по 1 секунде на выкачивание и распарсивание страницы для извлечения перевода и транскрипции (в реальности думаю это в 3 раза дольше, пока соединение откроем, пока закроем и тд и тп).

image
Читать полностью »

Rust начинался как проект, решающий две трудные проблемы:

  • Как обеспечить безопасность (работы с памятью) в системном программровании?
  • Как сделать многопоточное программирование безболезненным?

Изначально эти проблемы казались не связанными друг с другом, но к нашему удивлению, их решение оказалось одинаковым — проблемы с многопоточностью решают те же самые инструменты, которые обеспечивают безопасность.

Ошибки работы с памятью и ошибки при работе с несколькими потоками частно сводятся к тому, что код обращается к некоторым данным вопреки тому, что он не должен этого делать. Секретное оружие Rust против этого — концепция владения данными, способ управления доступом к данным, которого системные программисты стараются придерживаться самостоятельно, но который Rust проверяет статически.

С точки зрения безопасности работы с памятью это означает, что вы можете не использовать сборщик мусора и в то же время не опасаться сегфолтов, потому что Rust не даст вам совершить ошибку.

С точки зрения многопоточности это означает, что вы можете пользоваться различными парадигмами (передача сообщений, разделяемое состояние, lock-free-структуры данных, чистое функциональное программирование), и Rust позволит избежать наиболее распространённых подводных камней.

Вот какие особенности у многопоточного программирования в Rust:

Читать полностью »

Что такое Arduino, думаю, большинству читателей Хабра объяснять не надо. По сути, это удобный радиоконструктор для быстрой разработки электронных устройств. Но многие не знают, что между его основателями разгорелся большой спор, который в настоящее время находится на рассмотрении в Массачусетском районном суде. От решения данного спора зависит будущее проекта.

image
Читать полностью »

На днях появилась статья 5nw Два способа быстрого вычисления факториала, в которой приводится идея ускорения подсчёта факториала с помощью группировки перемножаемых чисел в дерево по принципу «разделяй и властвуй». Взглянув на это, я сразу понял, что тут параллельные потоки Java проявят себя во всей красе: ведь они делят задачу на подзадачи с помощью сплитераторов именно таким образом. Получается, что быстрая реализация будет ещё и красивой:

public static BigInteger streamedParallel(int n) {
    if(n < 2) return BigInteger.valueOf(1);
    return IntStream.rangeClosed(2, n).parallel().mapToObj(BigInteger::valueOf).reduce(BigInteger::multiply).get();
}

Читать полностью »

Содержание

Часть 1: Введение.
Часть 2: Аппаратное обеспечение GPU и шаблоны параллельной коммуникации.
Часть 3: Фундаментальные алгоритмы GPU: свертка (reduce), сканирование (scan) и гистограмма (histogram).
Часть 4: Фундаментальные алгоритмы GPU: уплотнение (compact), сегментированное сканирование (segmented scan), сортировка. Практическое применение некоторых алгоритмов.
Часть 5: Оптимизация GPU программ.
Часть 6: Примеры параллелизации последовательных алгоритмов.
Часть 7: Дополнительные темы параллельного программирования, динамический параллелизм.

Disclaimer

Эта часть в основном теоретическая, и скорее всего не понадобится вам на практике — все эти алгоритмы уже давно реализованы в множестве библиотек.

Читать полностью »

Большое обновление пакета Intel® Parallel Studio XE вышло на этой неделе. Версия 2016 включает три совершенно новых продукта:

  1. Intel® Data Analytics Acceleration Library (Intel® DAAL) – C++ и Java решение для аналитики данных (статистика, машинное обучение и другое).
  2. Новый Vectorization Advisor в составе Intel® Advisor XE 2016 Beta для оптимизации кода под SIMD инструкции, т.е. векторизации.
  3. MPI Performance Snapshot для быстрой общей оценки производительности MPI программ.

Бета-версия доступна публично и бесплатно, программа длится до 23 июня, но лицензии будут работать вплоть до 25 сентября 2015 г. Для получения Бета-версии нужно зарегистрироваться здесь.
Эта статья посвящена обзору нового функционала, более детально отдельные продукты постараемся осветить в последующих блогах – пишите в комментариях, к чему есть интерес.
Читать полностью »

Многопоточная модель программирования предоставляет удобную абстракцию для разработки параллельных программ. К сожалению, большие накладные расходы потоков операционной системы на память и переключение контекстов сильно ограничивают их применение. Легковесные (прикладные, пользовательские) потоки не имеют таких проблем, так как требуют значительно меньше памяти и гораздо меньше нагружают процессор при переключении контекстов, что позволяет запустить большое количество таких потоков в приложении. Также легковесные потоки позволяют разрабатывать асинхронные приложения без использования обратных вызовов, что делает код чище и проще для понимания.

Потоки Java соответствуют потокам ядра и поэтому обладают всеми присущими им недостатками. В сети можно найти проекты, целью которых является отказ от потоков Java и реализация пользовательских потоков. Самые известные перечислены ниже.

Kilim — один из первых «рабочих» проектов, реализующих легковесные потоки. Библиотека предоставляет средства для создания приложений, основанных на обмене сообщениями. Из-за соответствующего API данную библиотеку можно рассматривать скорее как реализующую модель акторов, чем потоковую модель.

Quasar — другой проект, реализующий прикладные потоки, называемые нитями (fibers). Кроме легковесных потоков библиотека предоставляет построенную на нитях реализацию модели акторов. Хотя API нитей похож на API потоков Java, чтобы воспользоваться средствами библиотеки, потребуется переписать код приложения.

В данной статье рассматривается проект Zephyr. Его отличие от первых двух проектов заключается в том, что средства библиотеки позволяют «превратить» обычные потоки в легковесные, не изменяя кода приложения. В действительности библиотека позволяет использовать любую реализацию потоков, и легковесные потоки являются одной из возможных реализаций.
Читать полностью »

image

В комментариях к прошлому посту был поднят весьма важный вопрос – а будет ли вообще выигрыш в производительности от выгрузки вычислений на интегрированную графику, по сравнению с выполнением только на CPU? Конечно, он будет, но нужно соблюдать определенные правила программирования для эффективных вычислений на GFX+CPU.
В подтверждение моих слов, сразу представлю график ускорения, получаемого при выполнении вычислений на интегрированной графике, для различных алгоритмов и с разной долей вовлеченности CPU. На КДПВ мы видим, что выигрыш более чем весомый.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js