
Сортировка является одной из базовых операций при обработке данных, которая используется в самом широком спектре задач. В данной статье будет рассмотрена сеть обменной сортировки со слиянием Бэтчера для параллельной сортировки массива произвольного размера.
Рубрика «параллельное программирование» - 24
Сеть обменной сортировки со слиянием Бэтчера
2016-02-16 в 8:12, admin, рубрики: C, Алгоритмы, паралельная сортировка, параллельное программирование, Программирование, Сеть сортировки, сортировка Бэтчера, метки: паралельная сортировка, Сеть сортировки, сортировка Бэтчера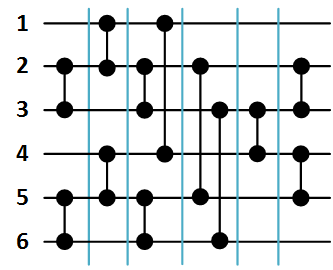
Визуализация concurrency в Go с WebGL
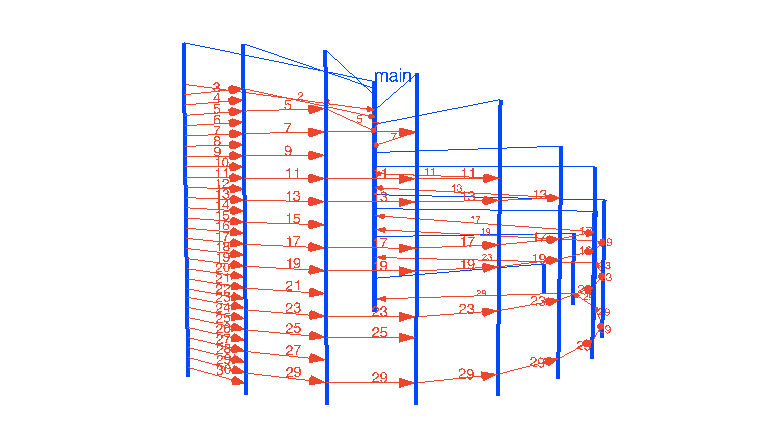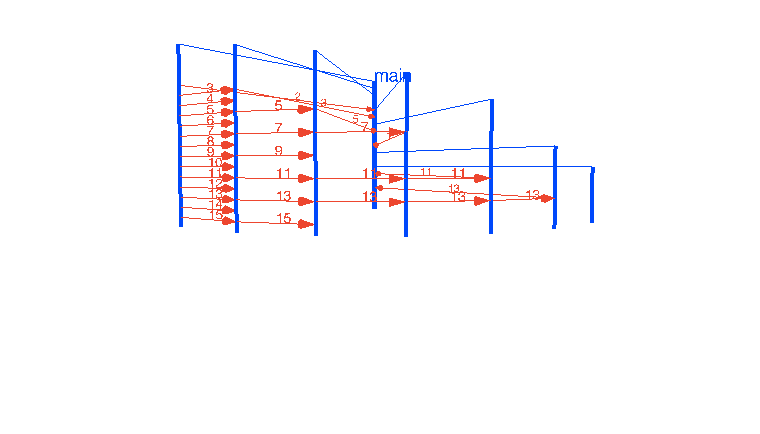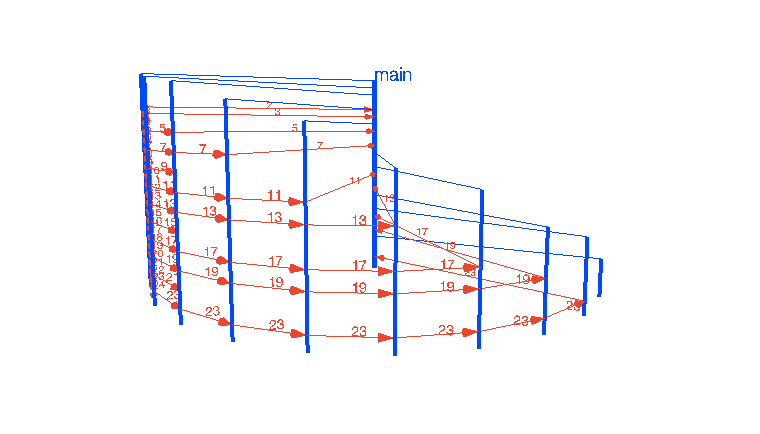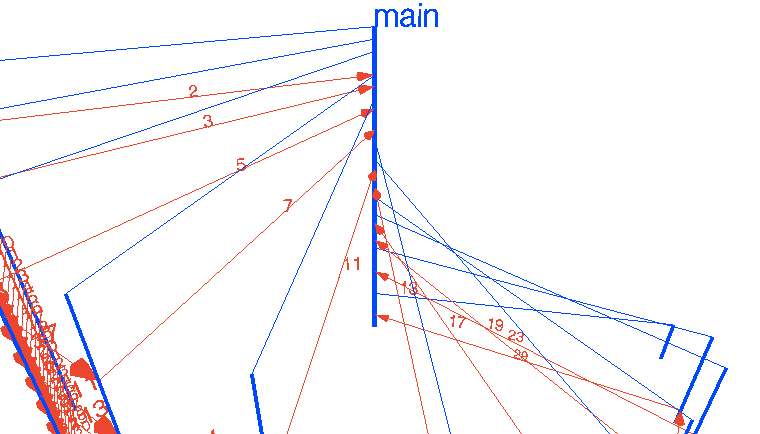
2016-01-31 в 12:19, admin, рубрики: concurrency, Go, parallelism, WebGL, визуализация данных, параллельное программирование, ПрограммированиеОдной из самых сильных сторон языка программирования Go является встроенная поддержка concurrency, основанная на труде Тони Хоара «Communicating Sequential Processes». Go создан для удобной работы с многопоточным программированием и позволяет очень легко строить довольно сложные concurrent-программы. Но задумывались ли вы когда-нибудь, как выглядят различные паттерны concurrency визуально?
Конечно, задумывались. Все мы, так или иначе, мыслим визуальными образами. Если я попрошу вас о чём-то, что включает числа «от 1 до 100», вы мгновенно их «увидите» в своей голове в той или иной форме, вероятно даже не отдавая себе в этом отчёт. Я, к примеру, ряд от 1 до 100 вижу как линия с числами уходящая от меня, поворачивающая на 90 градусов вправо на числе 20 и продолжающая до 1000+. И, покопавшись в памяти, я вспоминаю, что в самом первом детском саду в раздевалке вдоль стены были написаны номерки, и число 20 было как-раз в углу. У вас же, вероятно, какое-то свое представление. Или вот, другой частый пример — представьте круглый год и 4 сезона года — кто-то их видит как квадрат, каждая грань которого принадлежит сезону, кто-то — как круг, кто-то ещё как-то.
Так или иначе, позвольте мне показать мою попытку визуализировать основные паттерны concurrency с помощью Go и WebGL. Эти интерактивные визуализации более-менее отражают то, как я вижу это в своей голове. Интересно будет услышать, насколько это отличается от визуализаций читателей.
Читать полностью »
Конкурс GraphHPC-2016 на самую быструю реализацию параллельного алгоритма Community Detection
2016-01-20 в 16:12, admin, рубрики: community detection, gpgpu, graph processing, HPC, parallel programming, Алгоритмы, высокая производительность, параллельное программирование, Спортивное программирование 
Совсем скоро, в рамках третьей научно-технической конференции GraphHPC-2016, стартует конкурс GraphHPC, посвященный проблемам параллельной обработки больших графов с использованием суперкомьютеров. В этот раз участникам предстоит найти самую быструю реализацию задачи Community Detection (поиск сообществ) в неориентированном графе с весами.
Читать полностью »
FlyElephant как инструмент для вычислений на C++, R, Python или Octave
2016-01-20 в 12:31, admin, рубрики: big data, blender, c++, FlyElephant, gcc, gromacs, HPC, java, Julia, octave, OpenFOAM, openmp, python, R, SciLab, Блог компании FlyElephant, высокая производительность, научные расчёты, Облачные вычисления, параллельное программирование, стартапы 
Приветствую всех!
Сегодня я расскажу о возможностях платформы FlyElephant для ученых и инженеров, которые в своей работе проводят различные вычисления на C++, R, Python или Octave. Это могут быть научные расчеты, анализ данных, моделирование или другие задачи. 22 января я буду проводить вебинар “Введение в FlyElephant”, на котором детально расскажу о платформе FlyElephant, а сегодня в общих чертах познакомлю вас с ней и покажу процесс проведения расчетов.
FlyElephant — это платформа, которая предоставляет ученым готовую вычислительную инфраструктуру для проведения расчетов, автоматизирует рутинные задачи и позволяет сосредоточиться на основных вопросах исследований.
Читать полностью »
Как начать работать с MIPSfpga
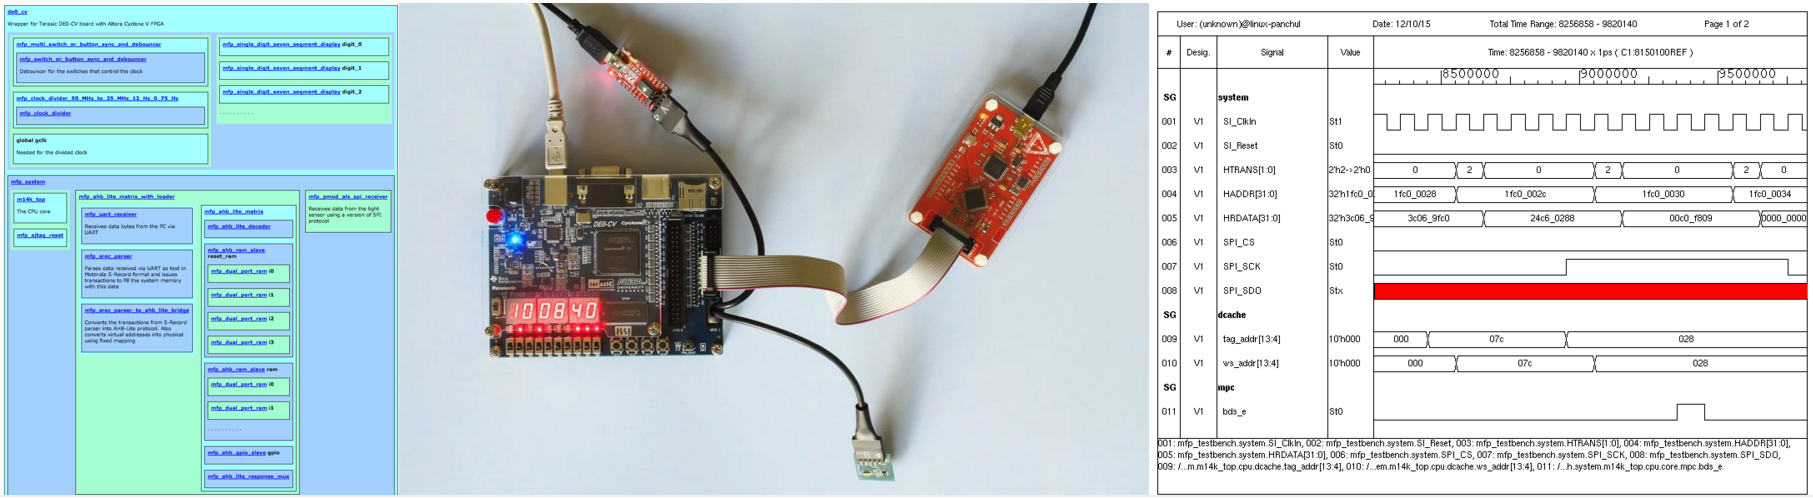
2016-01-16 в 5:59, admin, рубрики: Altera, fpga, imagination technologies, mips, MIPS microAptiv UP, MIPSfpga, SPI, uart, Verilog, vhdl, xilinx, Анализ и проектирование систем, параллельное программирование, ПЛИС, программирование микроконтроллеров, метки: плисMIPSfpga — это пакет, который содержит процессорное ядро в исходниках на Verilog, которое можно менять, добавлять новые инструкции, строить многопроцессорные системы, менять одновременно софтвер и хардвер, симулировать на симуляторе верилога, синтезировать для ПЛИС/FPGA и т.д. Его можно в целях эксперимента например запускать с частотой 1 такт в секунду и выводить наружу информацию о состоянии кэша, конвейера, и любых структур внутри процессора. При этом ядро MIPS microAptiv UP внутри MIPSfpga — это то же ядро которое например используется в платформе IoT Samsung Artik 1 и Microchip PIC32MZ, т.е. студенты получают возможность работать с тем же кодом, с которым работают инженеры в Samsung и Microchip.
MIPSfpga не предназначен для введения в предмет с абсолютного нуля. Для его плодотворного использования нужно чтобы студент или исследователь уже знал основы цифровой схемотехники, умел бы программировать на Си и на ассемблере, а также представлял бы концепции микроархитектуры — конвейера, конфликтов конвейера и т.д. Желательно, чтобы до работы с MIPSfpga студент уже бы построил собственный простой процессор с нуля и мог бы сравнивать свой простой процессор с процессором, используемым в промышленности и совместимым с развитой экосистемой разработки.
Новые инструменты (Octave и Scilab) во FlyElephant и анонс вебинаров
2016-01-11 в 14:08, admin, рубрики: big data, blender, c++, data mining, FlyElephant, gcc, gromacs, HPC, java, Julia, octave, OpenFOAM, openmp, python, R, SciLab, Блог компании FlyElephant, вебинар, высокая производительность, научные расчёты, Облачные вычисления, параллельное программирование, стартапы, метки: FlyElephant 
Команда FlyElephant поздравляет всех с наступившим Новым Годом. Мы начинаем этот год с расширения списка инструментов, вебинаров и формирования сообщества вокруг проекта.
FlyElephant — это платформа, которая предоставляет ученым готовую вычислительную инфраструктуру для проведения расчетов, автоматизирует рутинные задачи и позволяет сосредоточиться на основных вопросов исследований.
Для пользователей платформы FlyElephant стали доступны Octave и Scilab, таким образом полный список поддерживаемых языков и инструментов следующий: GCC (с поддержкой OpenMP), R, Python (v2 & v3), Octave и Scilab. Для участников программы бета-тестирования стал доступен следующий инструментарий: Java (v7 & v8), Julia, OpenFOAM, GROMACS и Blender. Если Вы еще не являетесь пользователем платформы FlyElephant, то зарегистрироваться можно здесь. В честь Нового Года Вы можете пополнить свой счет на $300 введя в Личном кабинете специальный промо-код: 195708679772.
Читать полностью »
Низкоуровневая оптимизация параллельных алгоритмов или SIMD в .NET
2016-01-08 в 23:04, admin, рубрики: .net, .net программирование, C#, c++, clr via csharp, JIT-компилятор, simd, высокая производительность, параллельное программирование, производительность приложений, С++, метки: .net программирование, производительность приложений 
В настоящее время огромное количество задач требует большой производительности систем. Бесконечно увеличивать количество транзисторов на кристалле процессора не позволяют физические ограничения. Геометрические размеры транзисторов нельзя физически уменьшать, так как при превышении возможно допустимых размеров начинают проявляться явления, которые не заметны при больших размерах активных элементов — начинают сильно сказываться квантовые размерные эффекты. Транзисторы начинают работать не как транзисторы.
А закон Мура здесь ни при чем. Это был и остается законом стоимости, а увеличение количества транзисторов на кристалле — это скорее следствие из закона. Таким образом, для того, чтобы увеличивать мощность компьютерных систем приходится искать другие способы. Это использование мультипроцессоров, мультикомпьютеров. Такой подход характеризуется большим количеством процессорных элементов, что приводит к независимому исполнение подзадач на каждом вычислительном устройстве.
Читать полностью »
Parallelism vs Concurrency: правильно подбираем инструменты
2016-01-05 в 18:10, admin, рубрики: concurrency, Erlang/OTP, Go, haskell, parallelism, Rust, stm, Блог компании Издательский дом «Питер», высокая производительность, параллельное программирование, производительность, метки: parallelismЗдравствуйте, уважаемыее! Мы решили возобновить публикации еще до окончания больших праздников, но в сегодняшней статье все-таки раскрыта тема справедливой раздачи подарков. Сама же статья, как понятно из названия, посвящена сравнительному анализу параллелизма и конкурентности.
Потоки vs процессы на примере нативного Node.js аддона для нагрузочного тестирования
2015-12-30 в 14:08, admin, рубрики: c++, multithreading, node.js, posix, параллельное программирование, Тестирование веб-сервисов Чуть меньше года назад я написал заметку о попытке создать инструмент нагрузочного тестирования на Node.js используя встроенные возможности (модули cluster и net). В комментариях справедливо указали на необходимость анализа RPS и сравнении с другими бенчмарками. В результате сравнения я пришел к естественному выводу, что многопроцессовый сервис никогда не сравнится по производительности с многопоточным из-за очень дорогих издержек на обмен данными (позже мы убедимся в этом на примере)
Читать полностью »
Rayon: параллелизм данных в Rust
2015-12-29 в 16:48, admin, рубрики: Rust, параллельное программирование, полиморфизм, Программирование, типобезорасность Последние пару недель я работал над обновление Rayon — моей экспериментальной библиотеки для параллелизма данных в Rust.
Я вполне доволен тем, как идёт разработка, так что я решил объяснить к чему я пришёл в блог посте.
Цель Rayon — сделать добавление параллелизма в последовательный код простым, так, чтобы любой цикл for или итератор можно было бы заставить работать в несколько потоков. Например если у вас есть такая цепочка итераторов:
let total_price = stores.iter()
                        .map(|store| store.compute_price(&list))
                        .sum()
то вы можете сделать её работу параллельной просто поменяв обычный «последовательный итератор» на «параллельный итератор» из Rayon:
let total_price = stores.par_iter()
                        .map(|store| store.compute_price(&list))
                        .sum()