
Мы продолжаем знакомство с современными сверхбольшими дата-центрами, начатое прошлой статьей, и сегодня поговорим о том, как решается одна из наиболее важных проблем — хранение данных. Кроме того, мы немного поговорим о ближайшем будущем таких мега-ЦОД.
Читать полностью »
Рубрика «big data» - 141
Мега-ЦОДы — пионеры инноваций. Часть 2
2013-06-24 в 10:02, admin, рубрики: big data, LSI, lsi nytro, высокая производительность, дата-центры, Железо, производительность, метки: LSI, lsi nytro, дата-центры, производительностьMap-Reduce на примере MongoDB
2013-06-21 в 10:43, admin, рубрики: big data, mongodb, nosql, метки: big data, map reduce, mongodb, nosqlВ последнее время набирает популярность семейство подходов и методологий обработки данных, объединенных общими названиями Big Data и NoSQL. Одной из моделей вычислений, применяемых к большим объемам данных, является технология Map-Reduce, разработанная в недрах компании Google. В этом посте я постараюсь рассказать о том, как эта модель реализована в нереляционной СУБД MongoDB.
Что касается будущего нереляционных баз вообще и технологии Map-Reduce в частности, то на эту тему можно спорить до бесконечности, и пост совершенно не об этом. В любом случае, знакомство с альтернативными традиционным СУБД способами обработки данных является полезным для общего развития любого программиста, так же как, к примеру, знакомство с функциональными языками программирования может оказаться полезным и для программистов, работающих исключительно с императивными языками.
Нереляционная СУБД MongoDB хранит данные в виде коллекций из документов в формате JSON и предоставляет разные способы обработки этих данных. В том числе, присутствует собственная реализация модели Map-Reduce. О том, насколько целесообразно применять именно эту реализацию в практических целях, будет сказано ниже, а пока ограничимся тем, что для ознакомления с самой парадигмой Map-Reduce эта реализация подходит как нельзя лучше.
Итак, что же такого особенного в Map-Reduce?
Читать полностью »
Улучшения XQuery в MarkLogic Server
2013-06-11 в 14:45, admin, рубрики: application server, big data, data mining, xquery, базы данных, Песочница, метки: application server, xquery, базы данныхВ MarkLogic Server реализован собственный диалект XQuery, который называется XQuery 1.0-ml. Не трудно догадаться, что это — тот самый XQuery 1.0 с некоторыми дополнениями от MarkLogic, призванными сделать жизнь разработчика лучше. Читать полностью »
Hadoop vs Dryad (или ничего личного)
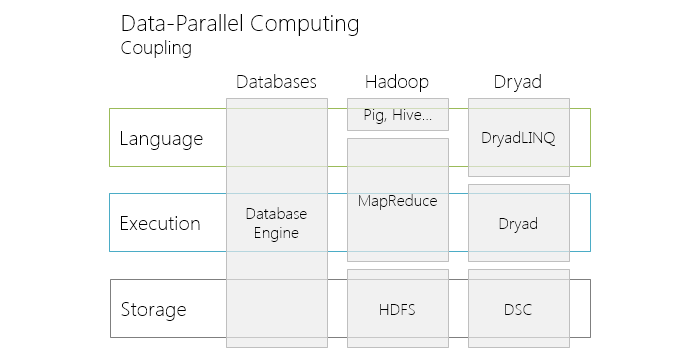
2013-06-10 в 22:59, admin, рубрики: .net, big data, dryad, Hadoop, microsoft research, высокая производительность, метки: big data, dryad, Hadoop, microsoft researchНа прошлой неделе на Хабре появилось 2 поста о фреймворке распределенных вычислений от Microsoft Research – Dryad. В частности, подробно были описаны концепции и архитектура ключевых компонентов Dryad – среды исполнения Dryad и языка запросов DryadLINQ.
Логическим завершением цикла статей о Dryad видится сравнение фреймворка Dryad с другими, знакомыми разработчикам MPP-приложений, инструментами: реляционными СУБД (в т.ч. параллельными), GPU-вычислениями и платформой Hadoop.
DryadLINQ. Распределенный LINQ от Microsoft Research
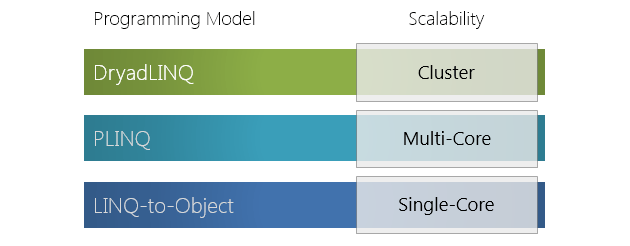
2013-06-06 в 6:28, admin, рубрики: .net, big data, dryad, microsoft, microsoft research, распределённые вычисления, метки: .net, big data, dryad, microsoft research, распределённые вычисленияПредметом внимания вчерашнего поста на Хабре стал фреймворк распределенных вычислений от Microsoft Research — Dryad.
В основе фреймворка лежит представление задания, как направленного ациклического графа, где вершины графа представляют собой программы, а ребра — каналы, по которым данные передаются. Также обзорно была рассмотрена экосистема фреймворка Dryad и сделан подробный обзор архитектуры одного из центральных компонентов экосистемы фреймворка – среды исполнения распределенных приложений Dryad.
В этой статье обсудим компонент верхнего уровня программного стэка фреймворка Dryad – язык запросов к распределенному хранилищу DryadLINQ.
Dryad. Фреймворк распределенных вычислений
2013-06-05 в 6:33, admin, рубрики: big data, computer science, высокая производительность, высокопроизводительные вычисления, параллельное программирование, параллельные вычисления, метки: big data, computer science, высокопроизводительные вычисления, параллельные вычисленияПредставьте себе фреймворк общего назначения для распределенного исполнения приложений со следующими статистическими показателями*:
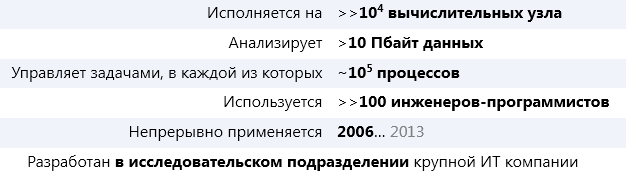
* Статистические данные за 2011 год.
А теперь представьте, что это не Hadoop.
О том, что это за фреймворк, о идеях и концепциях, заложенных в его основу и о том, почему этот фреймворк даже более инновационный (субъективно), чем Hadoop, речь пойдет ниже.
Читать полностью »
Решения Fujitsu для резервного копирования и архивирования
2013-05-29 в 7:53, admin, рубрики: big data, Fujitsu, Блог компании Fujitsu, Серверная оптимизация, метки: FujitsuВ настоящее время роль информационных технологий в бизнес-процессах современных предприятий невозможно переоценить. При этом, чем глубже происходит их интеграция, тем важнее становится стоимость обрабатываемых данных, тем дороже обходится их потеря. Таким образом, вопрос защиты данных, их архивирования и хранения уже сейчас волнует не только системных администраторов, но и руководителей предприятий и владельцев бизнеса.
Основные проблемы защиты данных
Современные реалии в случае возникновения какого-либо непредвиденного сбоя (аварии) требуют минимизации двух основных параметров: объема потерянных данных и времени восстановления. При этом объем потерянных данных фактически напрямую зависит от времени, прошедшего с момента сохранения последнего состояния системы до момента аварии. Тем самым, для минимизации данного параметра необходимо как можно чаще выполнять резервное копирование, в свою очередь увеличивая и без того растущий объем хранимых данных. Именно организация бэкапа, на текущий момент, становится основной задачей системного администратора. Читать полностью »
Эластичное избыточное S3-совместимое хранилище за 15 минут
2013-05-22 в 8:02, admin, рубрики: big data, ceph, guide, howto, tutorial, администрирование, Облачные вычисления, руководство, системное администрирование, метки: ceph, guide, howto, tutorial, администрирование, руководствоS3 сегодня не удивишь наверное никого. Его используют и как бэкенд хранилище под веб сервисы, и как хранилище файлов в медиа индустрии, так и как архив для бэкапов.
Рассмотрим небольшой пример развертывания S3-совместимого хранилища на основе объектного хранилища Ceph
Читать полностью »
Частота отправляемых рассылок: чаще не всегда лучше!
2013-05-20 в 4:08, admin, рубрики: big data, Блог компании Pechkin-mail.ru, переводы, статистический анализ, метки: big data, email маркетинг, статистический анализВ последнее время, я часто слышу мнения, что “Объем отправки писем это ключ к успеху в email-маркетинге!”. По своей сути, они означают, что отправка дополнительных email приводит к большей активности подписчиков, зарабатыванию большего числа денег, и, вообще, лучше (вне зависимости от того, что “лучше” значит для вас).
Их аргументы просты:
- Мои данные показывают, что чем больше получает/открывает/кликает мою рассылку, тем больше денег я зарабатываю.
- Так как я не могу волшебным образом “наколдовать” новые email-адреса, поэтому я должен чаще отправлять рассылки тем, кто уже есть.
Ведь если у вас есть адресная база в 10 000 адресов и каждый раз, когда вы отправляете по ним email, вы получите 100 заказов, то, отправив email на эти адреса два раза в месяц, а не один, вы ожидаете получить на 100 заказов больше, верно? Деньги у вас в кармане! Почему бы не пойти на это?
Безусловно, рассуждения верные. Но не все так просто.
Может быть, вы сможете увеличить частоту ваших рассылок для роста продаж, а может и не сможете. И вот почему: Активность подписчика (открытия, клики) зависит от частоты отправки рассылок. Чем больше вы отправляете, тем меньше подписчиков открывают ваши рассылки и кликают по ссылкам в них. А значит должна быть точка равновесия, в которой определенная частота рассылки максимизирует активность подписчика (а, следовательно, и ваши продажи).
Практика LSI
2013-05-14 в 11:19, admin, рубрики: big data, Flash-платформа, LSI, Nytro MegaRAID, seagate, ssd, высокая производительность, контроллер, производительность, метки: big data, LSI, Nytro MegaRAID, seagate, ssd, контроллер, производительностьДаже самые заядлые скептики уже признают, что технологии SSD обладают рядом неоспоримых преимуществ по сравнению с обычными жесткими дисками и позволяют получить значительно большую производительность операций ввода/вывода (а в некоторых случаях скорости I/O — много не бывает). Вместе с тем, SSD еще не готовы к повсеместному внедрению вместо традиционных жестких дисков по целому ряду причин: начиная с цены и заканчивая надежностью. Что же делать? На выручку приходят гибридные решения, которые сочетают традиционные диски с SSD, позволяя получить (пусть и с определенными оговорками) преимущества обоих решений.
Если не углубляться в детали, то сам принцип работы гибридных систем достаточно прост (а если углубиться — то можно настолько погрузиться, что и не вернешься за год) и одинаков для всех систем, начиная с дисков Seagate Momentus XT и Apple Fusion Drive, заканчивая дорогими и сложными решениями для больших систем хранения данных и дата-центров, о которых сегодня и пойдет речь.
Для основного хранения данных используются традиционные жесткие диски, по необходимости объединенные в RAID, а SSD используется для кэширования самых часто используемых данных, к которым надо обращаться чаще всего. Управление кэшированием системы берут на себя, и чаще всего кэш-раздел в системе вообще недоступен в виде отдельного диска.
В больших и «серьезных» системах вопросы оптимизации ввода/вывода стоят еще острее, чем для настольных компьютеров. То, что для пользователя является секундной задержкой в запуске тяжелой программы, в случае нагруженного сервера может вылиться во многие тысячи долларов убытков, если дисковая подсистема станет «бутылочным горлышком», замедляющим всю работу.
Говоря о больших системах хранения данных, нельзя не вспомнить про компанию LSI, которая, являясь одним из крупнейших поставщиков для систем хранения данных, не могла остаться в стороне. В портфеле продуктов LSI есть набор решений для ускорения работы дисковых систем, объединенных в семейство Nytro.
Читать полностью »