
В предыдущих материалах этого цикла мы рассматривали методы предварительной обработки данных при помощи СУБД. Это может быть полезно при очень больших объемах обрабатываемой информации. В этой статье я продолжу описывать инструменты для интеллектуальной обработки больших объёмов данных, остановившись на использовании Python и Theano.
Читать полностью »
Рубрика «big data» - 142
Data mining: Инструментарий — Theano
2013-05-07 в 18:56, admin, рубрики: big data, data mining, kaggle, python, метки: kaggle, pythonЦикл зрелости технологий на 2013 год по версии Gartner
2013-04-26 в 7:52, admin, рубрики: big data, gartner, wireless, аналитика, Беспроводные технологии, Исследования и прогнозы в IT, прогнозы, технологии, метки: big data, gartner, wireless, аналитика, прогнозы, технологииИсследовательская компания Gartner хорошо известна на рынке аналитики информационных технологий. Я бы даже сказал — является одним из лидеров этого рынка. Ежегодно она выкладывают крайне интересный график, именуемый «Цикл зрелости технологий» (в англ. Hype cycle, или дословно – «цикл шумихи»). На этом графике, в хронологическом порядке, разложены технологии, которые либо уже готовы к применению, либо только-только вступают в стадию исследований.
Вот так выглядит график на 2013 год:
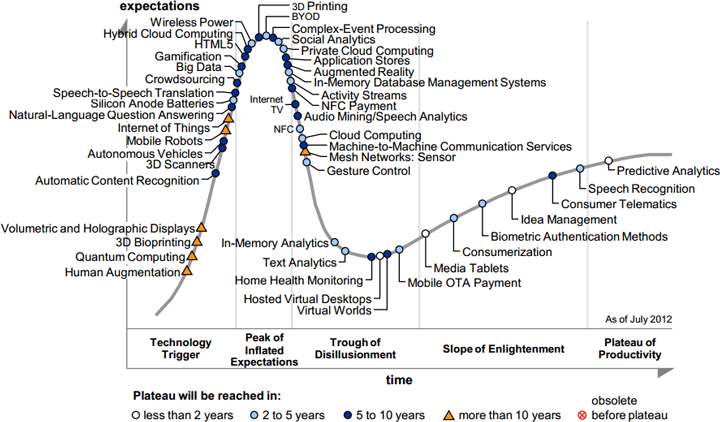
Итак, график делится на пять частей. Первая – «технологический триггер». Т.е. то время, когда технология только-то начинает свое существование (хотя бы в виде идеи). Этап второй – «пик завышенных ожиданий». Т.е. период времени, когда о технологии начинает узнавать общественность. На вершине этого пика о технологии говорят все и на каждом углу, и даже бульварная пресса начинает писать об этом как о почти свершившемся факте. Дальше следует «пропасть разочарования», т.е. то время, когда оказывается, что в реальности технология позволяет делать совсем не то, что он нее хотели. Из этой пропасти выбираются далеко не все. Ну и следом идет «склон просвещения» и «плато продуктивности», по сути – последние этапы перед массовым внедрением.Читать полностью »
Big Data Week в Москве. 25-27 апреля. Апдейт программы
2013-04-23 в 11:01, admin, рубрики: big data, map reduce, Блог компании «Афиша» и «Рамблер», конференции, метки: big data, map reduce, конференцииНу вот, программа московского Big Data Week полностью сформирована.
Напоминаем. В этом году Москва является участником Big Data Week — мирового фестиваля, посвященного теме обработки больших объемов данных. В Москве мероприятия будут проходить 3 дня — 25-27 апреля на Мансарде объединенной компании Афиши и Рамблера.

Программа:
Читать полностью »
ЦРУ — большие задачи и большие данные. На пути к созданию глобального информационного колпака
2013-04-22 в 8:01, admin, рубрики: big data, data mining, информационная безопасность, Новые технологии, социальные сети, ЦРУ 
Айра Гас Хант (Ira Gus Hunt), действующий Директор по технологиям ЦРУ, рассказывает о своем видении Big Data на службе ЦРУ, а также возникающие при этом задачи и методы их решения. Выступление состоялось на конференции GigaOM Structure:Data 2013, проходившей 20 марта в Нью-Йорке. Как говорят очевидцы это было одно из самых интересных и запоминающихся выступлений.
Читать полностью »
Failsafe resource allocator over DHT
2013-04-17 в 19:49, admin, рубрики: api, big data, concurrency, DHT, метки: concurrency, DHTУ нас есть некоторый диапазон чисел от 0 до N, надо написать две функции int alloc() и free(int). Первая выбирает один из свободных идентификаторов из диапазона [0, N), а вторая соответственно — «возвращает» его для повторного использования(полагаем, что число N достаточно мало, что бы идентификаторы могли закончится если их не возвращать, но больше чем число выделенных в каждый конкретный момент времени идентификаторов). При этом на «нижнем уровне» у нас есть только DHT. Нету блокировок, и, кроме того, от алгоритмов требуется отказоустойчивость — если какой-то из узлов кластера «сложится» во время выполнения алгоритма поведение системы должно быть предсказуемо. Если задача интересна, а также интересно узнать почему отказоустойчивый сервис с такой сигнатурой невозможно корректно использовать, и как надо исправить сигнатуру что бы это стало возможно — добро пожаловать под кат.
Стартует митап-группа «Moscow Cassandra Users»
2013-04-16 в 12:26, admin, рубрики: big data, cassandra, nosql, встречи, высокая производительность, события, метки: cassandra, встречи, событияДрузья,
рад сообщить, что в Москве при поддержке компании DataStax стартует группа, посвященная NoSQL-хранилищу Apache Cassandra.
Всего в рамках группы планируется проводить 6 встреч в году. Некоторые из них будут проходить с участием разработчиков и архитекторов DataStax, т.е. будет возможность задать свои вопросы и высказать наболевшее лично людям, которые активно развивают продукт.Читать полностью »
Завершилось соревнование по дата-майнингу Heritage Health Prize
2013-04-10 в 20:06, admin, рубрики: big data, data mining, машинное обучение, Спортивное программирование, метки: data mining, машинное обучение 
Крупнейшее со времен Netflix Prize соревнование в области анализа больших массивов данных подошло к концу. И хотя официальные результаты первой десятки и победитель будут объявлены через два месяца, итоги уже можно подводить.
Целью было спрогнозировать госпитализацию пациентов в течение будущего года на основании данных за предыдущие два года лечения. По замыслу спонсора это позволит больше внимания уделять именно тем пациентам, которые больше всего в нем нуждаются, за счет чего сэкономить часть из 30 млрд. $, ежегодно затрачиваемых в США на госпитализацию.
Заявленный организаторами приз в 3 000 000$ был недостижим из-за установленного предела точности в 0.4 RMSLE(меньше-лучше; лучший достигнутый результат 0.46; разница между первым и сотым местом 0.008; RMSLE — среднеквадратическое отклонение логарифма ошибки) и предоставленных данных — в них просто не содержалось достаточного для достижения такого уровня точности количества информации. Поэтому фактически борьба шла за 500 000$, достающиеся лучшей команде, фонд промежуточных финишей и бесценный опыт.
Читать полностью »
Big Data Week в Москве. 25-27 апреля
2013-04-09 в 17:11, admin, рубрики: big data, map reduce, Блог компании «Афиша» и «Рамблер», конференции, метки: big data, map reduce, конференцииКак-то не выдавался раньше случай рассказать тут про наш проект Мансарда (Facebook, ВКонтакте). И вот выдался.
В этом году Москва является участником Big Data Week — мирового фестиваля, посвященного теме обработки больших объемов данных. В Москве мероприятия будут проходить 3 дня — 25-27 апреля на Мансарде объединенной компании Афиши и Рамблера. Регистрироваться можно (и нужно!) уже сейчас.
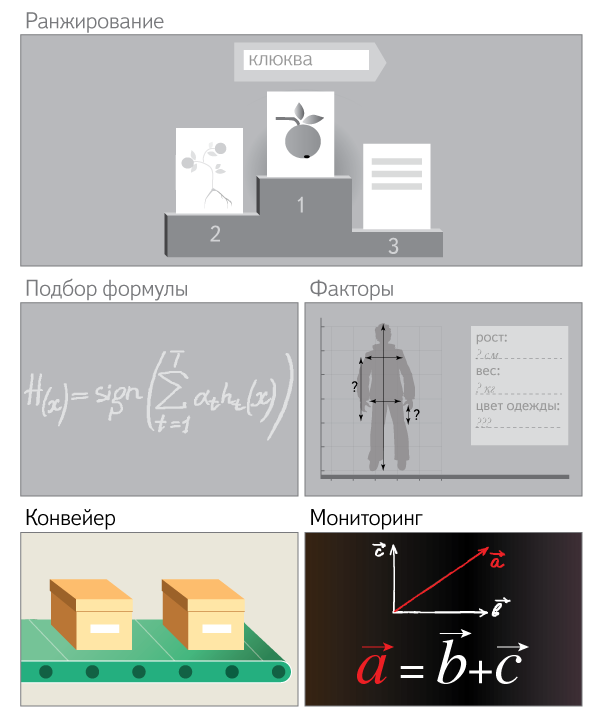
Ранжирование в Яндексе: как поставить машинное обучение на поток (пост #3)
2013-04-09 в 8:52, admin, рубрики: big data, data mining, FML, learning to rank, machine learning, Блог компании Яндекс, машинное обучение, обучение ранжированию, факторы ранжирования, метки: FML, learning to rank, machine learning, машинное обучение, обучение ранжированию, факторы ранжированияСегодня мы завершаем серию публикаций о фреймворке FML, в которых рассказываем о том, как и для чего автоматизировали в Яндексе применение технологий машинного обучения. В сегодняшнем посте мы расскажем:
- почему нужно следить за качеством факторов и как мы это делаем;
- как FML помогает в задачах распределённых вычислений над поисковым индексом;
- каким образом и для чего наши технологии машинного обучения уже применяются и могут быть применены как в Яндексе, так и вне его;
- какую литературу можно посоветовать для более глубокого погружения в затронутую проблематику.
Интерфейс SAS: история, примеры организации хранения
2013-04-03 в 12:01, admin, рубрики: big data, LSI, sas, высокая производительность, дата-центр, Железо, контроллер, цод, метки: LSI, sas, дата-центр, контроллер, цодВ прошлый раз мы с вами рассмотрели все, что касается технологии SCSI в историческом контексте: кем она была изобретена, как развивалась, какие у нее есть разновидности и так далее. Закончили мы на том, что наиболее современным и актуальным стандартом является Serial Attached SCSI, он появился относительно недавно, но получил быстрое развитие. Первую реализацию «в кремнии» показала компания LSI в январе 2004 года, а в ноябре того же года SAS вошел в топ самых популярных запросов сайта storagesearch.com/.
Начнем с основ. Как же работают устройства на технологи SCSI? В стандарте SCSI все построено на концепции клиент/сервер.
Клиент, называемый инициатором (англ. initiator), отправляет разные команды и дожидается их результатов. Чаще всего, разумеется, в роли клиента выступает SAS контроллер. Сегодня SAS контроллеры — это HBA и RAID-контроллеры, а также контроллеры СХД, стоящие внутри внешних систем хранения данных.
Сервер называется целевым устройством (англ. target), его задача — принять запрос инициатора, обработать его и вернуть данные или подтверждение выполнения команды обратно. В роли целевого устройства может выступать и отдельный диск, и целый дисковый массив. В этом случае SAS HBA внутри дискового массива (так называемая внешняя система хранения данных), предназначенный для подключения к нему серверов, работает в режиме Target. Каждому целевому устройству (“таргету”) присваивается отдельный идентификатор SCSI Target ID.
Для связи клиентов с сервером используется подсистема доставки данных (англ. Service Delivery Subsystem), в большинстве случаев, это хитрое название скрывает за собой просто кабели. Кабели бывают как для внешних подключений, так и для подключений внутри серверов. Кабели меняются от поколения к поколению SAS. На сегодня имеется три поколения SAS:
— SAS-1 или 3Gbit SAS
— SAS-2 или 6Gbit SAS
— SAS-3 или 12 Gbit SAS – готовится к выходу в середине 2013 года

