С начала работы над Fetchee у нас был план предложить решение для парсинга данных о товарах интернет-магазинов корпоративным клиентов и стартап-сообществу. Отзывы, которые мы собрали за время работы, говорили о его потенциальной востребованности и подвели к запуску нового продукта, который поможет разработчикам быстро создавать собственные приложения, на основе одной из главных функций Fetchee — сбора eCommerce данных и слежения за ценами в любых интернет-магазинах мира.
Читать полностью »
Рубрика «data mining» - 57
Product API от Fetchee: автоматический парсинг товаров интернет-магазинов
2016-11-11 в 7:56, admin, рубрики: api, data mining, json, Блог компании Fetchee, интернет-магазины, парсинг контента, слежение за ценамиРекомендации на основе изображений товаров
2016-11-09 в 7:01, admin, рубрики: big data, cnn, data mining, data science, machine learning, python, Алгоритмы, машинное обучение, распознавание изображений, рекомендательные системы
В данной статье я хотел бы рассмотреть на практике вариант построения простейшей рекомендательной системы основанной на схожести изображений товаров. Этот материал предназначен для тех, кто хотел бы попробовать применить Deep Learning, а именно свёрточные нейронные сети, в простом, интересном и практически применимом проекте, но не знает с чего начать.
Читать полностью »
Насколько важна математическая подготовка в перспективных направлениях разработки ПО
2016-11-05 в 15:46, admin, рубрики: data mining, искусственный интеллект, математика, математика для программистов, прикладная математика, Программирование, метки: математика для программистов
Профессия программиста становится все более массовой и востребованной. Сейчас порог вхождения в ИТ-сферу в принципе снизился, но продолжает расти интерес к ИТ-технологиям в целом, и к программированию в частности.
Среди ИТ-компаний и программистов, тем не менее, растет конкуренция. Однако стоит отметить, что, по крайней мере, на рынке труда она достаточно честная. Например, принимая на работу программиста работодатель в первую очередь будет оценивать уровень реальных знаний и навыков, а не цвет диплома. Впрочем, эта ситуация способствует распространению «программистов-самоучек», которые ограничены узкой специализацией. Для них нередко оказывается справедливо выражение «шаг вправо, шаг влево – расстрел». Так что, сейчас недостаточно сказать: этот человек – «ИТшник», или даже программист. Программист программисту рознь.
Специализации программистов множатся и развиваются, программист, специализирующийся в одной области приложений, не всегда может понять своего коллегу, работающего в другой области. Хотя вроде бы и языки программирования, и технологии одни и те же. Области приложений могут кардинально отличаться друг от друга, и для того, чтобы писать специализированные программы, мало знать языки и технологии программирования, нужно хорошо разбираться в той области, для которой разрабатывается программный продукт. В последнее время все чаще при изучении предметной области возникает необходимость в математической формализации. Читать полностью »
Статистика для математика
2016-10-31 в 12:41, admin, рубрики: CAU, data mining, лекции, математика, математическая статистика, машинное обучение, теория вероятностей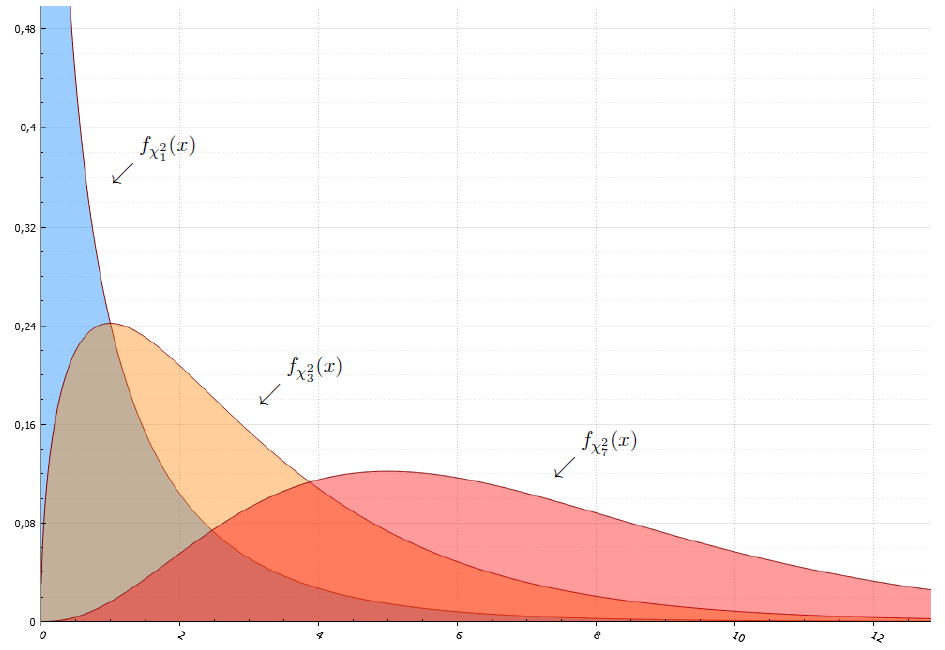
В современных условиях интерес к анализу данных постоянно и интенсивно растет в совершенно различных областях, таких как биология, лингвистика, экономика, и, разумеется, IT. Основу этого анализа составляют статистические методы, и разбираться в них необходимо каждому уважающему себя специалисту в data mining.
К сожалению, действительно хорошая литература, такая что умела бы предоставить одновременно математически строгие доказательства и понятные интуитивные объяснения, встречается не очень часто. И данные лекции, на мой взгляд, необычайно хороши для математиков, разбирающихся в теории вероятностей именно по этой причине. По ним преподают магистрам в немецком университете имени Кристиана-Альбрехта на программах «Математика» и «Финансовая математика». И для тех, кому интересно, как этот предмет преподается за рубежом, я эти лекции перевел. На перевод у меня ушло несколько месяцев, я разбавил лекции иллюстрациями, упражнениями и сносками на некоторые теоремы. Замечу, что я не профессиональный переводчик, а просто альтруист и любитель в этой сфере, так что приму любую критику, если она конструктивна.
Вкратце, лекции вот о чем:
Читать полностью »
Automatic Relevance Determination или машинное обучение когда данных очень мало
2016-10-26 в 6:59, admin, рубрики: bayes, bayesian inference, data mining, feature selection, linear model, linear regression, python, scikit-learn, линейная регрессия, математика, машинное обучениеКогда речь заходит про машинное обучение, обычно подразумевают большие объемы данных — миллионы или даже миллиарды транзакций, из которых надо сделать сложный вывод о поведении, интересах или текущем cостоянии пользователя, покупателя или какого-нибудь аппарата (робота, автомобиля, дрона или станка).
Однако в жизни обычного аналитика самой обычной компании много данных встречается нечасто. Скорее даже наоборот — у вас будет мало или очень мало данных — буквально десятки или сотни записей. Но анализ все же нужно провести. Причем не какой попало анализ, а качественный и достоверный.
Зачастую ситуация усугубляется еще и тем, что вы без труда можете нагенерить для каждой записи много признаков (чаще всего добавляют полиномы, разницу с предыдущим значением и значением за прошлый год, one-hot-encoding для категориальных признаков и т.п.). Вот только совсем нелегко разобраться, какие из них действительно полезны, а какие только усложняют модель и увеличивают ошибки вашего прозноза.
Для этого вы можете воспользоваться методами байесовой статистики, например, Automatic Relevance Determination. Читать полностью »
Интервью с вице-президентом по технологической стратегии компании MapR
2016-10-23 в 20:49, admin, рубрики: big data, data mining, mapr, Анализ и проектирование системПриветствую! Я немного помогал своим друзьям готовить конференцию CEE-SECR 2016 и в процессе познакомился с Кристал Валентайн – вице-президентом компании MapR по технологической стратегии. Кристал большая молодец, очень собранная, целеустремленная, глубоко понимающая свою отрасль При своей исключительной занятости умеет очень комфортно сотрудничать. Да и компания её не из последних. Думаю, её доклад в Москве будет очень интересным, а мне захотелось узнать больше про взгляды на будущее отрасли вице президента по технологической стратегии и я придумал сделать с Кристал интервью. Вот что у меня получилось. Кристал весьма любезно ответила на все вопросы, которые я ей задал. В целом же ответы Кристал отличает плотность предоставляемой информации на строку текста, четкость формулировок, умение оставаться в желаемых границах и предельно ясное видение миссии компании и будущего рынка.
Читать полностью »
Выборы-2016. Часть 2 — удивительное рядом и оно разрешено
2016-10-23 в 20:49, admin, рубрики: data mining, ggplot2, R, визуализация данных, выборы-2016, открытые данные, ЦИК РФ, метки: выборы-2016, ЦИК РФВ первой части статьи о выборах 2016 года шла речь о результатах в 225 избирательных округах. В этот раз рассмотрим данные о результатах голосования по участковым избирательным комиссиям (УИК), которых насчитывалось чуть менее 100 тысяч. Этот уровень детализации позволяет увидеть неожиданные явления и удивительные закономерности в результатах голосования.

Выборы-2016. Часть 1 — результаты и сравнения
2016-10-23 в 20:45, admin, рубрики: data mining, GIS-Lab, Leaflet, R, визуализация данных, выборы-2016, открытые данные, ЦИК РФВ сентябре прошли выборы в Госдуму РФ VII созыва. При голосовании вся территория России была разделена на 225 округов. В каких округах каждая из партий получила высокие (или низкие) результаты? Какие значения принимала явка избирателей и как она влияла на результаты партий? Ответы на эти вопросы и ряд других наблюдений представлены в этой публикации.
Кластеризация с пакетом ClusterR, часть 2
2016-10-23 в 16:44, admin, рубрики: clustering, data mining, k-means, k-medoids, R, кластеризация, машинное обучениеЭта статья посвящена кластеризации, а точнее, моему недавно добавленному в CRAN пакету ClusterR. Детали и примеры ниже в большинстве своем основаны на пакете Vignette.
Кластерный анализ или кластеризация — задача группирования набора объектов таким образом, чтобы объекты внутри одной группы (называемой кластером) были более похожи (в том или ином смысле) друг на друга, чем на объекты в других группах (кластерах). Это одна из главных задач исследовательского анализа данных и стандартная техника статистического анализа, применяемая в разных сферах, в т.ч. машинном обучении, распознавании образов, анализе изображений, поиске информации, биоинформатике, сжатии данных, компьютерной графике.
Наиболее известные примеры алгоритмов кластеризации — кластеризация на основе связности (иерархическая кластеризация), кластеризация на основе центров (метод k-средних, метод k-медоидов), кластеризация на основе распределений (GMM — Gaussian mixture models — Гауссова смесь распределений) и кластеризация на основе плотности (DBSCAN — Density-based spatial clustering of applications with noise — пространственная кластеризация приложений с шумом на основе плотности, OPTICS — Ordering points to identify the clustering structure — упорядочивание точек для определения структуры кластеризации, и др.).
В первой части: гауссова смесь распределений (GMM), метод k-средних, метод k-средних в мини-группах.
Читать полностью »
Как программист машину покупал. Часть II
2016-10-17 в 1:45, admin, рубрики: data mining, predictive analytics, R, R-project, random forest, xgboost, Алгоритмы, машинное обучение, покупка автомобиля, Программирование, продажа автоВ предыдущей статье на примере покупки Mercedes-Benz E-klasse не старше 2010 года выпуска стоимостью до 1.5 млн рублей в Москве была рассмотрена задача поиска выгодных автомобилей. Под выгодными следует понимать предложения, цена которых ниже рыночной в текущий момент среди объявлений, собранных со всех наиболее авторитетных сайтов по продаже б/у автомобилей в РФ.
На первом этапе в качестве метода машинного обучения была выбрана множественная линейная регрессия, были рассмотрены правомерность ее использования, а также плюсы и минусы. Простая линейная регрессия была выбрана в качестве ознакомительного алгоритма. Очевидно, что существует еще много методов машинного обучения для решения поставленной задачи регрессии. В этой статье я хотел бы рассказать вам, как именно я выбирал наиболее оптимальный алгоритм машинного обучения для исследуемой модели, который в настоящее время используется в реализованном мною сервисе — robasta.ru.