Рубрика «k-means»

Я решил проверить, как далеко можно зайти, если обучать скрытый слой нейросети вообще без обратного распространения ошибки. Только локальными правилами: каждый нейрон видит свой вход, свою активность и что делают соседи, и все. Никакого глобального сигнала ошибки и никаких меток.

Спойлер: в моей постановке такое обучение в итоге свелось к обычному k‑means. Оно обгоняет k‑means с той же архитектурой максимум на полпроцента и ни в чем не обгоняет backprop: ни по точности, ни при малом числе меток, ни по забыванию.

Читать полностью »

Представим, что kNN отнес новую точку к некоторому классу. Пусть для простоты это будет 1-NN, в котором решение базируется на одном ближайшем соседе. Возьмем точку q=(0.1; 0) и двух кандидатов: Читать полностью »

Машинное обучение: Кластеризация методом K-means. Теория и реализация. С нуля - 1

Здравствуйте, дорогие читатели. В этой статье я приведу разбор того, как работает метод кластеризации К-средних на низком уровне.

Содержание: идея метода, как присваивать метки неразмеченным объектам, реализация на чистом Python и разбор кода.

Введение

Читать полностью »

Визуализация и анализ данных в настоящее время широко применяется в телекоммуникационной отрасли. В частности, анализ в значительной степени зависит от использования геопространственных данных. Возможно, это связано с тем, что телекоммуникационные сети сами по себе географически разбросаны. Соответственно, анализ таких дисперсий может дать огромную ценность.
Читать полностью »

Доброго времени суток!

В свое время, будучи студентом младших курсов, я начал заниматься научно-исследовательской работой в области теории оптимизации и синтеза оптимальных нелинейных динамических систем. Примерно в то же время появилось желание популяризировать данную область, делиться своими наработками и мыслями с людьми. Подтверждением этому служит пара-тройка моих детских незрелых статей на Хабре. Тем не менее, на тот момент эта идея оказалась для меня непосильной. Возможно ввиду моей занятости, неопытности, неумения работать с критикой и советами или чего-то еще. Можно до бесконечности пытаться найти причину, но ситуацию это не изменит: я забросил эту идею на полку, где она благополучно лежала и пылилась до этого момента.

Закончив специалитет и готовясь к защите кандидатской диссертации, я задался вполне логичным вопросом: «а что же дальше?» Имея за плечами опыт как обычной работы, так и исследовательской, я вновь вернулся к той самой идее, которая, казалось бы, должна была утонуть под толщей пыли. Но вернулся я к этой идее в более осознанной форме.

Я решил заняться разработкой программного обеспечения, связанного с той отраслью, которой занимаюсь уже на протяжении 8 лет, и моими личными академическими пристрастиями, которые включают в себя методы оптимизации и машинное обучение.
Прикладное применение задачи нелинейного программирования - 1

Ну что ж, всем заинтересовавшимся:
Читать полностью »

Привет всем! Приглашаем изучить седьмую тему нашего открытого курса машинного обучения!

Открытый курс машинного обучения. Тема 7. Обучение без учителя: PCA и кластеризация - 1 Данное занятие мы посвятим методам обучения без учителя (unsupervised learning), в частности методу главных компонент (PCA — principal component analysis) и кластеризации. Вы узнаете, зачем снижать размерность в данных, как это делать и какие есть способы группирования схожих наблюдений в данных.Читать полностью »

Эта статья посвящена кластеризации, а точнее, моему недавно добавленному в CRAN пакету ClusterR. Детали и примеры ниже в большинстве своем основаны на пакете Vignette.

Кластерный анализ или кластеризация — задача группирования набора объектов таким образом, чтобы объекты внутри одной группы (называемой кластером) были более похожи (в том или ином смысле) друг на друга, чем на объекты в других группах (кластерах). Это одна из главных задач исследовательского анализа данных и стандартная техника статистического анализа, применяемая в разных сферах, в т.ч. машинном обучении, распознавании образов, анализе изображений, поиске информации, биоинформатике, сжатии данных, компьютерной графике.

Наиболее известные примеры алгоритмов кластеризации — кластеризация на основе связности (иерархическая кластеризация), кластеризация на основе центров (метод k-средних, метод k-медоидов), кластеризация на основе распределений (GMM — Gaussian mixture models — Гауссова смесь распределений) и кластеризация на основе плотности (DBSCAN — Density-based spatial clustering of applications with noise — пространственная кластеризация приложений с шумом на основе плотности, OPTICS — Ordering points to identify the clustering structure — упорядочивание точек для определения структуры кластеризации, и др.).

В первой части: гауссова смесь распределений (GMM), метод k-средних, метод k-средних в мини-группах.
Читать полностью »

Эта статья посвящена кластеризации, а точнее, моему недавно добавленному в CRAN пакету ClusterR. Детали и примеры ниже в большинстве своем основаны на пакете Vignette.

Кластерный анализ или кластеризация — задача группирования набора объектов таким образом, чтобы объекты внутри одной группы (называемой кластером) были более похожи (в том или ином смысле) друг на друга, чем на объекты в других группах (кластерах). Это одна из главных задач исследовательского анализа данных и стандартная техника статистического анализа, применяемая в разных сферах, в т.ч. машинном обучении, распознавании образов, анализе изображений, поиске информации, биоинформатике, сжатии данных, компьютерной графике.

Наиболее известные примеры алгоритмов кластеризации — кластеризация на основе связности (иерархическая кластеризация), кластеризация на основе центров (метод k-средних, метод k-медоидов), кластеризация на основе распределений (GMM — Gaussian mixture models — Гауссова смесь распределений) и кластеризация на основе плотности (DBSCAN — Density-based spatial clustering of applications with noise — пространственная кластеризация приложений с шумом на основе плотности, OPTICS — Ordering points to identify the clustering structure — упорядочивание точек для определения структуры кластеризации, и др.).
Читать полностью »

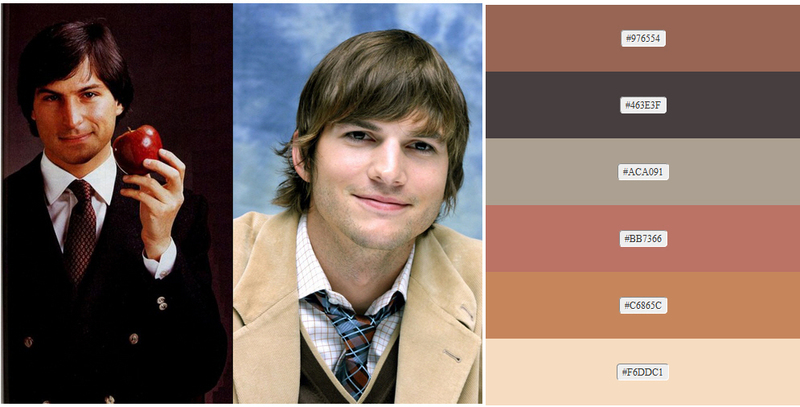
Определение доминирующих цветов: Python и метод k средних
©Assorium

На Хабре публиковалось несколько статей с алгоритмами и скриптами для выбора доминирующих цветов на изображении: 1, 2, 3. В комментариях к тем статьям можно найти ссылки ещё на десяток подобных программ и сервисов. Но нет предела совершенству — и почему бы не рассмотреть способ, который кажется самым оптимальным? Речь идёт об использовании кластеризации методом k-средних (k-means).
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js