
В PostgreSQL существует очень удобный механизм рекомендательных блокировок, они же — advisory locks. Мы в «Тензоре» используем их во многих местах системы, но мало кто детально понимает, как конкретно они работают, и какие проблемы можно получить при неправильном обращении.
Рубрика «dba» - 2
Фантастические advisory locks, и где они обитают
2020-02-13 в 11:20, admin, рубрики: advisory lock, dba, postgresql, sql, Администрирование баз данных, Алгоритмы, базы данных, Блог компании Тензор, параллельные вычисления
Массовая оптимизация запросов PostgreSQL. Кирилл Боровиков (Тензор)
2020-02-11 в 6:45, admin, рубрики: auto_explain, dba, explain, explain.tensor.ru, node.js, postgresql, Администрирование баз данных, базы данных, Блог компании Тензор, высокая производительностьВ докладе представлены некоторые подходы, которые позволяют следить за производительностью SQL-запросов, когда их миллионы в сутки, а контролируемых серверов PostgreSQL — сотни.
Какие технические решения позволяют нам эффективно обрабатывать такой объем информации, и как это облегчает жизнь обычного разработчика.
Кому интересен разбор конкретных проблем и разные техники оптимизаций SQL-запросов и решения типовых DBA-задач в PostgreSQL — можно также ознакомиться с серией статей на эту тему.
Читать полностью »
SQL HowTo: пишем while-цикл прямо в запросе, или «Элементарная трехходовка»
2020-01-31 в 9:56, admin, рубрики: array, dba, explain, explain.tensor.ru, postgresql, sql, sql tips and tricks, unnest, Администрирование баз данных, Алгоритмы, базы данных, ненормальное программирование, рекурсияПериодически возникает задача поиска связанных данных по набору ключей, пока не наберем нужное суммарное количество записей.
Наиболее «жизненный» пример — вывести 20 самых старых задач, числящихся на списке сотрудников (например, в рамках одного подразделения). Для различных управленческих «дашбордов» с краткими выжимками по участкам работы похожая тема требуется достаточно часто.
В статье рассмотрим реализацию на PostgreSQL «наивного» варианта решения такой задачи, «поумнее» и совсем сложный алгоритм «цикла» на SQL с условием выхода от найденных данных, который может быть полезен как для общего развития, так и для применения в других похожих случаях.
Читать полностью »
PostgreSQL Antipatterns: редкая запись долетит до середины JOIN
2020-01-20 в 12:11, admin, рубрики: case, dba, explain, explain.tensor.ru, lateral, lazy sql, postgresql, sql, sql antipatterns, sql tips and tricks, Администрирование баз данных, Алгоритмы, базы данных, высокая производительностьЕсли писать SQL-запросы без анализа алгоритма, который они должны реализовать, ни к чему хорошему с точки зрения производительности это обычно не приводит.
Такие запросы любят «кушать» процессорное время и активно почитывать данные практически на ровном месте. Причем, это вовсе не обязательно какие-то сложные запросы, наоборот — чем проще он написан, тем больше шансов получить проблемы. А уж если в дело вступает оператор JOIN…
Само по себе соединение таблиц не вредно и не полезно — это просто инструмент, но и пользоваться им надо уметь.
Читать полностью »
Рисуем морозные узоры на SQL
2019-12-30 в 8:43, admin, рубрики: dba, postgresql, sql, sql tips and tricks, Алгоритмы, базы данных, визуализация данных, математика, ненормальное программирование, рекурсия
Немного SQL-магии под катом: математика, рекурсия, псевдографика.
Вспоминаем под Новый год формулу угла между векторами:
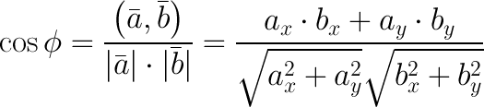
Читать полностью »
Когда пасует VACUUM — чистим таблицу вручную
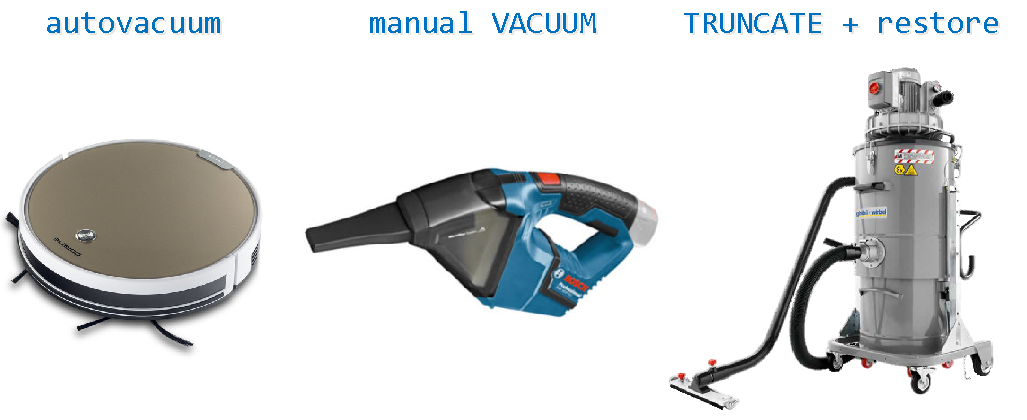
2019-12-25 в 17:15, admin, рубрики: dba, explain, postgresql, sql, sql tips and tricks, truncate, vacuum, Администрирование баз данных, Алгоритмы, базы данных, высокая производительностьVACUUM может «зачистить» из таблицы в PostgreSQL только то, что никто не может увидеть — то есть нет ни одного активного запроса, стартовавшего раньше, чем эти записи были изменены.
А если такой неприятный тип (продолжительная OLAP-нагрузка на OLTP-базе) все же есть? Как почистить активно меняющуюся таблицу в окружении длинных запросов и не наступить на грабли?
Вычищаем клон-записи из таблицы без PK
2019-12-20 в 14:57, admin, рубрики: dba, explain, explain.tensor.ru, postgresql, sql, sql antipatterns, sql tips and tricks, Администрирование баз данных, базы данных, чистка дублейСлучаются ситуации, когда в таблицу без первичного ключа или какого-то другого уникального индекса по недосмотру попадают полные клоны уже существующих записей.
Например, пишутся в PostgreSQL COPY-потоком значения хронологической метрики, а потом внезапный сбой, и часть полностью идентичных данных приходит повторно.
Как избавить базу от ненужных клонов?
Читать полностью »
PostgreSQL Antipatterns: передача наборов и выборок в SQL
2019-12-19 в 12:33, admin, рубрики: Any, dba, explain, explain.tensor.ru, postgresql, sql, sql antipatterns, unnest, Администрирование баз данных, базы данных, параметрыПериодически у разработчика возникает необходимость передать в запрос набор параметров или даже целую выборку «на вход». Иногда попадаются очень странные решения этой задачи.
Пойдем «от обратного» и посмотрим, как делать не стоит, почему, и как можно сделать лучше.
Читать полностью »
PostgreSQL Antipatterns: вредные JOIN и OR
2019-12-10 в 9:00, admin, рубрики: dba, explain, explain.tensor.ru, lazy sql, postgresql, sql, sql antipatterns, Администрирование баз данных, базы данных, визуализация данных, ленивые вычисленияБойтесь операций, buffers приносящих…
На примере небольшого запроса рассмотрим некоторые универсальные подходы к оптимизации запросов на PostgreSQL. Пользоваться ими или нет — выбирать вам, но знать о них стоит.
Читать полностью »
О чем молчит EXPLAIN, и как его разговорить
2019-11-26 в 18:21, admin, рубрики: dba, explain, explain.tensor.ru, postgresql, Администрирование баз данных, базы данных, визуализация данныхКлассический вопрос, с которым разработчик приходит к своему DBA или владелец бизнеса — к консультанту по PostgreSQL, почти всегда звучит одинаково: «Почему запросы выполняются на базе так долго?»
Традиционный набор причин:
- неэффективный алгоритм
когда вы решили сделать JOIN нескольких CTE по паре десятков тысяч записей - неактуальная статистика
если фактическое распределение данных в таблице уже сильно отличается от собранной ANALYZE'ом в последний раз - «затык» по ресурсам
и уже не хватает выделенных вычислительных мощностей CPU, постоянно прокачиваются гигабайты памяти или диск не успевает за всеми «хотелками» БД - блокировки от конкурирующих процессов
И если блокировки достаточно сложны в поимке и анализе, то для всего остального нам достаточно плана запроса, который можно получить с помощью оператора EXPLAIN (лучше, конечно, сразу EXPLAIN (ANALYZE, BUFFERS) ...) или модуля auto_explain.
Но, как сказано в той же документации,
«Понимание плана — это искусство, и чтобы овладеть им, нужен определённый опыт, …»
Но можно обойтись и без него, если воспользоваться подходящим инструментом!
Читать полностью »