
Это вторая часть разбора ошибок конфигурации MS SQL Server под 1С. Первая часть — про планирование и развёртывание: профили нагрузки, дисковая подсистема, баланс ресурсов, инсталляция и виртуализация, здесь первая часть. Там же была описана типичная история дефолтного развёртывания сервера на прод или «как не надо».
Рубрика «dba»
Настройка MS SQL Server под 1С: планирование и развёртывание (Часть вторая)
2026-09-10 в 16:57, admin, рубрики: 1С, dba, mssql, sql server, tempdb, VMware, виртуализация, дисковая подсистема, настройка sql server, производительностьDWH в 2026: четыре зоны вместо Inmon, Kimball и Data Vault 2.0
2026-05-14 в 10:56, admin, рубрики: apache iceberg, clickhouse, data engineering, data vault, data warehouse, dba, dwh, lakehouse, trino, архитектура данныхКогда инженер слышит «нам нужно хранилище данных», задача редко звучит однозначно. Кто‑то задыхается на боевой OLTP‑базе под аналитической нагрузкой. Кто‑то впервые строит BI и не понимает, с какого края подходить. У кого‑то накопились данные из десятка систем‑источников, и существующих средств уже не хватает.
У всех «хранилище». А правильный технический ответ зависит от условий задачи.
Хеш-индексы в PostgreSQL: быстрый поиск или скрытые проблемы?
2025-02-13 в 9:15, admin, рубрики: B-Tree vs Hash, dba, hash, sql, базы_данных, индексы, оптимизация запросов, производительность, разработкаИндексы — важнейший инструмент оптимизации запросов в базах данных. В PostgreSQL одним из вариантов является хеш-индекс. В отличие от B-tree, он работает исключительно с операциями равенства (=) и использует бакеты для хранения ссылок на строки таблицы. Давайте разберёмся, как PostgreSQL управляет этими бакетами, какие особенности у хеш-индекса и в каких случаях его применение оправдано.
Что такое бакеты в хеш-индексе PostgreSQL?
При создании хеш-индекса PostgreSQL применяет хеш-функцию к каждому значению индексируемого столбца. Результат хеширования определяет, в какой бакет (bucket) попадёт запись.
Карманный справочник: сравнение синтаксиса MS SQL Server и PostgreSQL
2022-01-21 в 7:00, admin, рубрики: dba, Microsoft SQL Server, MS Sql Server, mssql, plpgsql, postgresql, sql, tsql, базы данных, Блог компании Ozon Tech, Программирование, СУБД
Приветствую, уважаемые читатели!
Я занимаюсь переводом кода из MS SQL Server в PostgreSQL с начала 2019 года и сегодня продолжу сравнение этих СУБД.
В прошлой публикации мы рассматривали отличия в быстродействии MS SQL Server и PostgreSQL для «1C».
PostgreSQL Antipatterns: вычисление условий в SQL
2020-03-31 в 6:45, admin, рубрики: dba, postgresql, sql, sql antipatterns, sql tips and tricks, Администрирование баз данных, базы данных, Блог компании ТензорSQL — это не C++, и не JavaScript. Поэтому вычисление логических выражений происходит иначе, и вот это — совсем не одно и то же:
WHERE fncondX() AND fncondY()
= fncondX() && fncondY()
В процессе оптимизации плана исполнения запроса PostgreSQL может произвольным образом «переставлять» эквивалентные условия, не вычислять какие-то из них для отдельных записей, относить к условию применяемого индекса… Короче, проще всего считать, что вы заранее не можете управлять тем, в каком порядке будут (и будут ли вообще) вычисляться равноправные условия.
Поэтому если управлять приоритетом все-таки хочется, надо структурно сделать эти условия неравными с помощью условных выражений и операторов.
Данные и работа с ними — основа нашего комплекса СБИС, поэтому нам очень важно, чтобы операции над ними выполнялись не только корректно, но и эффективно. Давайте посмотрим на конкретных примерах, где могут быть допущены ошибки вычисления выражений, а где стоит улучшить их эффективность.
Читать полностью »
Рецепты для хворающих SQL-запросов
2020-03-26 в 7:20, admin, рубрики: dba, explain, explain.tensor.ru, postgresql, sql, sql tips and tricks, Администрирование баз данных, базы данных, Блог компании Тензор, визуализация данныхНесколько месяцев назад мы анонсировали explain.tensor.ru — публичный сервис для разбора и визуализации планов запросов к PostgreSQL.
За прошедшее время вы уже воспользовались им более 6000 раз, но одна из удобных функций могла остаться незамеченной — это структурные подсказки, которые выглядят примерно так:
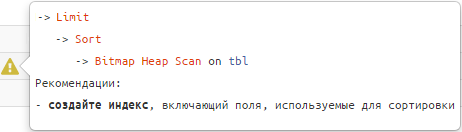
Прислушивайтесь к ним, и ваши запросы «станут гладкими и шелковистыми». :)
А если серьезно, то многие ситуации, которые делают запрос медленным и «прожорливым» по ресурсам, типичны и могут быть распознаны по структуре и данным плана.
В этом случае каждому отдельному разработчику не придется искать вариант оптимизации самостоятельно, опираясь исключительно на свой опыт — мы можем ему подсказать, что тут происходит, в чем может быть причина, и как можно подойти к решению. Что мы и сделали.
Давайте чуть подробнее рассмотрим эти кейсы — как они определяются и к каким рекомендациям приводят.
Читать полностью »
PostgreSQL Antipatterns: сражаемся с ордами «мертвецов»
2020-03-12 в 16:01, admin, рубрики: dba, IS DISTINCT FROM, postgresql, sql, sql antipatterns, sql tips and tricks, update, Администрирование баз данных, базы данных, Блог компании Тензор, ПрограммированиеОсобенности работы внутренних механизмов PostgreSQL позволяют ему быть очень быстрым в одних ситуация и «не очень» в других. Сегодня остановимся на классическом примере конфликта между тем, как работает СУБД и тем, что делает с ней разработчик — UPDATE vs принципы MVCC.
Кратко сюжет из отличной статьи:
Когда строка изменяется командой UPDATE, фактически выполняются две операции: DELETE и INSERT. В текущей версии строки устанавливается xmax, равный номеру транзакции, выполнившей UPDATE. Затем создается новая версия той же строки; значение xmin у нее совпадает с значением xmax предыдущей версии.
Через какое-то время после завершения этой транзакции старая или новая версии, в зависимости от COMMIT/ROOLBACK, будут признаны «мертвыми» (dead tuples) при проходе VACUUM по таблице и зачищены.
Но это произойдет далеко не сразу, а вот проблемы с «мертвецами» можно нажить очень быстро — при многократном или массовом обновлении записей в большой таблице, а чуть позже столкнуться с ситуацией, что и VACUUM не сможет помочь.
Читать полностью »
PostgreSQL Antipatterns: сказ об итеративной доработке поиска по названию, или «Оптимизация туда и обратно»
2020-03-10 в 5:50, admin, рубрики: dba, distinct, explain, explain.tensor.ru, GIN, pg_trgm, postgresql, sql, sql antipatterns, sql tips and tricks, union, Администрирование баз данных, базы данных, Блог компании Тензор, высокая производительность, поиск по названиюТысячи менеджеров из офисов продаж по всей стране фиксируют в нашей CRM-системе ежедневно десятки тысяч контактов — фактов общения с потенциальными или уже работающими с нами клиентами. А для этого клиента надо сначала найти, и желательно очень быстро. И происходит это чаще всего по названию.
Поэтому неудивительно, что, разбирая в очередной раз «тяжелые» запросы на одной из самых нагруженных баз — нашего собственного корпоративного аккаунта СБИС, я обнаружил «в топе» запрос для «быстрого» поиска по названию для карточек организаций.
Причем дальнейшее расследование выявило интересный пример сначала оптимизации, а затем деградации производительности запроса при последовательной его доработке силами нескольких команд, каждая из которых действовала исключительно из лучших побуждений.
0: чего же хотел пользователь
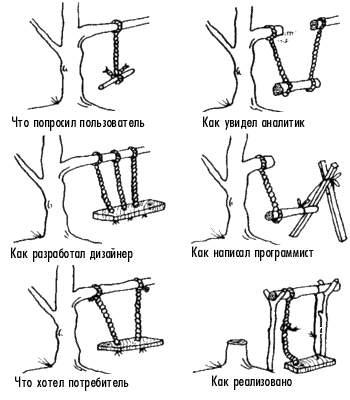
[КДПВ отсюда]
Что вообще обычно подразумевает пользователь, когда говорит про «быстрый» поиск по названию? Почти никогда это не оказывается «честный» поиск по подстроке типа ... LIKE '%роза%' — ведь тогда в результат попадают не только 'Розалия' и 'Магазин Роза', но и 'Гроза' и даже 'Дом Деда Мороза'.
Пользователь же подразумевает на бытовом уровне, что вы ему обеспечите поиск по началу слова в названии и покажете более релевантным то, что начинается на введенное. И сделаете это практически мгновенно — при подстрочном вводе.
Читать полностью »
PostgreSQL Antipatterns: меняем данные в обход триггера
2020-03-02 в 5:50, admin, рубрики: dba, postgresql, sql, sql antipatterns, sql tips and tricks, update, Администрирование баз данных, базы данных, Блог компании ТензорРано или поздно многие сталкиваются с необходимостью что-то массово исправить в записях таблицы. Я уже рассказывал, как это делать лучше, а как — лучше не делать. Сегодня расскажу о втором аспекте массового обновления — о сработке триггеров.
Например, на таблице, в которой вам надо что-то поправить, висит злобный триггер ON UPDATE, переносящий все изменения в какие-нибудь агрегаты. А вам надо все пообновлять (новое поле проинициализировать, например) так аккуратно, чтобы эти агрегаты не затронулись.
Давайте просто отключим триггеры!
BEGIN;
  ALTER TABLE ... DISABLE TRIGGER ...;
  UPDATE ...; -- тут долго-долго
  ALTER TABLE ... ENABLE TRIGGER ...;
COMMIT;
Собственно, тут и все — все уже висит.
Потому что ALTER TABLE накладывает AccessExclusive-блокировку, под которой никто параллельно выполняющийся, даже простой SELECT, ничего из таблицы прочитать не сможет. То есть пока эта транзакция не закончится, все желающие даже «просто почитать» будут ждать. А мы помним, что UPDATE у нас до-о-олгий…
Читать полностью »
DBA: Находим бесполезные индексы
2020-02-19 в 6:45, admin, рубрики: btree, dba, postgresql, sql, Администрирование баз данных, базы данных, Блог компании Тензор, высокая производительность, индексыРегулярно сталкиваюсь с ситуацией, когда многие разработчики искренне полагают, что индекс в PostgreSQL — это такой швейцарский нож, который универсально помогает с любой проблемой производительности запроса. Достаточно добавить какой-нибудь новый индекс на таблицу или включить поле куда-нибудь в уже существующий, а дальше (магия-магия!) все запросы будут эффективно таким индексом пользоваться.

Во-первых, конечно, или не будут, или не эффективно, или не все. Во-вторых, лишние индексы только добавят проблем с производительностью при записи.
Чаще всего такие ситуации происходят при «долгоиграющей» разработке, когда делается не заказной продукт по модели «написал разово, отдал, забыл», а, как в нашем случае, создается сервис с длинным жизненным циклом.
Доработки происходят итеративно силами множества распределенных команд, которые бывают разнесены не только в пространстве, но и во времени. И тогда, не зная всей истории развития проекта или особенностей прикладного распределения данных в его БД, можно легко «напортачить» с индексами. Но соображения и проверочные запросы под катом позволяют заранее предсказывать и обнаруживать часть проблем:
- неиспользуемые индексы
- префиксные «клоны»
- timestamp «в середине»
- индексируемый boolean
- массивы в индексе
- NULL-мусор