Рубрика «параллельное программирование» - 16

imageПоэзия — та же добыча радия.
В грамм добыча, в годы труды.
Изводишь единого слова ради
Тысячи тонн словесной руды.
Но как испепеляюще слов этих жжение
Рядом с тлением слова-сырца.
Эти слова приводят в движение
Тысячи лет миллионов сердца.

Владимир Маяковский

Напомню, что наша ближайшая задача — показать алгоритм универсального обобщения. Такое обобщение должно удовлетворять всем требованиям, сформулированным ранее в десятой части. Кроме того, оно должно быть свободно от традиционных для многих методов машинного обучения недостатков (комбинаторный взрыв, переобучение, схождение к локальному минимуму, дилемма стабильности-пластичности и тому подобное). При этом механизм такого обобщения должен не противоречить нашим знаниям о работе реальных нейронов живого мозга.

Сделаем еще один шаг в сторону универсального обобщения. Опишем идею комбинаторного пространства и то, как это пространство помогает искать закономерности и тем самым решать задачу обучения с учителем.
Читать полностью »

В одном из прежних постов я рассказывал, как реализовать «простейшую в мире lock-free хеш-таблицу» на C++. Она была настолько проста, что было невозможно удалять из нее записи или менять ее размерность. С тех пор прошло несколько лет, и не так давно я написал несколько многопоточных ассоциативных массивов без таких ограничений. Их можно найти в моем проекте Junction на GitHub.

Junction содержит несколько многопоточных реализаций интерфейса map – даже «самая простая в мире» среди них, под названием ConcurrentMap_Crude. Для краткости будем называть ее Crude map. В этом посте я объясню разницу между Crude map и Linear map из библиотеки Junction. Linear — самый простой map в Junction, поддерживающий и изменение размера, и удаление.

Можете ознакомиться с объяснением того, как работает Crude map, в первоначальном посте. Если коротко, то она основана на открытой адресации и линейном пробировании. Это значит, что она по сути является большим массивом ключей и значений, использующим линейный поиск. Во время добавления или поиска заданного ключа мы вычисляем хеш от ключа, чтобы определить, с какого места начать поиск. Добавление и поиск данных возможны в многопоточном режиме.

Что такое Resizable Concurrent Map - 1
Читать полностью »

image

Безблокировочная хеш-таблица — это медаль о двух сторонах. В некоторых случаях они позволяют достигать такой производительности, которой не получить другими способами. С другой стороны, они довольно сложны.
Читать полностью »

image

В этом посте мы хотели бы еще раз поднять тему программирования без блокировок, сперва дав ему определение, а затем выделить из всего многообразия информации несколько ключевых положений. Мы покажем, как эти положения соотносятся между собой, с помощью блок-схем, а потом мы немного коснемся деталей. Минимальное требование к разработчику, постигающему lock-free, — умение писать правильный многопоточный код, используя мьютексы или другие высокоуровневые объекты синхронизации, например, семафоры или события.
Читать полностью »

Метод рекурсивной координатной бисекции для декомпозиции расчетных сеток - 1

Введение

Расчетные сетки широко применяются при решении численных задач с помощью методов конечных разностей. Качество построения такой сетки в значительной степени определяет успех в решении, поэтому иногда сетки достигают огромных размеров. В этом случае на помощь приходят многопроцессорные системы, ведь они позволяют решить сразу 2 задачи:

  1. Повысить скорость работы программы.
  2. Работать с сетками такого размера, который не помещается в оперативной памяти одного процессора.

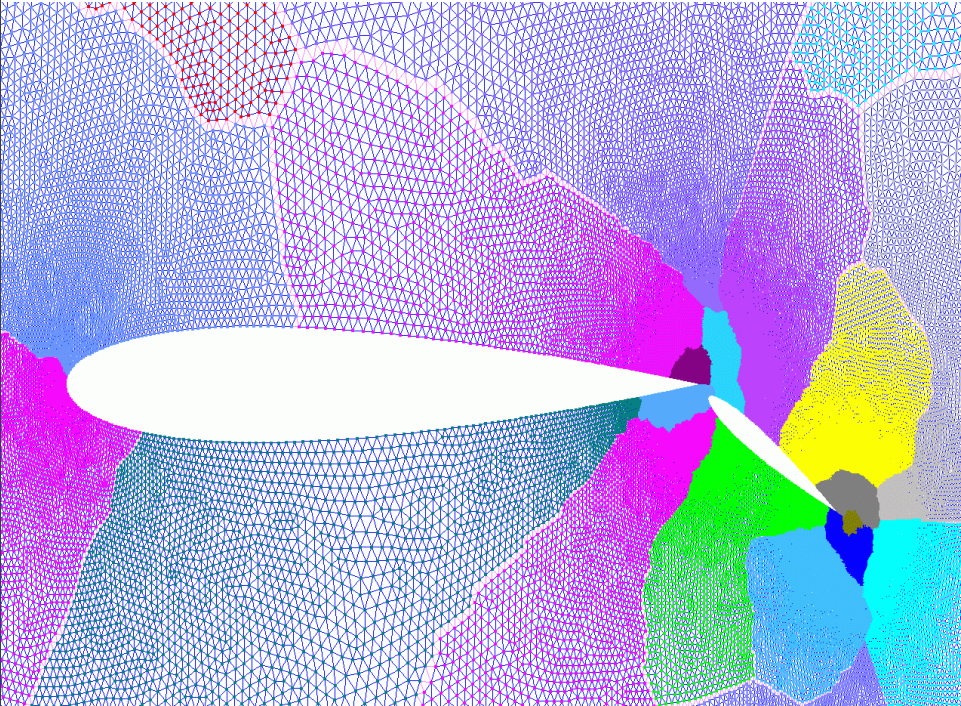
При таком подходе сетка, покрывающая расчетную область, разбивается на множество доменов, каждый из которых обрабатывается отдельным процессором. Основная проблема здесь заключается в «честности» разбиения: нужно выбрать такую декомпозицию, при которой вычислительная нагрузка распределена равномерно между процессорами, а накладные расходы, вызванные дублированием вычислений и необходимостью передачи данных между процессорами, малы.

Характерный пример двумерной расчетной сетки приведен на первой картинке. Она описывает пространство вокруг крыла и закрылка самолета, узлы сетки сгущаются к мелким деталям. Несмотря на визуальное различие в размерах разноцветных зон, каждая из них содержит примерно одинаковое число узлов, т.е. можно говорить о хорошей декомпозиции. Именно эту задачу мы и будем решать.
Читать полностью »

Как работает hashCode() по умолчанию? - 1

Попытка заглянуть вглубь hashCode() привела к спелеологическому путешествию по исходному коду JVM, с рассмотрением структуры объектов и привязанной блокировки (biased locking), а также удивительных последствий для производительности, связанных с использованием hashCode() по умолчанию.
Читать полностью »

Логика сознания. Часть 11. Естественное кодирование зрительной и звуковой информации - 1В предыдущей части были сформулированы требования к процедуре универсального обобщения. Одно из требований гласило, что результат обобщения должен не просто содержать набор понятий, кроме этого полученные понятия обязаны формировать некое пространство, в котором сохраняются представление о том, как полученные понятия соотносятся между собой.

Если рассматривать понятия как «точечные» объекты, то такую структуру можно отчасти описать матрицей взаимных расстояний и представить в виде взвешенного графа, где вершины — это понятия, а каждому ребру сопоставлено число, соответствующее расстоянию между понятиями, которые это ребро соединяет.

Ситуация несколько усложняется, когда понятия имеют природу множеств (рисунок ниже). Тогда возможны формулировки типа: «понятие C содержит понятия A и B», «понятия A и B различны», «понятия A и B имеют нечто общее». Если положить, что близость определяется в интервале от 0 до 1, то про рисунок слева можно сказать: «близость A и C равна 1, близость B и C равна 1, близость A и B равна 0).
Читать полностью »

Мы всё-таки смогли дойти до третьей части и добрались до самого интересного — организации асинхронных вычислений.

В прошлых двух статьях мы посмотрели на абстракцию параллельно выполняющегося кода и кооперативного выполнения обработчиков задач.

Теперь посмотрим, как можно управлять потоком исполнения (control flow) в случае обработки асинхронных задач.

Читать полностью »

Немного Intel Xeon Phi теперь может получить каждый - 1Intel Xeon Phi — уникальный процессор, как никто другой раскрывающий все преимущества параллельного исполнения задач. Созданный по технологии Intel Many Integrated Core (MIC), он предоставляет вам несколько десятков мощных вычислительных ядер и порядочный кусок интегрированной высокоскоростной памяти. Думаю, что многие программисты, как начинающие, так и опытные, хотели бы «погонять» свой код на таком процессоре, чтобы найти его узкие места, оценить влияние параллелизма на производительность и так далее. Останавливает одно: стоимость самой младшей модели Xeon Phi составляет $2500, и это только сам процессор. Навряд ли многие рискнут приобрести такую систему для личных нужд, а нужда такая, как уже говорилось, бывает.

Теперь жизнь энтузиастов становится немного проще. Образовательный центр Colfax Research при финансовой поддержке Intel запустил программу удаленного доступа до кластера серверов на базе Intel Xeon Phi. Детали программы — под катом, но сначала коротко о самом Intel Xeon Phi — давненько мы на эту тему не писали.
Читать полностью »

Логика сознания. Часть 10. Задача обобщения - 1 В принципе, любая информационная система сталкивается с одними и теми же вопросами. Как собрать информацию? Как ее интерпретировать? В какой форме и как ее запомнить? Как найти закономерности в собранной информации и в какой форме их записать? Как реагировать на поступающую информацию? Каждый из вопросов важен и неразрывно связан с остальными. В этом цикле мы пытаемся описать то, как эти вопросы решаются нашим мозгом. В этой части пойдет разговор о, пожалуй, самой загадочной составляющей мышления — процедуре поиска закономерностей.

Взаимодействие с окружающим миром приводит к накоплению опыта. Если в этом опыте есть какие-либо закономерности, то они могут быть выделены и впоследствии использованы. Наличие закономерностей можно интерпретировать, как присутствие чего-то общего в воспоминаниях, составляющих опыт. Соответственно, выделение таких общих сущностей принято называть обобщением.

Задача обобщения – это ключевая задача во всех дисциплинах, которые хоть как-то связаны с анализом данных. Математическая статистика, машинное обучение, нейронные сети – все это вращается вокруг задачи обобщения. Естественно, что и мозг не остался в стороне и как мы можем иногда наблюдать на собственном опыте, тоже порой неплохо справляется с обобщением.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js