Рубрика «big data» - 138

В последнее время было большое количество постов о ЦЕРНе и Большом Адронном Kоллайдере (БАК или LHC). Но не многие знают, что БАК производит ~20 ПБ данных в год. Порядка 50% всех данных хранится в dCache.

dCache является распределённой системой хранения данных, способной работать на обычном железе, с возможностью расширения посредсвом добавления новых узлов. Всё, что нужно для работы на узле, — это JVM (так как всё написано на джаве) и файловая система, где, собственно, и хранятся данные. Типичные инсталляции используют Linux(RHEL/SL/CentOS 6) или Solaris с XFS или ZFS, соответсвенно. В связи с натурой эксперементальных данных dCache не предусматривает изменение хранимых файлов.

dCache разрабатывается с 2000 года и с 2002 года используеться в более чем 80 научных центрах мира, включая Россию. Самые маленькие системы состоят из одного узла в несколько ТБ, самые большие состоят из ~500 узлов с суммарным дисковым пространством в 22 ПБ.
Читать полностью »

MarkLogic является сервером приложений и любая программа написанная на XQuery для него может получить доступ не только к объектам хранящимся в самой базе данных, но и к файлам находящимся непосредственно на файловой системе.
API предоставляющий доступ к файловой системе в MarkLogic Server не так уж и богат, но имеющихся средств вполне достаточно чтобы зачитывать данные с файловой системы напрямую из XQuery кода и выполнять сохранения файлов на неё.
Читать полностью »

Только что на YaC 2013 мы анонсировали свою новую платформу «Атом». Она использует множество наших технологий, которые мы создавали для разных задач, чтобы решить одну большую — изменить интернет так, чтобы каждый из нас перестал быть для него абстракцией, а стал человеком со своим характером и интересами. Мы поняли, что у нас есть возможность дать такие технологии всему интернету.

image

Постепенно мы все пришли к пониманию, что интернет определятся не документами, а людьми. Он связан с реальностью и состоит из потребностей, предпочтений и задач людей — как мир из атомов. Наша программа — о человеке, она выдвигает и проверяет гипотезы о том, чего он хочет, что ему интересно, что ему нужно на конкретном сайте. Она об атомах, из которых состоит сегодняшняя цифровая вселенная. И мы хотим вместе с вами определить, какой должна быть платформа Атом, чтобы она могла решать поставленные перед ней задачи эффективно.
Читать полностью »

Еще немного о том как MarkLogic Server хранит данные.
Читать полностью »

Привет коллеги.
Хочу поделиться своим опытом использования HBase, а именно рассказать про bulk loading. Это еще один метод загрузки данных. Он принципиально отличается от обычного подхода (записи в таблицу через клиента). Есть мнение, что с помощью bulk load можно очень быстро загружать огромные массивы данных. Именно в этом я решил разобраться.
Читать полностью »

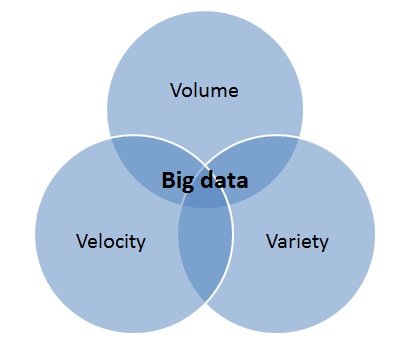
Рассматривая разные технологии хранения данных и решения, предлагаемые компанией LSI, мы немного подзабыли о практически-прикладном смысле этого всего. Зачем нужны все возрастающие скорости и емкости дисков? Одно из первых, приходящих в голову применений — это, конечно, Big Data или Большие данные. Чем же эти Большие данные отличаются от просто больших, чтоб заслужить написание с большой буквы? Обычно это называют «правило трех V».

Прогноз погоды
Читать полностью »

MarkLogic Server – это документо-ориентированная native XML база данных. Как и в любой документо-ориентированной DB в MarkLogic Server данные можно представить как файлово-фолдерную структуру. Кстати, при доступе к хранилищу через WebDAV данные именно так и представляются. Помимо собственно XML в MarkLogic Server можно хранить и любые бинарные данные в виде файлов.

Внутренне представление XML данных в MarkLogic Server довольно сложное и будет рассмотрено позже. Сейчас же стоит сказать о том, что поместить в MarkLogic Server можно только well formed XML так как хранится он не в виде простого текста, а как объект данных типа XML. Кодировкой внутреннего представления XML данных является Unicode, что избавляет от множества проблем с разными языками. Все Entity в XML данных разворачиваются в цифровые еntity. Если в документе используются только они, то это не доставит никаких проблем, в противном случае MarkLogic Server должен «знать» о всех используемых entity.
Читать полностью »

Всем привет!

Давно хотел написать статью. Я сам мало люблю длинные тексты с небольшим количеством полезной информации, поэтому постараюсь сделать этот максимально насыщенным.

Обобщенная тема – эффективная упаковка данных, сериализация и десериализация объектов.
Основная цель – поделиться своими размышлениями по этому поводу и обсудить структуру данных DSV.

Проблема:
Известные мне на текущий момент (2013-09-19 18:09:56) механизмы бинарной сериализации обладают недостаточной гибкостью или избыточность занимаемого пространства. Например:
QString s1(“123”); -> 4 байта размера данных = 0x00000003, 3 байта полезных данных = “123”, эффективность = 3/7;
U32 val1(123); -> 4 байта данных (0x0000007B), 1 байт из которых является значимым = 123 (0x7B), эффективность = 1/4.
Читать полностью »

Меня спросили: «Сколько у вас опыта с большими данными и Hadoop?» Я ответил, что часто использую Hadoop, но редко — с объёмами данных больше нескольких ТБ. Я новичок в больших данных — понимаю идеи, писал код, но не в серьёзных масштабах.

Следующий вопрос был: «Можете ли вы сделать простую группировку и сумму в Hadoop?» Разумеется, могу, и я попросил пример формата данных.

Они вручили мне флэш-диск со всеми 600 МБ данных (да, это были именно все данные, а не выборка). Не понимаю, почему, но им не понравилось моё решение, в котором был pandas.read_csv и не было Hadoop.
Читать полностью »

Аналитика в рознице: сегодня вы не купили презервативы, а магазин уже знает, когда вам пригодится скидка на детское питание
Вот как-то так это хитро работает

Про вашего будущего ребёнка – это, конечно, утрировано, но все может быть. На практике мы помогаем рознице бороться за каждый рубль с помощью математического аппарата. Вот, например, у вас в бумажнике есть карта лояльности, либо вы расплачиваетесь кредиткой. Это значит, что в целом магазин знает, сколько и каких продуктов вам надо. Дальше можно построить оптимальную модель вашего путешествия по магазину и понять, в какой ситуации вы купите больше. Что где должно стоять, какое молоко вы предпочитаете (вдруг вы готовы брать дорогое и натуральное без колебаний?) и так далее. Смоделировать вас по совокупности данных легко.

Такую же аналитику можно применять ко всем аспектам работы розницы.

Из смешного — один раз система просчитала, что будет выгодно уничтожить примерно полтонны бумаги. Сначала думали, что баг — но начали копать и выяснили, что поставщик даёт скидку за определённый порог закупки. А сеть может не успевать продавать нужное количество бумаги. С учётом стоимости склада, поставки и уровня скидки начиная с порога — проще взять и уничтожить кучу товара, чтобы получать его по цене ниже. Скидка минимум вдвое компенсирует убытки от его потери. Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js