N-Tier vs eXtreme Application Platform
Проблемы Трёхуровневой Архитектуры
Большинство современных софт приложений для бизнесов состоят из 3-ех уровней. Первый слой содержит данные, которые в своем большинстве хранятся в реляционной базе данных (relational database). Здесь данные сохраняются, модернизируются, извлекаются и отправляются в следующий, логический слой. Второй слой это бизнес-логика (business logic), который обрабатывает команды и вычисления, выполняет логические решения и передает и обрабатывает данные между окружающими слоями. В мире JEE этот уровень обычно представлен при помощи JEE application servers, такими как WebSphere, WebLogic и JBoss. В большинстве случаев существует отдельный веб уровень, или слой клиента, который ответственен за представление задач и результатов, понятных пользователю. Как правило, перед веб уровнем стоит балансировщик нагрузки (load balancer).
Множество приложений также используют уровень сообщений (messaging), обеспечивая надежное асинхронное взаимодействие с компонентами приложений и возможность внедрения обработки информации при помощи событийно-ориентированных (event-driven) шаблонов. Сервисы бизнес-логики принимают сообщения из этого уровня в порядке их поступления в систему и обрабатывают их. Для достижения высокой доступности (high availability) и увеличения способности обработки большего количества данных все уровни используют кластерную архитектуру (cluster).
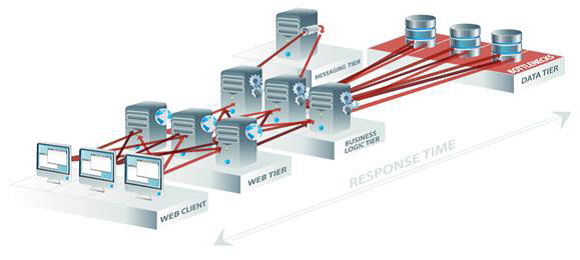
Анализируя эту архитектуру с легкостью можно выявить несколько очевидных проблем:
1. Трудности в управлении: все уровни имеют различные модели кластеризации. Для управления такой системой требуются знания и опыт работы со всеми из них. Это влечет за собой:
a. Высокую стоимость: компании вынуждены приобретать отдельные лицензии для всех составных частей и нанимать экспертов для установки и поддержки каждого из уровней. Кроме того, кластеризация некоторых составляющих не всегда проста и, зачастую, полна непредвиденных трудностей даже для самых опытных специалистов.
b. Трудности в контролировании: отслеживание и мониторинг такого большого количества компонентов в настоящей работающей системе в очередной раз требует дополнительных ресурсов. В большинстве случаев, необходимо приобретать дополнительные софт приложения для таких целей.
c. Трудности в идентификации и решении проблем: трудно определить что и на каком уровне случилось если система вышла из строя
d. Трудности во внедрении программного обеспечения: межмодульная интеграция и конфигурация также может послужить дополнительным источником расходов. Заставить все модули «общаться» правильно один с другим, как правило, займет некоторое время и дополнительные ресурсы.
2. Такая архитектура привязана к статическим ресурсам, таким как жесткие диски и имена серверов. Очень трудно будет установить такое приложение на виртуализированных платформах (virtual platforms/environments), так как те (платформы) очень динамичны по своей натуре.
3. Время ожидания (latency) и производительность (performance): в таких архитектурах бизнес-транзакция (transaction) обычно проходит через большинство (если не через все) уровней системы перед ее завершением. Это включает в себя множество сетевых прыжков (network hops) между уровнями и внутри них.
В добавок, гарантирование достоверности бизнес-транзакций подразумевает запись на диск в тот или иной этап программы. Сетевой и дисковой I/O значительно ограничивает масштабируемость (scalability) и увеличивает latency бизнес-транзакций. Как результат, Трехуровневая Архитектура не может быть предсказуемо масштабирована. Если увеличить нагрузку на систему, что в свою очередь потребует больше ресурсов для обработки информации, то добавка дополнительного аппаратного обеспечения вряд ли решит проблему. Встроенная опора на сетевое и дисковое I/O по сути ограничивает возможности системы. Более того, зачастую добавка дополнительных ресурсов в один из уровней (например, слой данных) не только не поможет, но может даже повысить время ожидания и понизить производительность системы в целом из-за накладных расходов связанных с синхронизацией узлов кластера.
Почему cache и datagrid решения не разрешают проблему
Чтобы решить проблемы времени ожидания и масштабируемости обычно ставят in-memory datagrid перед реляционной базой данных. Несомненно, это решение в правильном направлении, которое частично разгружает систему и, в основном, подходит для считывания данных (data cashing). Стоит обратить внимание, что большинство datagrids ограничены своей возможностью извлекать данные только при помощи уникального идентификатора. Хотя такое решение может быть применено в отдельных случаях, все же оно не идеально по следующим причинам:
1. Оно добавляет еще один уровень, для которого требуются дополнительные лицензии. Как и все другие, новый уровень нужно интегрировать, конфигурировать, контролировать и удалять неисправности, если возникнут. Таким образом, это увеличивает общую сложность управления данной архитектурой и расходы на ее установку, поддержку и обслуживание.
2. Как было упомянуто выше, решения данного образца помогут для систем, где в большинстве операций извлекаются данные. Но это абсолютно бесполезно для систем, где данные нужно сохранять или модернизировать.
Пример из реального мира
После столь длинного предисловия, я предлагаю продемонстрировать всю вышесказанную теорию на примере, иначе все это не имеет никакого смысла. Рассмотрим реальную многоуровневую архитектуру системы компании Kohl’s из сферы интернет продаж.
Сразу бросается в глаза, что везде нас поджидают те самые «узкие места» (bottlenecks), через которые любыми способами нужно пропустить всю приходящую информацию. Явно, что добавление дополнительных ресурсов в каждый из уровней никак не поможет избавиться от существующих критических элементов (bottlenecks) всей системы (между уровнями).
Сервера WebLogic, Apache и база данных Oracle прекрасно справлялись с заданием, используя 50 физических серверов. 30,000 одновременно подсоединенных пользователей исправно получали ответы на все требования и запросы. Оно бы все продолжало работать и впредь, если бы, например, компания должна была бы обслуживать определенное фиксированное количество транзакций ежесекундно, и не происходило бы никаких резких изменений в требованиях к системе.
Однако, та самая «черная пятница» (Black Friday, когда миллионы американцев рвутся в магазины, а ритейлеры делают 20, а иногда и 30 процентов от годовой выручки за один день) 2009-го года потребовала следующие условия: система должна справляться с нагрузкой в 500,000 пользователей одновременно. К такому удару вышеупомянутая архитектура была не готова, а впоследствии не было смысла чинить тонущий корабль без его полной реконструкции. Результат: мульти-миллионная потеря доходов.
Альтернатива
На протяжении последних десяти лет на рынке появились приложения, которые с легкостью справляются с данными задачами и находятся в эксплуатации в критически важных системах (mission critical systems) в сферах финансовых услуг, интернет продаж (как у Kohl’s), онлайн игр и других. Одним из таких является XAP (eXtreme Application Platform) так же известно как In-Memory Computing Platform.
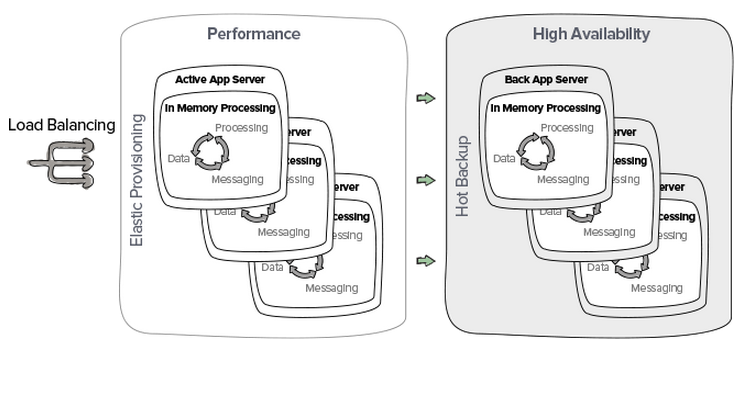
XAP это платформа для разработки программного обеспечения, которая:
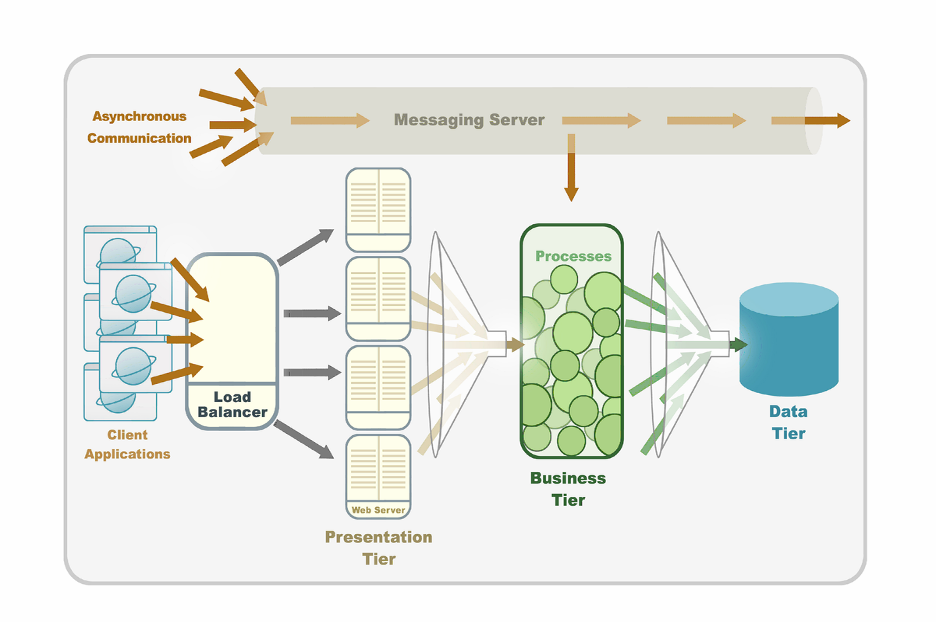
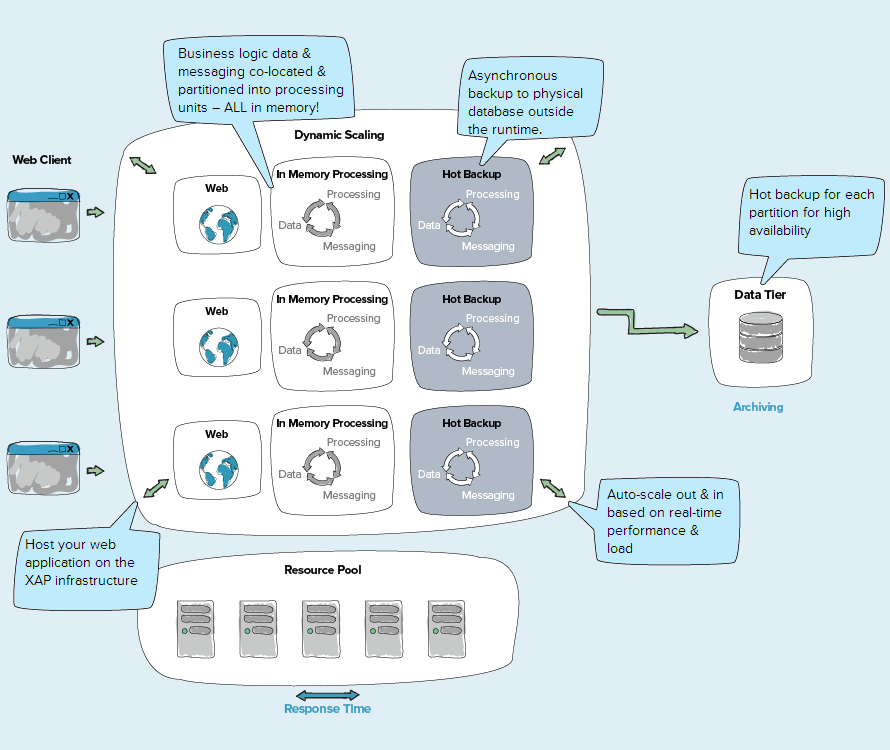
1. Позволяет запускать всё приложение в целом на одной платформе, в то время как все уровни из многоуровневой архитектуры работают в одном контейнере (container).
2. Позволяет быстрое обращение к данным, так как всё хранится в памяти. Хранение данных близко к бизнес-логике ликвидирует задержки в транзакциях связанные с обращениями к дискам или сетевыми проблемами. Следовательно, расположение данных, бизнес-логики и messaging в одном контейнере существенно увеличивает производительность (performance). Увеличение производительности измеряется в десятки, сотни, а иногда и в тысячи раз.
3. Позволяет секционирование данных (data partitioning) для автономных вычеслительных единиц (processing units), предоставляет механизмы, чтобы эластично подключать компоненты приложения для обработки любых нагрузок и динамично выделять ресурсы для оптимального использования. Как результат, мы получаем линейную масштабируемость, оптимизированную балансировку нагрузки и эффективное использование ресурсов.
4. Гарантирует нулевое время простоя (zero downtime) при помощи горячего резервирования (hot backup) и автоматического восстановления после сбоя. Вместе это также известно, как высокая доступность (high availability). Дополнительно XAP предоставляет многоуровневые мониторинговые возможности для нахождения и идентификации операционных и функциональных проблем.
Общая диаграмма архитектуры приложения разработанного на XAP:
(видео: www.gigaspaces.com/xap-in-memory-computing-event-processing/Meet-XAP)
Читать полностью »