
Temper 0.5B — моя небольшая модель, дообученная на базе Qwen2.5-Coder-0.5B‑Instruct, упор которой сделан на языке Rust. Узкая специализация позволила ей обойти модели крупнее, вплоть до x3 по параметрам. Целью дообучения было проверить возможности крошечной модели в узкой задаче, сравнить с общими того же размера и выше.
Рубрика «Fine-tuning»
Сколько Rust помещается в 0.5B
2026-10-07 в 7:47, admin, рубрики: Fine-tuning, hugging face, llm, qwen, Rust, генерация кода, дистилляция, малые языковые модели, обучение с подкреплениемХотел свою систему, которую можно менять когда угодно, и сделал три десктопных AI-приложения
2026-09-23 в 11:40, admin, рубрики: AI, ai-агенты, electron, Fine-tuning, lora, Ollama, React, tauri, десктопные приложения, локальные llmХотел свою систему, которую можно менять когда угодно, и сделал три десктопных AI-приложения
Привет! Это моя первая статья, и она про Zeqou: небольшую экосистему десктопных приложений для работы с языковыми моделями. Два приложения уже готовы, третье выйдет совсем скоро. Расскажу, что они умеют, как устроены и с какими неожиданными проблемами я столкнулся.
Коротко. Zeqou — это три приложения: чат, рабочее пространство для агентов и студия дообучения моделей. Они бесплатные и работают на Windows, macOS и Linux. Чат и Harness готовы, xtraining выйдет очень скоро.
Зачем всё это
Я всегда хотел иметь Читать полностью »
Хотел упростить мониторинг проектов и в отпуск — пришлось обучать свой LLM
2026-05-08 в 14:27, admin, рубрики: devops, Fine-tuning, llm, Ollama, OpenClaw, python, qwenЯ работаю по ИП, поэтому не только пишу код, но и поддерживаю как DevOps свои проекты у заказчика. Эта история началась банально: я собирался в отпуск и хотел оптимизировать часть процессов, которые в повседневной жизни занимают время — чтобы не дёргать клиентов из-за вопросов по ошибкам, которые я мог не увидеть во время отдыха. Пусть локальная моделька сама разгребает типовое. Думал: запущу OpenClaw, подключу к локальной модели — и поеду спокойно
Fine-tuning Qwen-8B под проприетарный синтаксис (CADINP) на одной RTX 3090: опыт инженера-конструктора
2026-01-21 в 3:38, admin, рубрики: CADINP, deepseek, Fine-tuning, gguf, llm, qwen, RTX 3090, SOFiSTiK, unsloth, локальные нейросетиПроблема: Галлюцинации в инженерных расчетах
Я занимаюсь расчетами строительных конструкций в комплексе SOFiSTiK. Основной инструмент взаимодействия с ним — внутренний язык CADINP. Это мощный, но старый процедурный язык с жестким синтаксисом: строгая последовательность модулей (AQUA -> SOFIMSHC -> ASE), специфичные команды фиксации узлов и неявные зависимости.
SOTA-модели (ChatGPT-4o, Claude 3.5 Sonnet) справляются с CADINP посредственно. Основные проблемы при генерации кода general-purpose моделями:
-
Синтаксический шум: Выдумывание несуществующих аргументов функций.
-
Потеря контекста:Читать полностью »
Fine-tune Qwen3 за написание позитивных отзывов о ресторанах
2025-12-05 в 17:47, admin, рубрики: Fine-tuning, qwen3, unslothГенератор отзывов о ресторане:
Собрано около шестнадцати тысяч положительных отзывов от ресторанов с оценкой выше 4,7 (из 5), расположенных в Москве. Подробнее на .
Использованная модель — Qwen3-4B (версия Qwen3, поддерживающая русский язык). Для обучения модели в течение двух эпох использовалась библиотека Unsloth с LoRA (Low-Rank Adaptation — метод тонкой настройки больших языковых моделей). В результате был выбран LoRA 32-го ранга, и обучено 66 миллионов параметров. Теперь модель способна генерировать качественные новые обзоры.
T-LoRA: дообучить диффузионную модель на одной картинке и не переобучиться
2025-10-21 в 10:53, admin, рубрики: diffusion models, Fine-tuning, image generation, lora, lora-адаптерыВы когда‑нибудь мечтали стать лучшей версией себя? Моложе, красивее, идеальнее… А вот LoRA уже стала!
Меня зовут Вера Соболева, я научный сотрудник лаборатории FusionBrain Института AIRI, а также стажер‑исследователь Центра глубинного обучения и байесовских методов НИУ ВШЭ. Cегодня я расскажу про наше свежее исследование T‑LoRA: Single Image Diffusion Model Customization Without Overfitting. Мы с коллегами придумали эффективный способ как файнтюнить диффузионные модели с помощью LoRA всего по одной картинке.
IT-лидеры видят большой бизнес-потенциал в малых моделях ИИ
2025-10-02 в 11:00, admin, рубрики: AI, ai agent, Fine-tuning, gartner, genai, llm, llm-модели, rag, ИИИТ-лидеры видят большой бизнес-потенциал в малых моделях ИИ благодаря гибкости, низкой стоимости и нацеленности на конкретные задачи малые языковые модели (SLM) лучше подходят для бизнес-специфичных приложений и вскоре могут обойти LLM по использованию в корпоративной среде.
Малые языковые модели (SLM) дают CIO больше возможностей разрабатывать специализированные, отраслевые AI-приложения, эксплуатация которых дешевле, чем систем на базе универсальных больших языковых моделей (LLM).
Домен-специфичные LLM: как сделать ИИ реально полезным для вашего бизнеса
2025-09-29 в 11:00, admin, рубрики: AI, Fine-tuning, gpt, llm, llm-модели, rag, ИИУниверсальные модели вроде GPT хорошо справляются с широким классом задач, но буксуют в узких доменах. Они не знают специфику нишевых индустрий, их жаргон и не имеют доступа к проприетарным знаниям, которые делают ваш бизнес уникальным. Когда нужна система ИИ, которая действительно «понимает» именно вашу предметную область, стоит выбирать домен-специфичные LLM (DSLM).
Gartner отмечает, что одной из двух крупнейших тем ИИ с завышенными ожиданиями сейчас являются AI-ready data («данные, готовые к ИИ»).
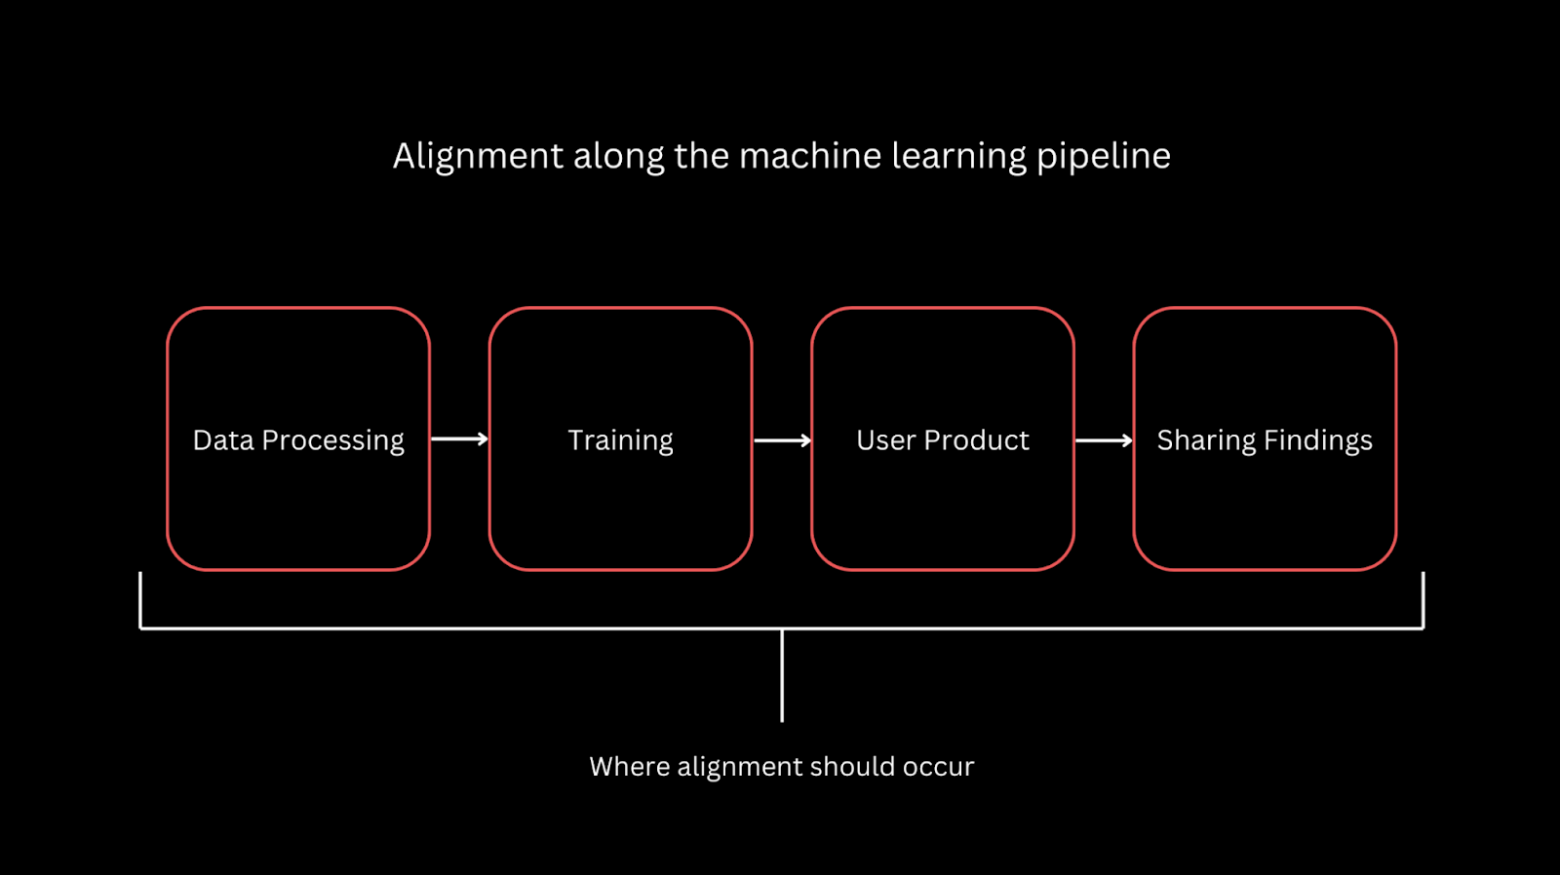
Практика alignment: данные, RLHF и UX как конкурентное преимущество
2025-09-22 в 11:01, admin, рубрики: AI, alignment, alignment ai, chatgpt, Fine-tuning, llm, machinelearning, ml, RLHF, согласованностьВзгляд на самую большую проблему в мире ИИ, почему это важно для вас и почему это так ценно.
Селективная генерализация: улучшение возможностей при сохранении alignment
2025-09-19 в 11:01, admin, рубрики: AI, alignment, Fine-tuning, large language model, llm, lora, ИИ, ПаретоTL;DR: Мы провели бенчмаркинг семи методов, направленных на предотвращение эмерджентного рассогласования и других форм некорректного обобщения с использованием ограниченного объёма alignment-данных. Мы демонстрируем устойчивый трейдофф между способностями модели и согласованием, подчеркивая необходимость более эффективных методов для снижения этого конфликта. Простое включение alignment-данных в микс обучающих данных оказывается недостаточным для предотвращения рассогласования, однако простое наложение KL Divergence penalty на alignment-данные показывает лучшие результаты, чем более сложные подходы.