
Рубрика «sre»

Все, кто работал c k8s, знают: что такое CNI, разбираются как его подключить и даже поверхностно могут понимать какой из предлагаемых на «рынке» интерфейсов лучше подходит под определенный кейс. Но между поверхностными абстракциями и пониманием того, что фактически происходит с пакетом пропасть. Пока кластер функционирует стабильно эта пропасть не мешает. Она стреляет, когда начинается полтергейст: пакеты теряются между нодами, latency скачет через раз, NetworkPolicy «отказывается работать», но по всем кажущимся метрикам все зеленое.

В этой статье я постараюсь пройти путь пакета руками:
Боль

Если вы держите on‑prem кластер на десятки или сотни нод, дальше можно не объяснять. Обновили CNI, или ядро, или драйвер сетевой карты, или просто переехали частью нод в новый сегмент. Проходит какое‑то время, и начинают капать тикеты: «у нас иногда таймаутит между подами», «DNS иногда не резолвится», «health‑check то падает, то нет».

Читать полностью »

Сначала контекст. Я делаю внутреннего read-only агента для инфраструктурных расследований: он может читать данные, но не изменять production. Инженер пишет ему в Mattermost или резервном web-чате обычный вопрос: «почему сервис отдаёт 502?», «кто выкатил эту версию?» или «что изменилось перед инцидентом?». Агент сам собирает данные из Kubernetes, VictoriaMetrics, Elasticsearch, GitLab, Grafana, GSLB и других эксплуатационных источников, а затем возвращает ответ с доказательствами и явно перечисленными пробелами.

Читать полностью »

В продуктовой B2B‑компании, где я отвечал за надёжность, поставили амбициозную цель: сократить цикл разработки (dev cycle time) на 20%. Забегая вперёд, скажу: к концу года цель достигли. Но уже через несколько месяцев после старта я смотрел на график инцидентов и не верил своим глазам: рост в два раза год к году.

Эта статья — о том, почему так происходит почти всегда, когда компания оптимизирует одну метрику, как мы это починили и — главное — как продать решение руководству. Именно на продаже всё обычно и умирает.

Как цель съедает систему

Читать полностью »

Недавно я делал учебный проект про автоматизацию документирования инцидентов. Поначалу планы были грандиозными: инциденты, таймлайны, интеграции с мониторингами, чатами, постмортемы, подсказки дежурным инженерам.

Но довольно быстро стало понятно, что с временными и ресурсными ограничениями лучше не пытаться написать маленький PagerDuty. Поэтому я сузил задачу до более реалистичного ядра: локального RAG-сервиса, который ищет по документации, ранбукам и коду, а затем передаёт найденный контекст в LLM.

Так появился llmortem — FastAPI-сервис, который можно подключить к OpenWebUI как OpenAI-compatible backend.

Читать полностью »

Ракету не отправляют в космос только потому, что её двигатель и насос успешно прошли стендовые испытания по отдельности. Перед стартом инженеры рассчитывают траекторию, моделируют режимы работы и анализируют сценарии отказов. Расчёт не заменяет реальные тесты, но задаёт для них осмысленную рамку.

Читать полностью »

У вас есть Grafana. Она показывает графики с Prometheus. Prometheus скрейпит метрики с ваших сервисов. Если сервис упал — вы видите красный на дашборде. Если Prometheus упал — вы не видите ничего. Дашборд замирает на последних известных значениях. Если не знать, что Prometheus лежит, можно час смотреть на «зелёный» дашборд, который на самом деле показывает данные часовой давности.

Это не гипотетика. Я видел это дважды. Первый раз — Prometheus съел диск на мониторинг-сервере (да, Prometheus хранит данные на диске, и этот диск тоже может закончиться). Второй раз — kubelet убил pod с Prometheus из-за OOM, а Pod Disruption Budget не был настроен.

Читать полностью »

В современных Data-driven компаниях Kafka называют «центральной нервной системой» данных. Но даже идеально настроенный кластер может стать причиной Data Loss, если конфигурация инфраструктуры не синхронизирована с реальностью бизнес-потоков. В этой статье я поделюсь кейсом из практики Platform Engineer: как неочевидный конфликт настроек приводил к потерям данных и как я решил это, внедрив метрику «Data Safety Window».

Проблема: «Дырки» в данных при плановых работах

Читать полностью »

Иногда инцидент начинается не с 5xx и не с красного графика

Он начинается с одной стойки

И с одного таймаута

09:12 - alert: db-replica-02 connection timeout

HAProxy зелёный
HTTP 5xx = 0.2%
p50 = 38–42ms

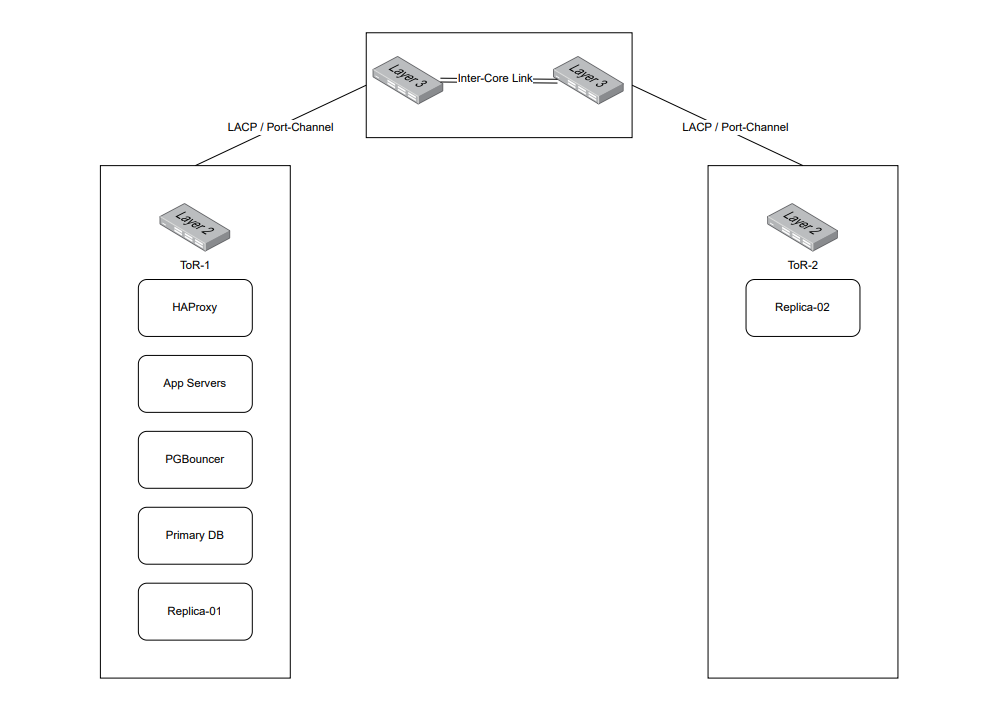
Минимальная схема

Минимальная схема

2 стойки
В каждом свой ToR
Primary и app в rack-1
Replica-01 в rack-1
Replica-02 в rack-2

Читать полностью »

Если тебе платят деньги, значит, твоя работа зачем-то нужна

Что делать и зачем, если ты не приносишь выручку: метрики, управление рисками, и целеполагание для технарей - 1

Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js