

На Хабре уже есть статья о том, как работать с SD-картами в DMA режиме на микроконтроллерах STM32, поэтому я думал, что на STM32H7 будет также просто это реализовать.
На Хабре уже есть статья о том, как работать с SD-картами в DMA режиме на микроконтроллерах STM32, поэтому я думал, что на STM32H7 будет также просто это реализовать.
Разбираемся, что за зверь хранит весь ваш Kubernetes, учимся читать его ошибки и честно отвечаем на вопрос, можно ли ему доверять
etcd — распределённое key‑value хранилище со строгой консистентностью. Если на пальцах: это место, где Kubernetes хранит авторитетное состояние кластера. Деплойменты, поды, секреты, конфигмапы — всё это записи в etcd. kube‑apiserver — по сути толстый REST‑фасад над ним, а scheduler, controller‑manager и kubelet не являются источниками истины для состояния kubernetes; они получают его через apiserver и имеют собственное локальное состояние
Отсюда первое следствие, которое стоит выжечь на подкорках:
В работе инженера по автоматизации нередко возникают задачи, выходящие за рамки типового промышленного программирования, и тех, которые были описаны в первой статье. Одной из таких является поиск и устранение неисправностей в сложных мехатронных системах, где не всегда очевидно, какой механизм или устройство работает некорректно.
Обрыв каналов связи, багованный релиз, мискоммуникация… Серия загадочных событий, авантюрный детектив из цикла «Следствие вели…» — нет, не с Леонидом Каневским, и даже не Колобки — а команда разбора инцидентов Ozon, или просто Post.
Помогая пользователям NGINX с разрешением проблемных ситуаций, мы поняли, что большинство из них часто совершает одни и те же ошибки конфигурации. Более того, подобные ситуации вполне могут возникнуть даже у самих инженеров NGINX! В этой статье рассмотрим 10 наиболее распространенных ошибок и объясним как их исправить.
Прим. перев.: в начале августа Red Hat публично рассказала о решении проблем доступности, что возникали в предыдущие месяцы у пользователей её сервиса Quay.io (в его основе — реестр для образов контейнеров, доставшийся компании вместе с покупкой CoreOS). Вне зависимости от вашей заинтересованности в этом сервисе как таковом, поучителен сам путь, по которому прошли SRE-инженеры компании для диагностики и устранения причин аварии.
19 мая, ранним утром (по летнему североамериканскому восточному времени, EDT), сервис quay.io упал. Авария затронула как потребителей quay.io, так и Open Source-проекты, использующие quay.io в качестве платформы для сборки и распространения ПО. Red Hat дорожит доверием как одних, так и других.
Команда SRE-инженеров сразу подключилась к работе и постаралась как можно скорее стабилизировать работу сервиса Quay. Однако пока они этим занимались, клиенты лишились возможности push’ить новые образы, и лишь периодически им удавалось pull’ить имеющиеся. По неведомой причине база данных quay.io блокировалась после масштабирования сервиса на полную мощность.Читать полностью »

Докер под Windows — это постоянные приключения. То ему нужно обновить операционку, иначе последние версии не ставятся, то он забывает, как подключаться к сети. В общем, каждый день от него новости. «Поставил и забыл» — это не про Docker Desktop for Windows. Особенно, когда он используется не совсем так, как рекомендуют его разработчики. А они почему-то не одобряют подключение внешних windows сетевых дисков в качестве локальных. И совсем не одобряют доступ к к таким сетевым папкам, которые расположены ещё и на host машине. Пишут, что это ужас-ужас с точки зрения безопасности, требуют всяких ключей типа:
 cap_add:

 - SYS_ADMIN

 - DAC_READ_SEARCH
для работы команды mount в контейнере и прочая, и прочая.
Читать полностью »
Прим. перев.: Эта статья входит в состав опубликованных в свободном доступе материалов проекта learnk8s, обучающего работе с Kubernetes компании и индивидуальных администраторов. В ней Daniele Polencic, руководитель проекта, делится наглядной инструкцией о том, какие шаги стоит предпринимать в случае возникновения проблем общего характера у приложений, запущенных в кластере K8s.
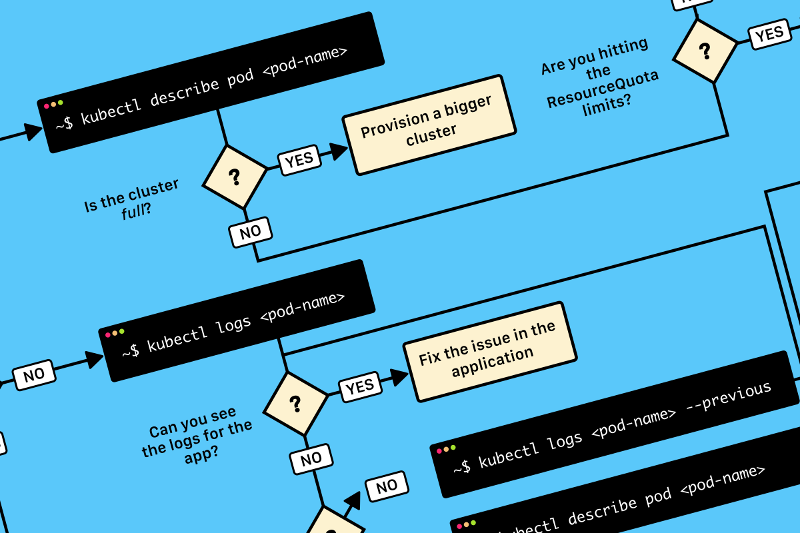
TL;DR: вот схема, которая поможет вам отладить deployment в Kubernetes:Читать полностью »
Прим. перев.: Эта статья, написанная Galo Navarro, что занимает должность Principal Software Engineer в европейской компании Adevinta, — увлекательное и поучительное «расследование» в области эксплуатации инфраструктуры. Её оригинальное название было немного дополнено в переводе по причине, которую объясняет автор в самом начале.
Примечание от автора: Похоже, эта публикация привлекла гораздо больше внимания, чем ожидалось. Я до сих пор получаю гневные комментарии о том, что название статьи вводит в заблуждение и что некоторые читатели опечалены. Я понимаю причины происходящего, поэтому, несмотря на риск сорвать всю интригу, хочу сразу рассказать, о чем эта статья. При переходе команд на Kubernetes я наблюдаю любопытную вещь: каждый раз, когда возникает проблема (например, рост задержек после миграции), первым делом обвиняют Kubernetes, однако потом оказывается, что оркестратор, в общем-то, не виноват. Эта статья повествует об одном из таких случаев. Ее название повторяет восклицание одного из наших разработчиков (потом вы убедитесь, что Kubernetes тут вовсе ни при чем). В ней вы не найдете неожиданных откровений о Kubernetes, но можете рассчитывать на пару хороших уроков о сложных системах.
Пару недель назад моя команда занималась миграцией одного микросервиса на основную платформу, включающую CI/CD, рабочую среду на основе Kubernetes, метрики и другие полезности. Переезд носил пробный характер: мы планировали взять его за основу и перенести еще примерно 150 сервисов в ближайшие месяцы. Все они отвечают за работу некоторых из крупнейших онлайн-площадок Испании (Infojobs, Fotocasa и др.).Читать полностью »