Рубрика «big data» - 91

Видеозапись вебинара «Инструменты для работы Data Scientist» - 1

Вчера наша команда провела вебинар на тему «Инструменты для работы Data Scientist». В его рамках мы рассмотрели, кто такой data scientist и какими инструментами он пользуется. Поговорили о платформе FlyElephant и чем она может быть полезной для работы data scientist’а.
Читать полностью »

После того, как в предыдущих статьях данной серии обзоров распределённого Java-фреймворка Apache Ignite мы сделали первые шаги, познакомились с основными принципами построения топологии и даже сделали стартер для Spring Boot, неизбежно встаёт вопрос о кэшировании, которое является одной из основных функций Ignite. Прежде всего, хотелось бы понять, нужно ли оно, когда библиотек для кэширования на Java и так полным-полно. Тем, что предоставляется реализация стандарта JCache (JSR 107) и возможность распределённого кэширования в наше время удивить сложно. Поэтому прежде чем (или вместо того чтобы) рассматривать функциональные возможности кэша Apache Ignite, мне бы хотелось посмотреть, насколько он быстр.

Измеряем производительность кэша Apache Ignite - 1

Для исследования применялся бенчмарк cache2k-benchmark, разработанный с целью доказательства того, что у библиотеки cache2k кэш самый быстрый. Вот заодно и проверим. Настоящая статья не преследует цель всеобъемлющего тестирования производительности, или хотя бы научно достоверного, пусть этим занимаются разработчики Apache Ignite. Мы просто посмотрим на порядок величин, основные особенности и взаимное расположение в рейтинге, в котором будут ещё cache2k и нативный кэш на ConcurrentHashMap.
Читать полностью »

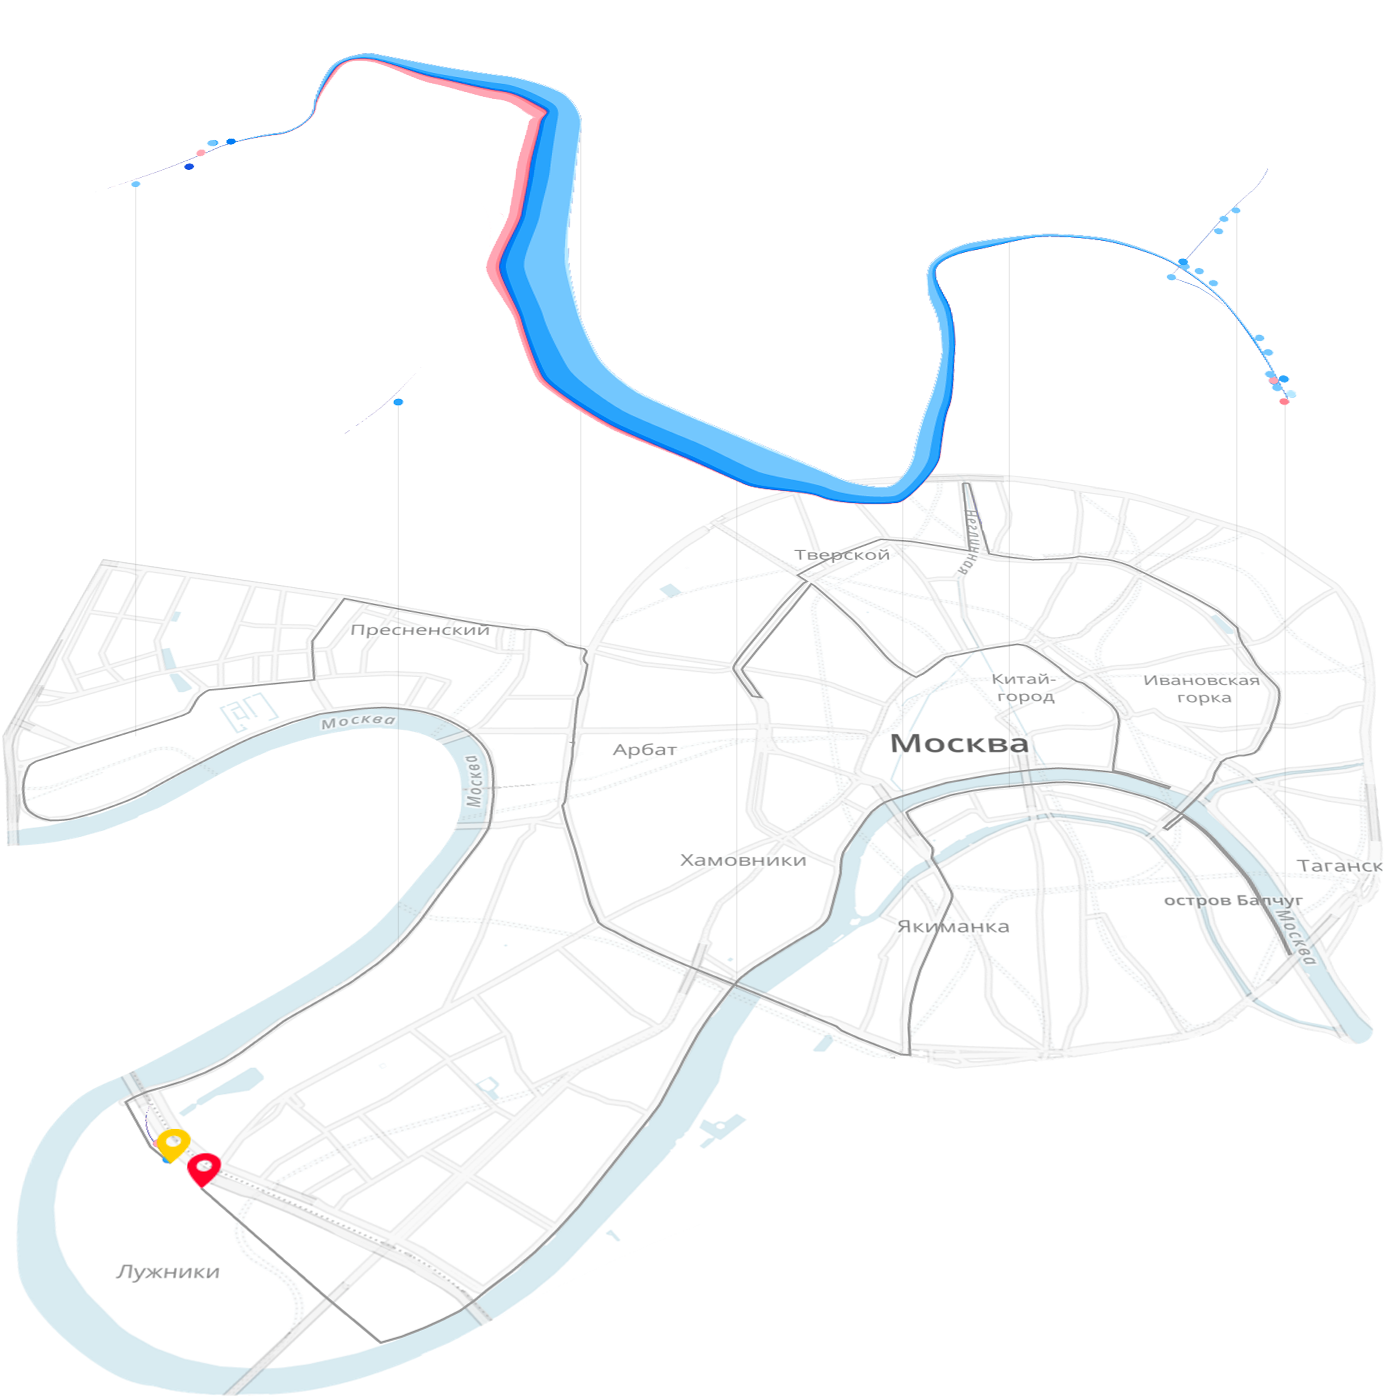
За три года существования Лаборатория данных выпустила около тридцати интерактивных визуализаций, в формате заказных, собственных проектов и бесплатных советов. Мы в лаборатории визуализируем финансовые и научные данные, данные городской транспортной сети, результаты забегов, эффективность маркетинговых кампаний и многое другое. Весной мы получили бронзовую медаль на престижной премии Malofiej 24 за визуализацию результатов Московского марафона.

Последние полгода я работаю над алгоритмом визуализации данных, который систематизирует этот опыт. Моя цель — дать рецепт, который позволит разложить любые данные по полочкам и решать задачи по визуализации данных также чётко и последовательно, как математические задачи. В математике не важно, складывать яблоки или рубли, распределять кроликов по ящикам или бюджеты на рекламные кампании — есть стандартные операции сложения, вычитания, деления и т.д. Я хочу создать универсальный алгоритм, который поможет визуализировать любые данные, при этом учитывает их смысл и уникальность.

Я хочу поделиться с читателями Хабра результатами своих исследований.
Алгоритм визуализации сложных данных - 1
Читать полностью »

Big Data – это проблема. Количество информации растет с каждым днем, и она накапливается как снежный ком. Прекрасно то, что проблема эта имеет решения, только в мире JVM больший данных процессят десятки тысяч проектов.

В 2012 году увидел свет фреймворк Apache Spark, разработанный на Scala и рассчитанный на повышение производительности определенных классов задач в работе с Big Data. Проекту уже 4 года он повзрослел и дорос до версии 2.0, к которой (на самом деле уже начиная с версии 1.3-1.5) имеет мощный и удобный API для работы с Java. Чтобы понять, для кого это все надо, какие именно задачи стоит решать при помощи Spark, а какие не стоит, мы поговорили с Евгением EvgenyBorisov Борисовым, автором тренинга «Welcome to Spark», который пройдет 12-13 октября в Петербурге.

Welcome to Spark… on Java: Интервью с Евгением Борисовым - 1
Читать полностью »

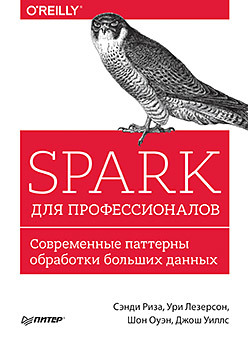
image Привет, Хаброжители! Ранее мы переводили статью «Знакомство с Apache Spark». Сейчас вы знакомим Вас с одноименной книгой, написанной Сэнди Ризай, Ури Лезерсоном, Шоном Оуэн, Джошем Уиллсом.

В этой практичной книге четверо специалистов Cloudera по анализу данных описывают самодостаточные паттерны для выполнения крупномасштабного анализа данных при помощи Spark. Авторы комплексно рассматривают Spark, статистические методы и множества данных, собранные в реальных условиях, и на этих примерах демонстрируют решения распространенных аналитических проблем.
Читать полностью »

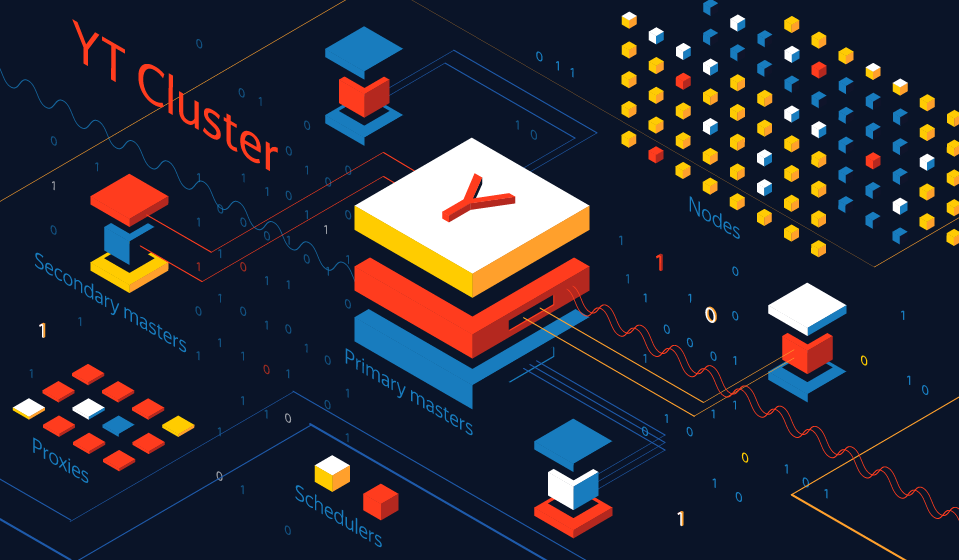
В течение последних шести лет в Яндексе идет работа над системой под кодовым называнием YT (по-русски мы называем её «Ыть»). Это основная платформа для хранения и обработки больших объемов данных — мы уже о ней рассказывали на YaC 2013. С тех пор она продолжала развиваться. Сегодня я расскажу о том, с чего началась разработка YT, что нового в ней появилось и что ещё мы планируем сделать в ближайшее время.

YT: зачем Яндексу своя MapReduce-система и как она устроена - 1

Кстати, 15 октября в офисе Яндекса мы расскажем не только о YT, но и о других наших инфраструктурных технологиях: Media Storage, Yandex Query Language и ClickHouse. На встрече мы раскроем тайну — расскажем, сколько же в Яндексе MapReduce-систем.

Какую задачу мы решаем?

По роду своей деятельности Яндекс постоянно сталкивается с необходимостью хранить и обрабатывать данные таких объемов, с которыми обычному пользователю никогда не приходится иметь дело. Поисковые логи и индексы, пользовательские данные, картографическая информация, промежуточные данные и результаты алгоритмов машинного обучения — все это может занимать сотни петабайт дискового пространства. Для эффективной обработки подобных объемов традиционно используется парадигма MapReduce, позволяющая достичь хорошего баланса между эффективностью вычислений и простотой пользовательского кода.

Читать полностью »

Публикуем обзор первых двух дней Data Science Week 2016, в которые наши спикеры говорили о взаимоотношениях с клиентом и внутренней оптимизации.

image
Читать полностью »

Spring Boot стартер для Apache Ignite своими руками - 1

Вот уже вышло две статьи в потенциально очень длинной серии обзоров распределённой платформы Apache Ignite (первая про настройку и запуск, вторая про построение топологии). Данная статья посвящена попытке подружить Apache Ignite и Spring Boot. Стандартным способом подключения некой библиотеки к Spring Boot является создание для этой технологии «стартера». Несмотря на то, что Spring Boot весьма популярен и на Хабре описывался не единожды, про то, как делать стартеры, вроде бы ещё не писали. Этот досадный пробел я постараюсь закрыть.

Статья посвящена преимущественно Spring Boot'у и Spring Core, так что те, кого тема Apache Ignite не интересует, всё равно могут узнать что-то новое. Код выложен на GitHub, стартера и демо-приложения.
Читать полностью »

ФРИИ, Ростелеком, Tele2, Акадо и МТТ запускают набор в акселератор по Big Data и AI для продуктов, которые можно использовать в телеком-индустрии. Стартап может получить до 300 млн рублей инвестиций, сообщили Roem.ru в фонде.

Выбранным стартапам операторы предоставят доступ к своим обезличенным данным — команды будут тестировать решения на реальных данных, Читать полностью »

Работа с топологией Apache Ignite - 1 В предыдущей статье я рассказал о том, как построить простейшую топологию для Apache Ignite. Она состояла из одного клиента и одного сервера, клиент слал на сервер сообщение и сервер его отображал. Было рассказано о том, как настроить продукт и проконтролировать его жизнедеятельность. Теперь пришло время для более сложного примера. Будет продемонстрировано построение сложной топологии и более интересные сценарии взаимодействия. Предполагается, что читатель ознакомился с базовыми операциями с Apache Ignite, изложенными в первой статье. В результате прочтения этих двух статей у читателя могут возникнуть какие-то предположения о том, как ему применить этот, без преувеличения, мощный продукт в своих проектах. Также статья будет полезна тем, кто интересуется построением высокопроизводительных систем, и хочет подсмотреть готовое решение для своего велосипеда.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js