Рубрика «big data» - 90

Исторически во многих уголках Яндекса разрабатывались свои системы хранения и обработки больших объемов данных — с учетом специфики конкретных проектов. При такой разработке в приоритете всегда была эффективность, масштабируемость и надежность, поэтому на удобные интерфейсы для использования подобных систем времени, как правило, не оставалось. Полтора года назад разработку крупных инфраструктурных компонентов выделили из продуктовых команд в отдельное направление. Цели были следующими: начать двигаться быстрее, уменьшить дублирование среди схожих систем и снизить порог входа новых внутренних пользователей.
Как писать меньше кода для MR, или Зачем миру ещё один язык запросов? История Yandex Query Language - 1

Очень скоро мы поняли, что тут мог бы здорово помочь общий высокоуровневый язык запросов, который бы предоставлял единообразный доступ к уже имеющимся системам, а также избавлял от необходимости заново реализовывать типовые абстракции на низкоуровневых примитивах, принятых в этих системах. Так началась разработка Yandex Query Language (YQL) — универсального декларативного языка запросов к системам хранения и обработки данных. (Сразу скажу, что мы знаем, что это уже не первая штука в мире, которая называется YQL, но мы решили, что это делу не мешает, и оставили название.)

В преддверии нашей встречи, которая будет посвящена инфраструктуре Яндекса, мы решили рассказать о YQL читателям Хабрахабра.
Читать полностью »

Функция синхронного перевода в Skype теперь поддерживает русский язык - 1

С последним обновлением Skype в него была добавлена функция синхронного перевода русского языка. Соответствующая новость была опубликована сегодня в официальном блоге Skype под заголовком «Привет! Skype Translator says Hello to Russian».

«Русский является восьмым по популярности языком в мире и наши русскоязычные пользователи всегда высказывали огромный энтузиазм по поводу функции Skype Translator. В течение нескольких месяцев мы получили множество запросов о включении русского языка в портфель языкового аудио сопровождения Skype Translator. Мы рады, наконец, пересечь этот рубеж, и заявляем о начале поддержки одного из самых сложных в диалектическом плане языков мира со стороны Skype», — говорится в официальном блоге Skype.
Читать полностью »

Сравнение аналитических in-memory баз данных - 1

В последние два месяца лета в управлении хранилищ данных (Data Warehouse, DWH) Тинькофф Банка появилась новая тема для кухонных споров.
Всё это время мы проводили масштабное тестирование нескольких in-memory СУБД. Любой разговор с администраторами DWH в это время можно было начать с фразы «Ну как, кто лидирует?», и не прогадать. В ответ люди получали длинную и очень эмоциональную тираду о сложностях тестирования, премудростях общения с доселе неизвестными вендорами и недостатках отдельных испытуемых.
Подробности, результаты и некое подобие выводов из тестирования — под катом.
Читать полностью »

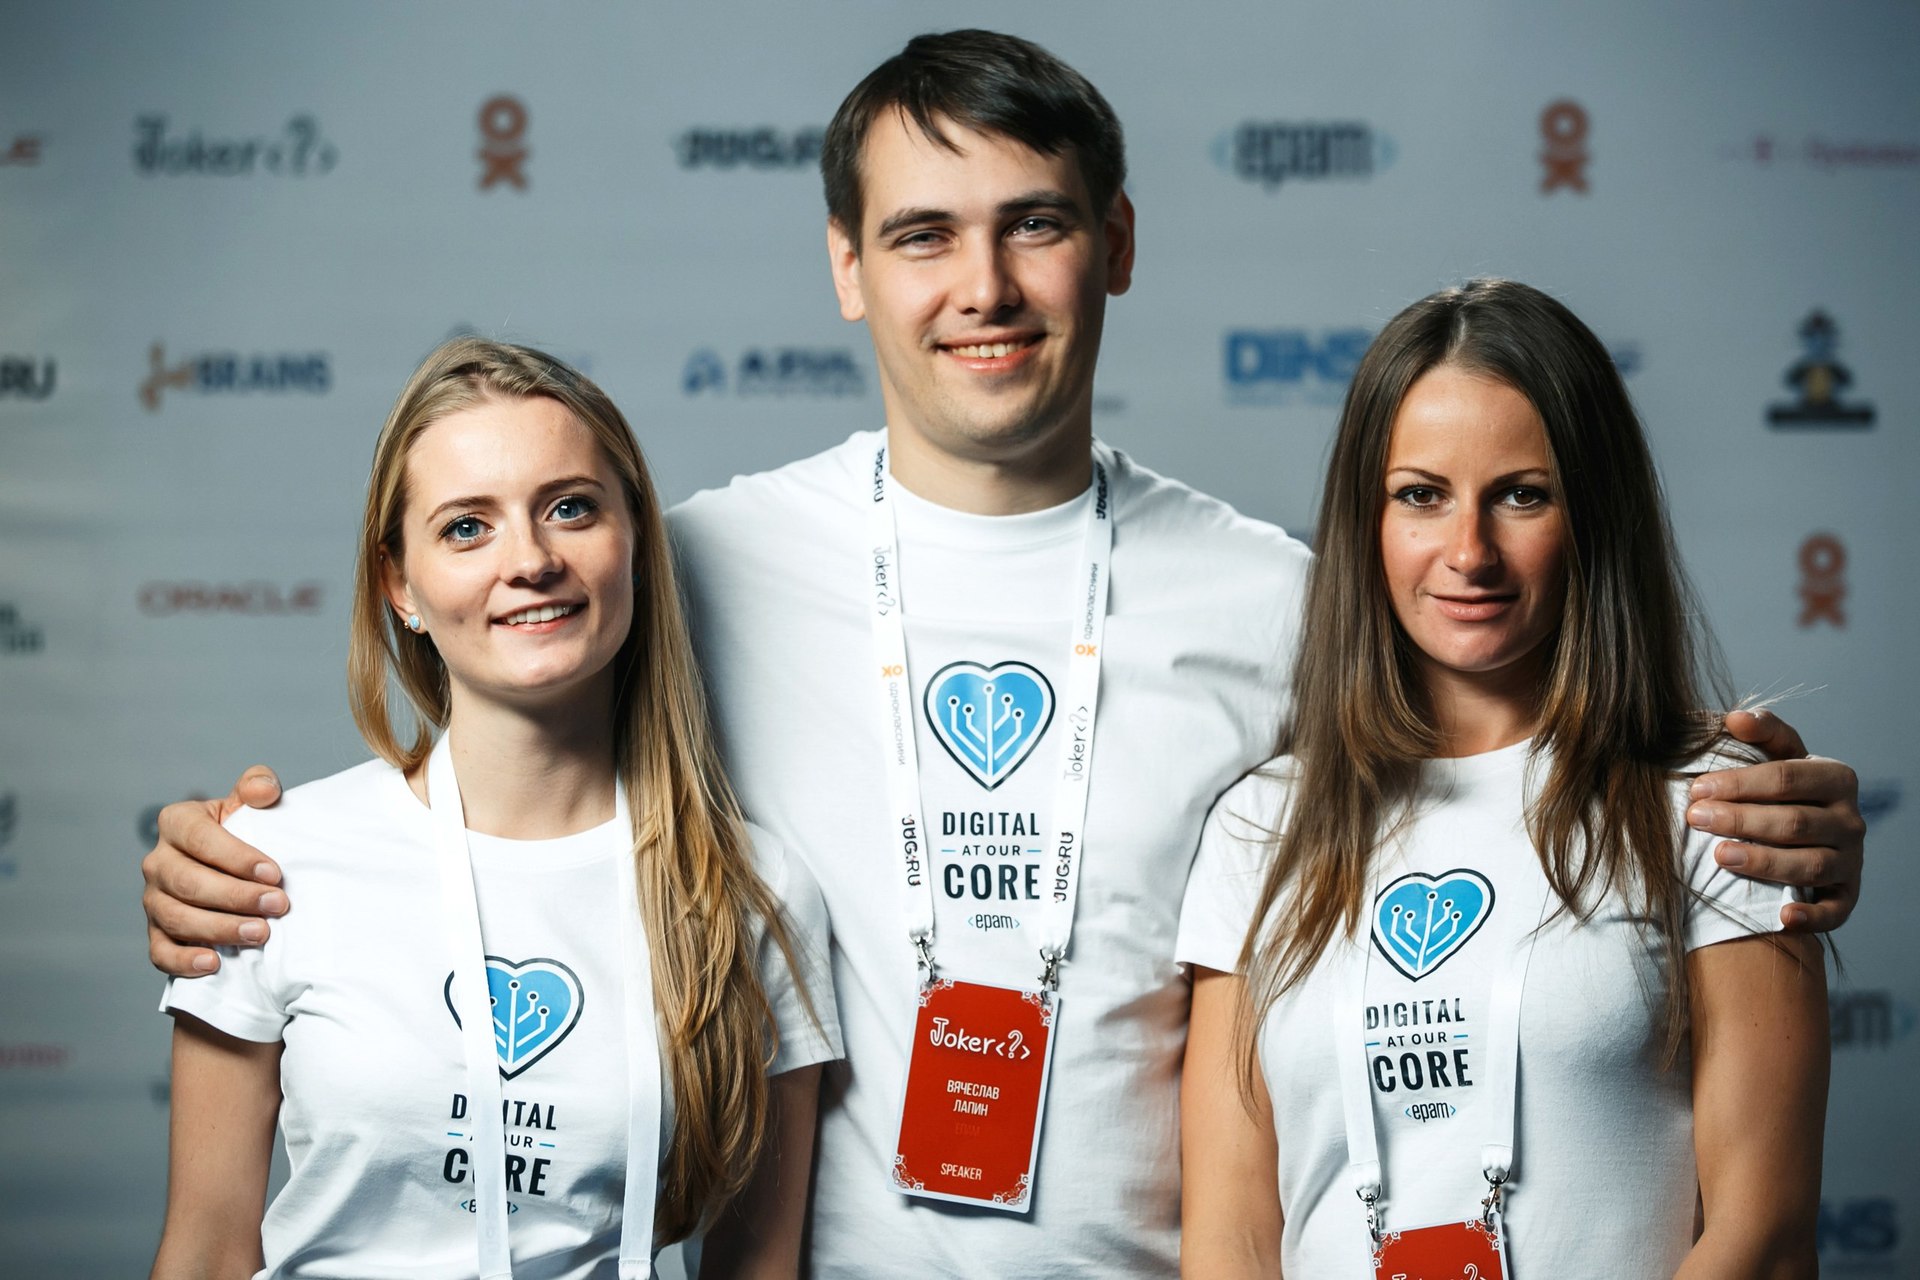
«Обучаем специалистов всех уровней»: EPAM о Java-разработке и конференциях - 1

Название EPAM известно практически всем. Но не все знают о том, что компания среди прочего занимается биоинформатикой, что в ней ценят full-stack разработчиков, а её внутренняя система обучения/переквалификации рассчитана не только на джуниоров, и в качестве менторов там порой выступают архитекторы.

В преддверии конференции Joker, на которой EPAM будет активно присутствовать, мы задали сотрудникам компании вопросы о Java-разработке и всём, что вокруг неё. Нашими собеседниками стали:

  • Марианна Округина, директор офиса в Санкт-Петербурге
  • Алексей Зиновьев, тренер по Java/Big Data (спикер Joker 2016 и не только)
  • Вячеслав Лапин, senior developer (спикер Joker 2015 и не только)
  • Полина Панюкова, специалист по маркетингу

Читать полностью »

Когда старый MapReduce лучше нового Tez - 1

Как всем известно, количество данных в мире растёт, собирать и обрабатывать поток информации становится всё сложнее. Для этого служит популярное решение Hadoop c идеей упрощения методов разработки и отладки многопоточных приложений, использующее парадигму MapReduce. Эта парадигма не всегда удачно справляется со своими задачами, и через некоторое время появляется «надстройка» над Hadoop: Apache Tez с парадигмой DAG. Под появление Tez подстраивается и HDFS-SQL-обработчик Hive. Но не всегда новое лучше старого. В большинстве случаев HiveOnTez значительно быстрее HiveOnMapReduce, но некоторые подводные камни могут сильно повлиять на производительность вашего решения. Здесь я хочу рассказать, с какими нюансами столкнулся. Надеюсь, это поможет вам ускорить ETL или другой Hadoop UseCase.
Читать полностью »

Привет! Последнее время все больше и больше достижений в области искусственного интеллекта связано с инструментами глубокого обучения или deep learning. Мы решили разобраться, где же можно научиться необходимым навыкам, чтобы стать специалистом в этой области.

image
Читать полностью »

Take it like a man by John PollakВ предыдущей части серии мы (в 100500й раз) попытались рассказать про основные приемы и стадии подхода Google MapReduce, должен признаться, что первая часть была намерено "капитанской", чтобы дать знать о MapReduce целевой аудитории последующих статей. Мы не успели показать ни строчки того, как всё это мы собираемся реализовывать в Caché ObjectScript. И про это наша рассказ сегодня (и в последующие дни).

Напомним первоначальный посыл нашего мини-проекта: вы всё еще планируем реализовать MapReduce алгоритм используя те подручные средства, что есть в Caché ObjectScript. При создании интерфейсов, мы попытаемся придерживаться того API, что мы описали в предыдущей статье про оригинальную реализацию Google MapReduce, любые девиации будут озвучены соответствующе.

Читать полностью »

Настоящий пост является является, фактически, резюме, подводящим итоги предыдущих «технологических» публикаций [1, 2, 3, 4, 5] и возникших дискуссий и обсуждений. Последние показали, что задач в которых применение R могло бы оказать хорошую помощь бизнесу очень и очень много. Однако, даже в тех случаях, когда R используется, далеко не всегда для этого применяются современные возможности R.Читать полностью »

Cтартап по обработке и хранению больших данных Nutanix продемонстрировал рост акций на 131% в первый день размещения. И это при том, что эксперты Financial Times говорят, что рынок для IPO сейчас худший с 2009 года.

Результаты компании, опубликованные незадолго до IPO, можно назвать неплохими, но вряд ли они были причиной такого впечатляющего роста. За двенадцатимесячный отчетный период,Читать полностью »

Что такое большие данные, часть 3 - 1

В первой части мы узнали о данных, и о том, как они могут быть использованы для извлечения из них метаданных или каких-то значений.

Вторая часть объяснила сам термин Big Data и показала, как он превратился в индустрию, причиной появления для которой стало влияние экономики. Эта, третья часть, в которой должно быть логическое продолжение предыдущих двух и у всего этого должен появиться смысл — грустная, местами ироничная, а местами пугающая. Вы видите сами, как технологические, бизнес, и даже социальные контракты в перспективе уже переопределялись большими данными таким путём, который мы только сейчас начинаем понимать. И, возможно, они никогда уже не станут контролируемыми.

С помощью чего бы не проводился анализ — суперкомпьютера или составленной вручную в 1665 году таблицы из списков мёртвых, некоторые аспекты больших данных существовали гораздо дольше, чем мы можем представить.

Темная сторона больших данных. Исторически роль больших данных не всегда была кристально чистотой. Идея переработки цифр, приводящей к количественной рационализации для чего-то, что мы и так хотели сделать, существует с тех пор, как у нас появились лишние деньги.Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js