Рубрика «data mining» - 43

План статьи

  1. Постановка задачи.
  2. Формальное описание задачи.
  3. Примеры задач.
  4. Несколько примеров на синтетических данных со скрытыми линейными зависимостями.
  5. Какие ещё скрытые зависимости могут содержаться в данных.
  6. Автоматизация поиска зависимостей.

  • Число признаков меньше пороговой величины.
  • Число признаков превышает пороговую величину.

Постановка задачи

Нередко в машинном обучении встречаются ситуации, когда данные собираются априори, и лишь затем возникает необходимость разделить некоторую выборку по известным классам. Как следствие часто может возникнуть ситуация, когда имеющийся набор признаков плохо подходит для эффективной классификации. По крайней мере, при первом приближении.

В такой ситуации можно строить композиции слабо работающих по отдельности методов, а можно начать с обогащения данных путём выявления скрытых зависимостей между признаками. И затем строить на основе найденных зависимостей новые наборы признаков, некоторые из которых могут потенциально дать существенный прирост качества классификации.

Формальное описание задачи

Перед нами ставится задача классификации L объектов, заданных n вещественными числами. Мы будем рассматривать простой двухклассовый случай, когда метки классов — это −1 и +1. Наша цель — построить линейный классификатор, то есть такую функцию, которая возвращает −1 или + 1. При этом набор признаковых описаний таков, что для объектов противоположных классов, измеренных на данном множестве признаков, практически не работает гипотеза компактности, а разделяющая гиперплоскость строится крайне неэффективно.

Иными словами, всё выглядит так, будто задача классификации на данном множестве объектов не может быть решена эффективно.
Читать полностью »
Принято считать, что информационные технологии в государственных ведомствах приживаются тяжелее, и для этого мнения есть ряд объективных причин. Однако, как говорил Альф: «Вы не любите котов? Значит, вы не умеете их готовить!». И сегодня мы хотим поговорить о том, как отличаются проекты в госкомпаниях с точки зрения бизнес-IT интегратора, и для каких целей госы создают большие хранилища для аналитических проектов.

Исторически государственные ведомства отличаются большей инертностью, потому что в них принято дольше согласовывать каждый шаг, потому что точка принятия решения в них размыта, потому что заказчик может многократно менять задание, уточняя, что же ему необходимо в действительности. Сами чиновники в своем большинстве воспринимают ИТ-проекты без лишнего энтузиазма. В госструктурах обычно нет какого-то сильного сопротивления новому, но и стремления к нему тоже нет, в частности, оказывается непросто найти заинтересованный в результатах «локомотив» внедрения новых решений. В итоге внедрение идет медленнее, и со стороны начинает казаться, что заказчику вообще не нужен тот или иной проект.

Аналитика в госсекторе: особенности больших систем хранения данных - 1 Читать полностью »

В этой статье пойдет речь о том, как строятся персональные рекомендации на Avito. Исторически бизнес-модель Avito устроена так, что выдача объявлений в поиске происходит по времени их размещения. При этом пользователь может покупать дополнительные услуги для того, чтобы поднять свое объявление в поиске в том случае, если со временем объявление опустилось далеко в поисковой выдаче и перестало набирать просмотры и контакты.

В контексте данной бизнес-модели не очевидно, зачем нужны персональные рекомендации. Ведь они как раз нарушают логику сортировки по времени и те пользователи, которые платят за поднятие объявления, могут обидеться за то, что чье-то другое объявление мы «поднимаем» и показываем пользователю совершенно бесплатно только потому, что наша рекомендательная модель посчитала это объявление более релевантным для какого-то пользователя.

Однако сейчас персональные рекомендации становятся “must have” для классифайдов (и не только) по всему миру. Мы хотим помогать пользователю в поиске того, что ему нужно. Уже сейчас всё более значительная доля просмотров объявлений на Avito производится с рекомендаций на главной странице приложений или рекомендаций похожих объявлений на карточке товара. В этом посте я расскажу, какие именно задачи решает наша команда в Avito.

Рекомендации на Avito - 1

Читать полностью »

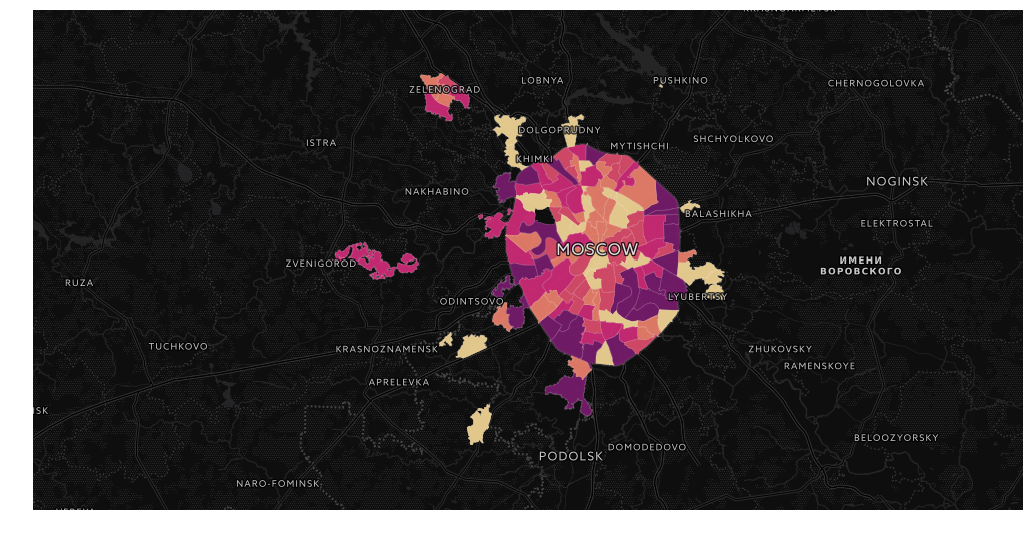
Визуализация результатов выборов в Москве на карте в Jupyter Notebook - 1
Всем привет!

Сегодня мы поговорим о визуализации геоданных. Имея на руках статистику, явно имеющую пространственную привязку, всегда хочется сделать красивую карту. Желательно, с навигацией да инфоокнами В тетрадках. И, конечно же, чтоб потом можно было показать всему интернету свои успехи в визуализации!

В качестве примера возьмем недавно отгремевшие муниципальные выборы в Москве. Сами данные можно взять с сайта мосгоризбиркома, в можно просто забрать датасеты с https://gudkov.ru/. Там даже есть какая-никакая визуализация, но мы пойдем глубже. Итак, что же у нас в итоге должно получиться?

Читать полностью »

Сбор данных из различных источников, преобразование с целью унифицирования либо удобства довольно распространенная задача. Конечно, в большинстве случаев можно обойтись собственным решением, но чтобы оно было гибким и легко расширяемым придется потратить немало времени. В таком случае разумным будет воспользоваться готовым решением. Talend Open Studio (TOS) одно из таких решений.

Меня несколько удивило отсутствие статей про работу с TOS на Хабре. Возможно, тому есть причины, мне непонятные. Как бы то ни было, постараюсь восполнить этот пробел.

Вероятно, при написании этой статьи я был излишне подробен в некоторых вопросах, поэтому некоторые инструкции я спрятал под спойлер.
Читать полностью »

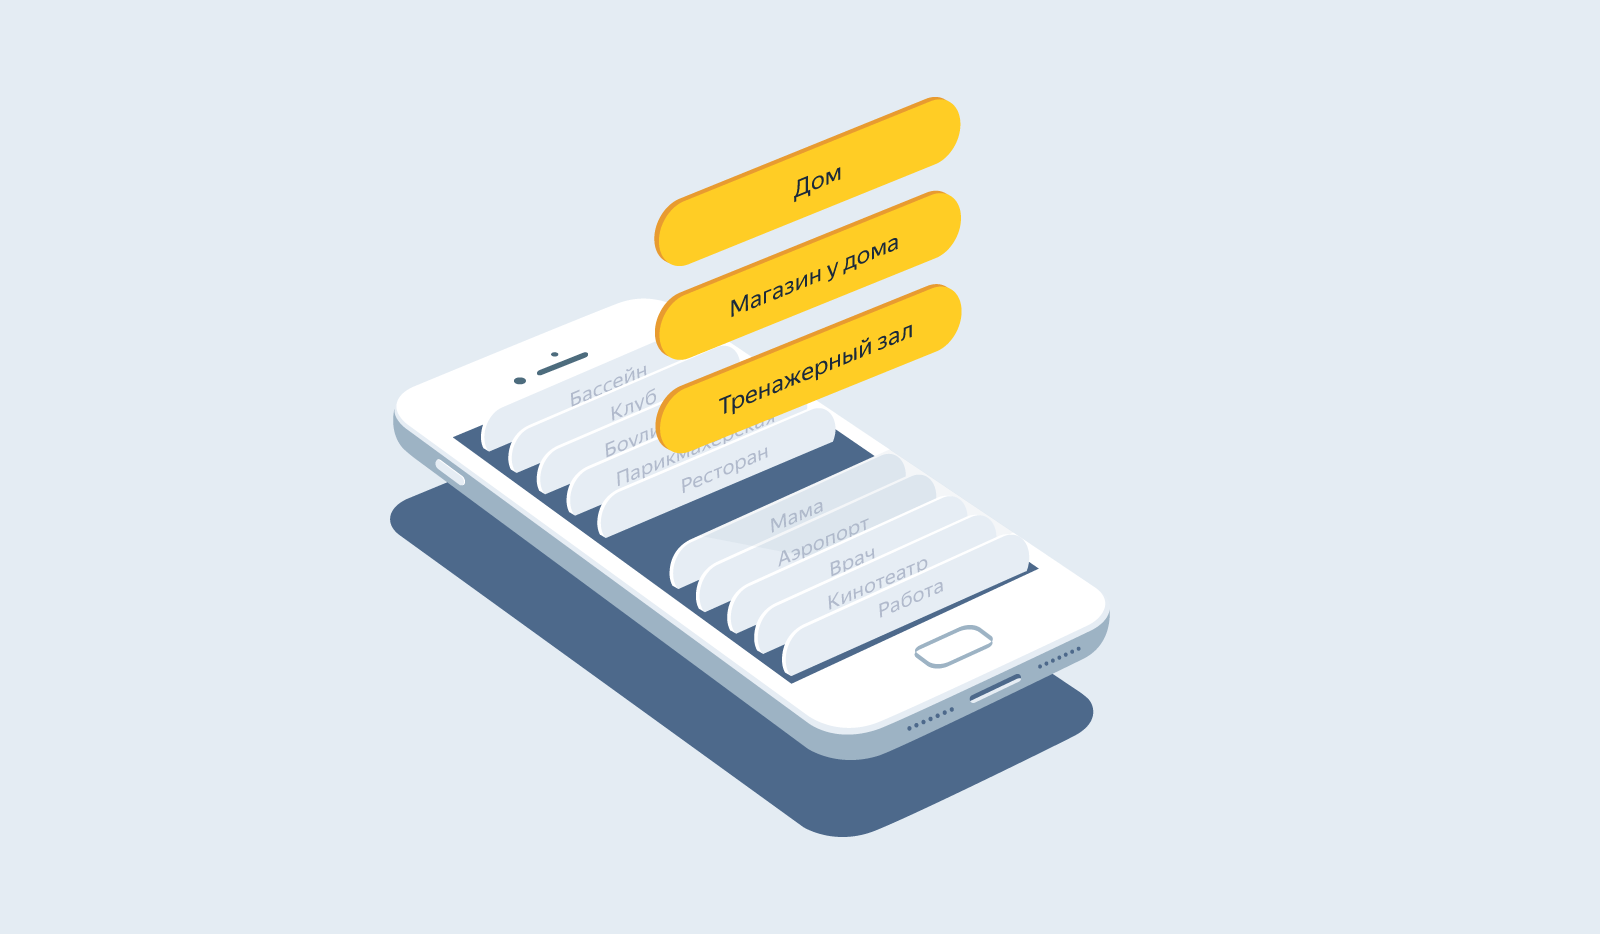
Представьте: вы открываете приложение, чтобы в очередной раз заказать такси в часто посещаемое вами место, и, конечно, в 2017 году вы ожидаете, что все, что нужно сделать – сказать приложению «Вызывай», и такси за вами тут же выедет. А куда вы хотели ехать, через сколько минут и на какой машине — все это приложение узнает благодаря истории заказов и машинному обучению. В общем-то все, как в шутках про идеальный интерфейс с единственной кнопкой «сделать хорошо», лучше которого только экран с надписью «все уже хорошо». Звучит здорово, но как же приблизить эту реальность?

Как мы обучали приложение Яндекс.Такси предсказывать пункт назначения - 1

На днях мы выпустили новое приложение Яндекс.Такси для iOS. В обновленном интерфейсе один из акцентов сделан на выборе конечной точки маршрута («точки Б»). Но новая версия – это не просто новый UI. К запуску обновления мы существенно переработали технологию прогнозирования пункта назначения, заменив старые эвристики на обученный на исторических данных классификатор.

Как вы понимаете, кнопки «сделать хорошо» в машинном обучении тоже нет, поэтому простая на первый взгляд задача вылилась в довольно захватывающий кейс, в результате которого, мы надеемся, у нас получилось немного облегчить жизнь пользователей. Сейчас мы продолжаем внимательно следить за работой нового алгоритма и еще будем его менять, чтобы качество прогноза было стабильнее. Эта же технология очень скоро будет работать и в приложении для Android, хотя обновление его интерфейса произойдет немного позже. На полную мощность мы запустимся в ближайшие несколько недель, но под катом уже готовы рассказать о том, что же происходит внутри.

Читать полностью »

«Сила машинного обучения окружает нас, методы её окружают нас и связывают. Сила вокруг меня, везде, между мной, тобой, решающим деревом, лассо, гребнем и вектором опорным»

Так бы, наверное, мне сказал Йода если бы он учил меня пути Data Science.

К сожалению, пока среди моих знакомых зеленокожие морщинистые личности не наблюдаются, поэтому просто продолжим вместе с вами наш совместный путь обучения науке о данных от уровня абсолютного новика до … настоящего джедая того, что в итоге получиться.

В прошлых двух статьях мы решали задачу классификации источников света по их спектру (на Python и C# соответственно). В этот раз попробуем решить задачу классификации светильников по их кривой силе света (по тому пятну которым они светят на пол).

Если вы уже постигли путь силы, то можно сразу скачать dataset на Github и поиграться с этой задачей самостоятельно. А вот всех, как и я новичков прошу подкат.

Благо задачка в этот раз совсем несложная и много времени не займет.
«Используй Силу машинного обучения, Люк!» или автоматическая классификация светильников по КСС - 1
Читать полностью »

В интернете много информации, что data sciencist должен знать и уметь. Но я решил, что становиться data sciencist надо сразу, поэтому мы выясним требования к специалистам при помощи анализа текста вакансий.

Анализируем требования рынка для data scientist - 1

В первую очередь сформулируем задачу и разработаем план:
Задача:
Посмотреть все вакансии на рынке и узнать общие требования, указанные в них.
Читать полностью »

Привет! На данный момент в Data Science образовался огромный перекос в сторону data scientist-ов, об этой профессии сейчас знают даже те, кто никак не связан с IT, а новые вакансии появляются ежедневно. В свою очередь data engineer-ы не получают того внимания, которое бы соответствовало их важности для компании, поэтому в сегодняшнем посте мы бы хотели исправить эту несправедливость и объяснить, почему разработчикам и администраторам стоит немедленно начинать изучать Kafka и Spark и строить свой первый пайплайн.

4 причины стать Data Engineer - 1

В скором времени ни одна компания не сможет обойтись без Data Engineer

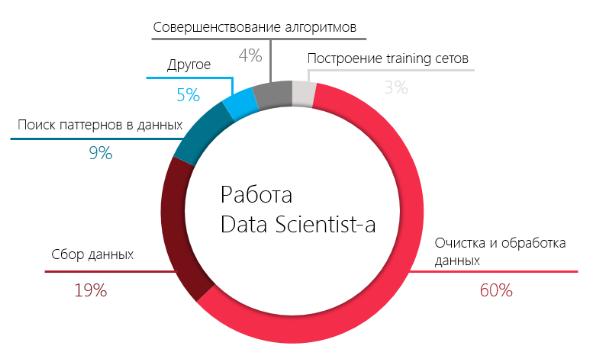
Давайте рассмотрим типичный рабочий день data scientist-а:
4 причины стать Data Engineer - 2
Получается, что около 80% своего времени data scientist тратит на сбор данных, их предобработку и очистку — процессы, которые напрямую не связаны с главной его обязанностью: поиском инсайтов и паттернов в данных. Конечно, подготовка данных требует высшего уровня мастерства, но это не data science, это не то, зачем тысячи людей сегодня стремятся попасть в эту отрасль.Читать полностью »

К нам обратился крупный российский перевозчик, владеющий внушительным автопарком. Его клиентами являются десятки логистических компаний и предприятий. Зона его деятельности простирается далеко за пределы стран СНГ. Каждый автомобиль оснащен системой мониторинга, оправляющей в диспетчерский центр данные о координатах, расходе топлива и множестве других показателей.

Из единого центра информация о координатах груза расходится к заказчикам. Все работает в автоматизированном режиме. Для удобства контроля доставки, в стоимость услуг включен сервис по информированию клиентов о местонахождении их грузов.

Расследование утечек информации из корпоративной базы данных перевозчика - 1

Причиной обращения к нам стала деятельность нескольких интернет-ресурсов, которые продавали информацию о грузах перевозчика. Едва ли логистическая компания или другой клиент нашего перевозчика будет рад узнать, что данные о его грузах может приобрести кто угодно, в том числе и конкуренты.
Читать полностью »


https://ajax.googleapis.com/ajax/libs/jquery/3.4.1/jquery.min.js